O que vamos chamar de "melhorou"?
Uma loss de treinamento em queda não significa que as partidas reais melhoraram. Uma IA de go precisa ler coordenadas, fazer jogadas legais, não passar no meio de uma luta e não preencher os próprios olhos sem necessidade. Antes de trocar o modelo, é preciso medir esses itens no mesmo conjunto de avaliação.
Etapa 1: Separar os itens de avaliação
O teste de coordenadas mede se a posição das pedras é lida corretamente. O teste de regras conta a proporção de jogadas ilegais produzidas pelo modelo. O teste de partidas joga contra um adversário fixo trocando as cores e registra as capturas, o momento dos passes e o motivo do fim da partida. Se falhas diferentes forem juntadas em uma única taxa de vitórias, não dá para saber o que corrigir.
- Precisão de coordenadas nos quatro quadrantes
- Taxa de jogadas ilegais na primeira resposta e nas novas requisições
- Número de passes precoces antes da jogada 80
- Viés de direção que escolhe repetidamente a mesma coluna ou o mesmo canto
- Capturas e resultado final das partidas com as cores trocadas
Etapa 2: Guardar os resultados do modelo de referência
Não rode só o modelo novo; guarde os resultados do modelo atualmente em produção no mesmo formato JSON. Anote a versão dos dados de avaliação, o nome do modelo, o prompt e o commit do motor de regras, para que os números possam ser reproduzidos depois. Se houver aleatoriedade, fixe também a seed e as configurações de geração.
Etapa 3: Indicar os limites das partidas curtas
Uma contagem provisória feita ao interromper a partida na jogada 80 é útil como verificação rápida de regressão, mas não pode ser interpretada como taxa de vitórias oficial ou nível. Isso porque a vida e morte dos grupos e o fim de jogo ainda estão em aberto. Nas avaliações curtas, observam-se jogadas ilegais, passes precoces e perdas táticas óbvias; a comparação de força de jogo é feita separadamente, juntando partidas completas em quantidade suficiente.
Etapa 4: Transformar os casos de falha nos próximos dados
As falhas que se repetem na avaliação são salvas junto com o estado do tabuleiro, a resposta original do modelo e o motivo da recusa. Erros de coordenada vão para os testes de entrada, fugas inúteis de escada vão para os exemplos táticos e passes precoces vão para os exemplos de partidas em andamento. Não jogue todas as falhas no treinamento sem critério; separe os problemas que o código de regras pode bloquear com certeza daqueles que o modelo precisa aprender.
Uma boa planilha de avaliação não é uma nota para elogiar o modelo, e sim um mapa que mostra onde corrigir em seguida.
Registros reais
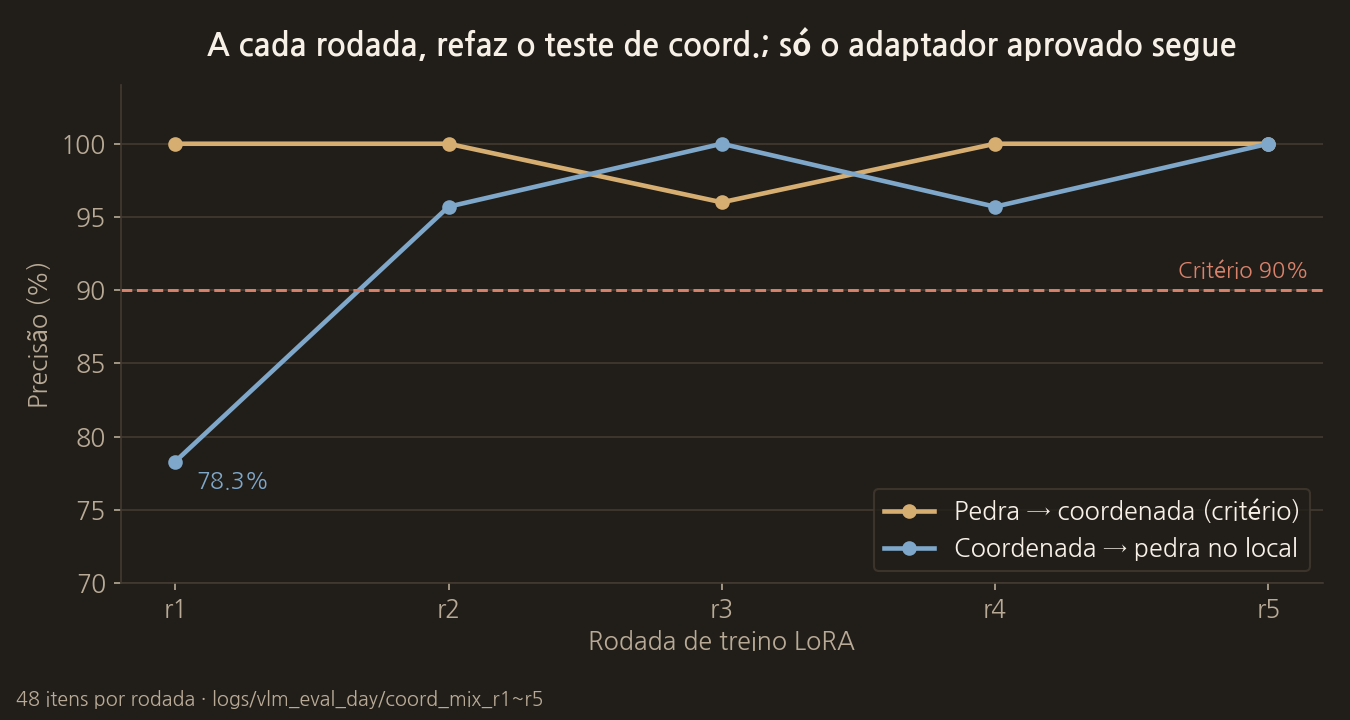
Ao treinar o LoRA em cinco rodadas, refizemos o mesmo teste de coordenadas a cada rodada. Na r1, ler a posição de uma pedra como coordenada dava 100%, mas responder qual pedra está em uma coordenada dada dava 78,3%. Olhando um único item, essa diferença teria passado despercebida.
O código real desta etapa
Este código agrega os resultados do teste de coordenadas em quatro áreas: superior esquerda (TL), superior direita (TR), inferior esquerda (BL) e inferior direita (BR). Ele guarda a precisão por área junto com a precisão geral, para que o viés de direção fique visível imediatamente.
vlm_server/verify_coords.py
def _quadrant(r: int, c: int) -> str:
    if r < 9.5 and c < 9.5:
        return "TL"
    if r < 9.5 and c >= 9.5:
        return "TR"
    if r >= 9.5 and c < 9.5:
        return "BL"
    return "BR"
vlm_server/verify_coords.py
def summarize(results: List[TrialResult]) -> Dict[str, Any]:
    by_kind = Counter()
    ok_kind = Counter()
    by_q = Counter()
    ok_q = Counter()
    for r in results:
        by_kind[r.kind] += 1
        by_q[r.quadrant] += 1
        if r.ok:
            ok_kind[r.kind] += 1
            ok_q[r.quadrant] += 1
    total = len(results) or 1
    return {
        "n": len(results),
        "accuracy": round(100.0 * sum(1 for r in results if r.ok) / total, 1),
        "by_kind": {
            k: {
                "n": by_kind[k],
                "ok": ok_kind[k],
                "acc": round(100.0 * ok_kind[k] / max(1, by_kind[k]), 1),
            }
            for k in sorted(by_kind)
        },
        "by_quadrant": {
            q: {
                "n": by_q[q],
                "ok": ok_q[q],
                "acc": round(100.0 * ok_q[q] / max(1, by_q[q]), 1),
            }
            for q in ("TL", "TR", "BL", "BR")
        },
        "avg_ms": round(sum(r.ms for r in results) / total, 1),
    }
Modelo usado: Qwen3-VL-8B-Instruct + adaptador LoRA (lora_mix_qwen_r5). O código-fonte completo e a descrição do modelo estão no post "8. O código-fonte completo e os modelos usados".
COMMENTS · CHAPTER 05
Fixando o conjunto de avaliação antes do treinamento 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google