Como medimos
- Analisamos o formato das grades e as frases das pistas das 32 grades que restam no banco de registros de partidas.
- Alteramos uma cópia do código-fonte para registrar apenas por qual caminho cada grade saiu e criamos 30 grades por dificuldade.
- Rodamos o processo de grade nova 3 vezes por dificuldade com o gemma4 no mesmo Mac do serviço real. Para o projeto da grade, tiramos o limite de tempo e coletamos mais 6 respostas.
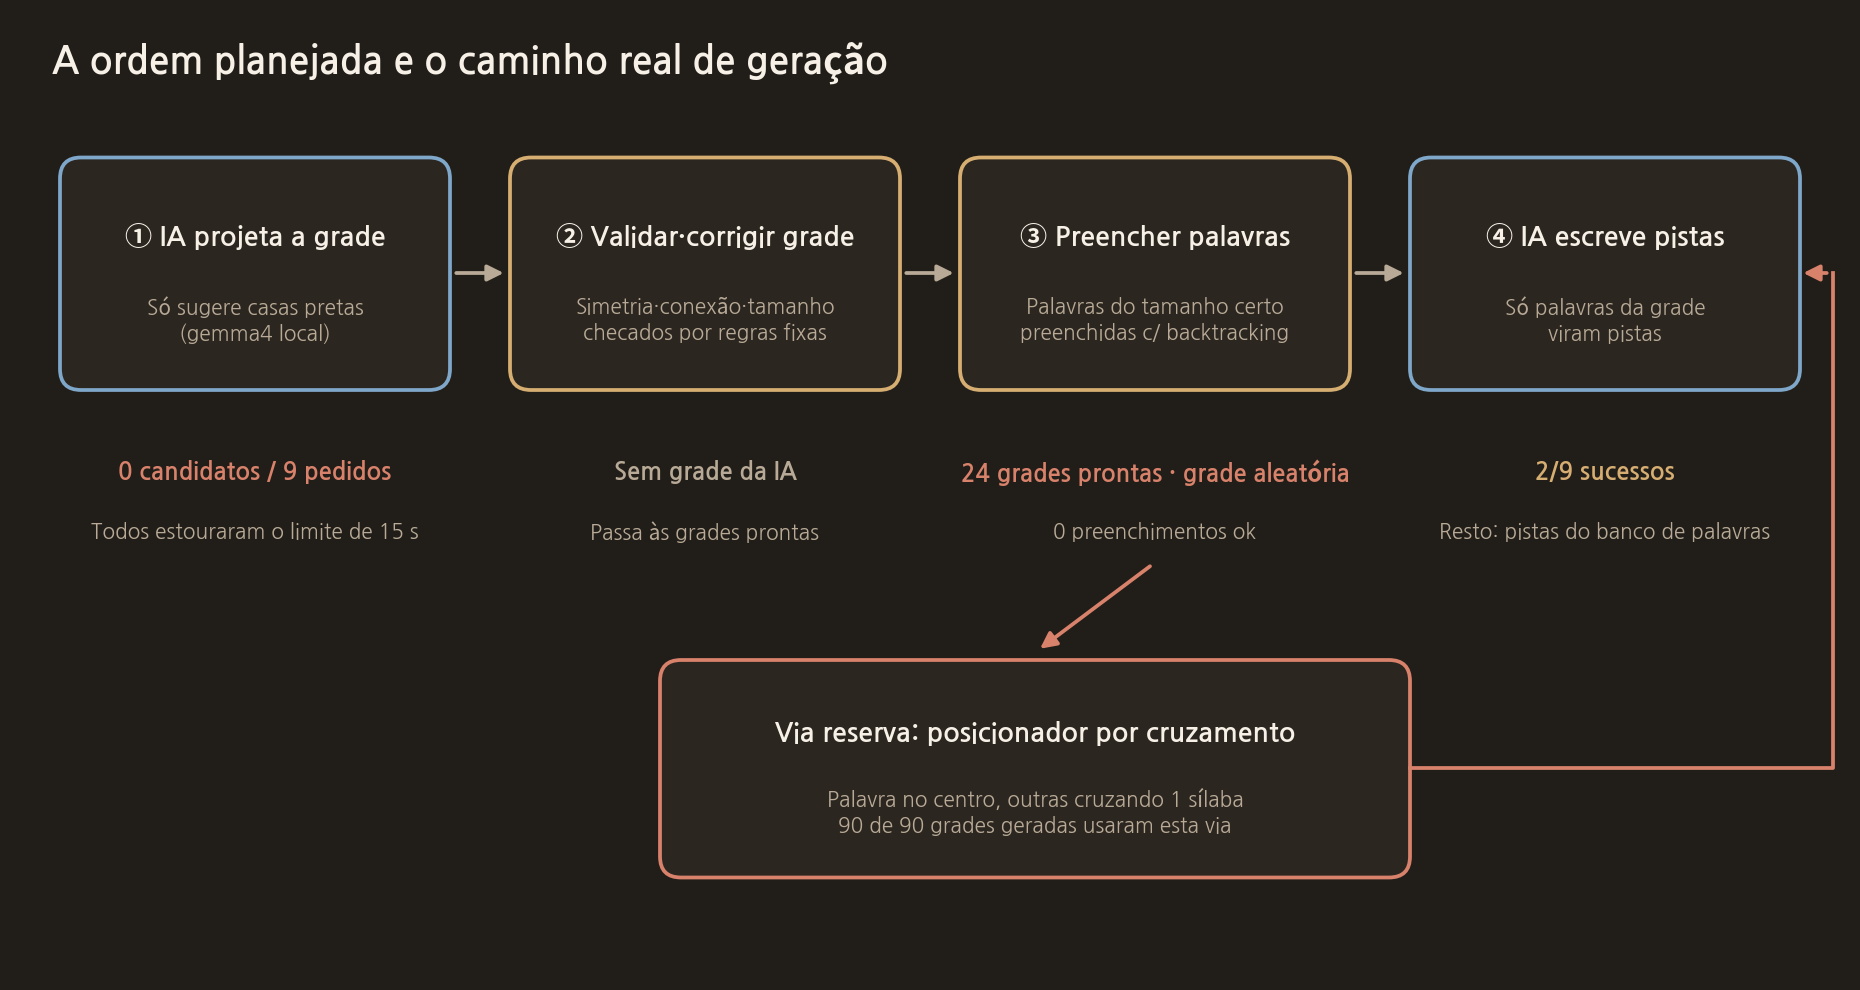
O caminho da grade primeiro nunca teve sucesso
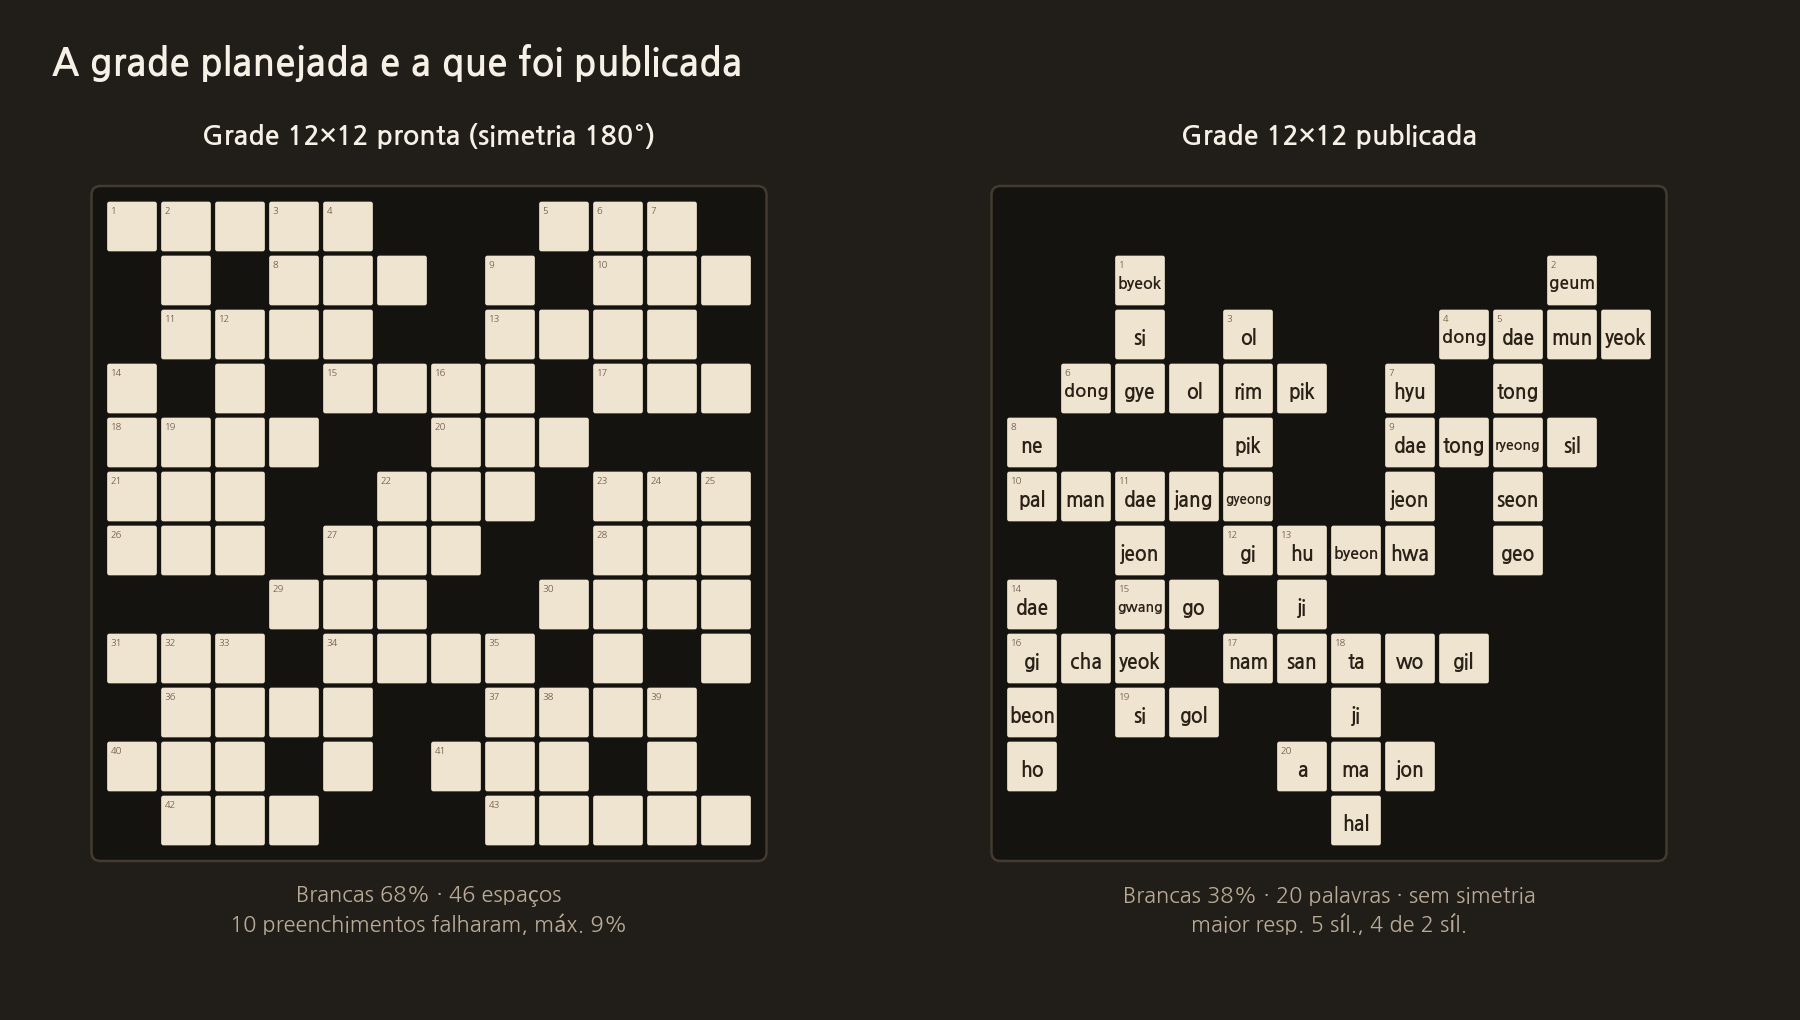
Todas as 90 grades criadas vieram do caminho reserva. É o posicionador que encaixa palavras, visto no post 1. Ele coloca uma palavra no meio e vai encaixando outras por uma sílaba em comum de cada vez, então as grades não são simétricas e um dos lados tende a ficar vazio.
- Grades com simetria de 180°: 0 de 90
- 18 das 60 grades médias e difíceis tinham respostas de 6 sílabas ou mais. No caminho da grade primeiro, as respostas não podem passar de 5 sílabas.
- Número médio de palavras: fácil 10,7, médio 14,9, difícil 19,9
- Tempo mediano de criação: fácil 0,6 s, médio 1,9 s, difícil 6,6 s. No difícil, uma em cada dez grades passou de 22,9 s.
As grades realmente salvas são iguais. Das 8 grades salvas depois da mudança para a grade primeiro, 0 eram simétricas, e 5 tinham respostas de 6 a 8 sílabas.
Há um motivo para ninguém ter percebido. A verificação que decide se uma grade atende aos critérios só olha a proporção de casas brancas, o número de pistas horizontais e verticais, o número de cruzamentos no meio e a conectividade. As grades do caminho reserva também atendem a esses critérios, então 89 das 90 grades "passaram".
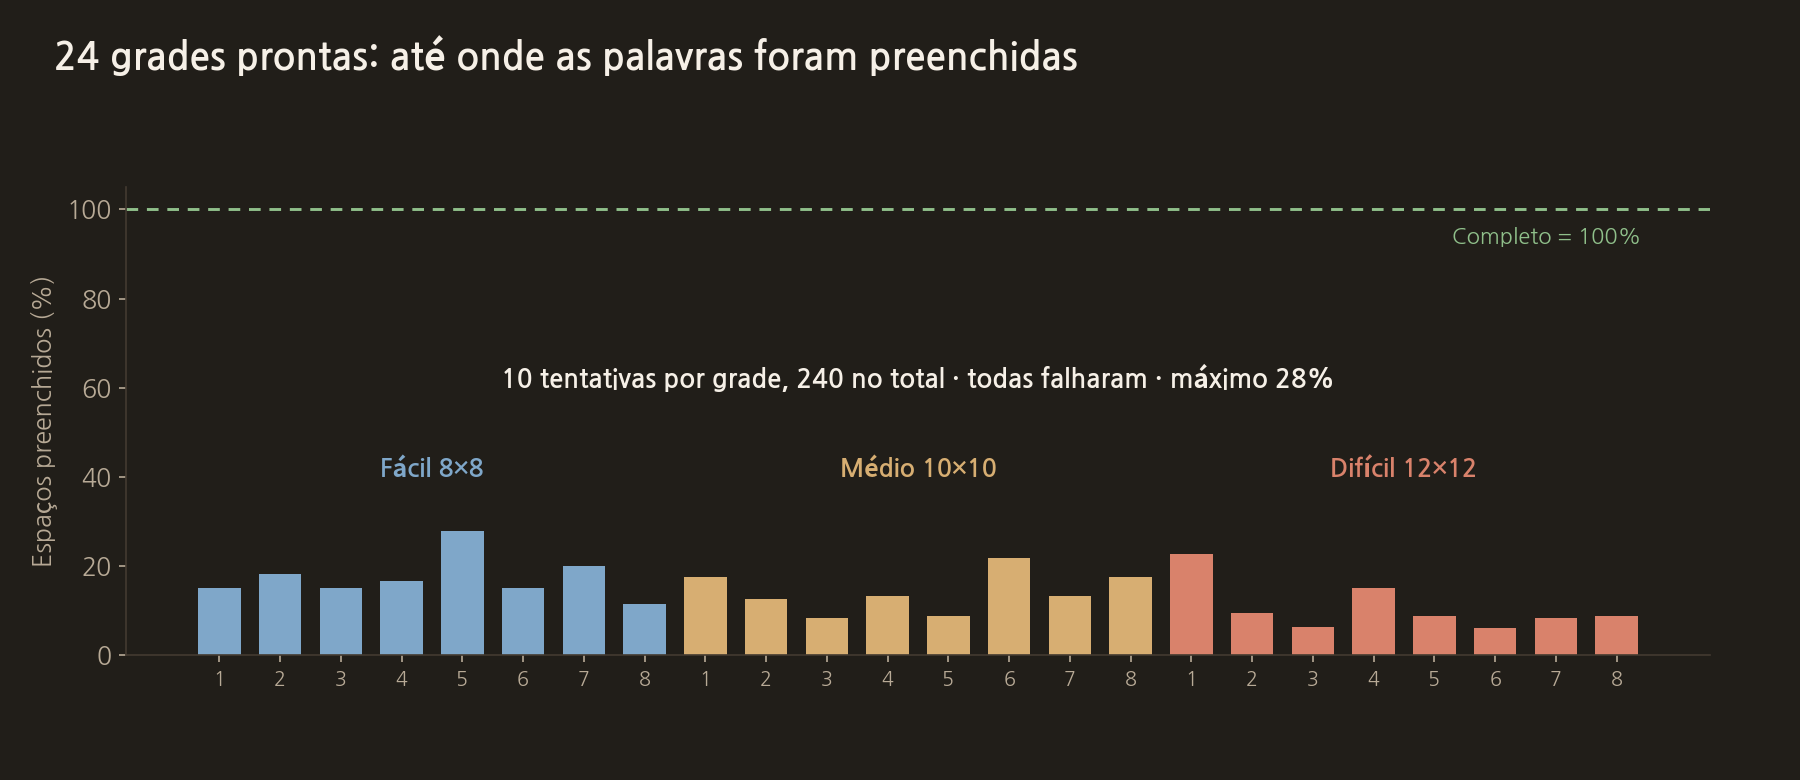
Tentamos preencher palavras 10 vezes em cada uma das 24 grades desenhadas de antemão. As 240 tentativas falharam, e mesmo a melhor preencheu só 28% das sequências de palavras. A média foi 14%. Rodando mais 20 vezes por grade com outras seeds, também nunca deu certo. As grades aleatórias foram 0 de 120 também. Das 24 grades desenhadas de antemão, dois pares eram a mesma grade (médio 4 e 7, difícil 5 e 8).
Por que não preenche: as sílabas do coreano
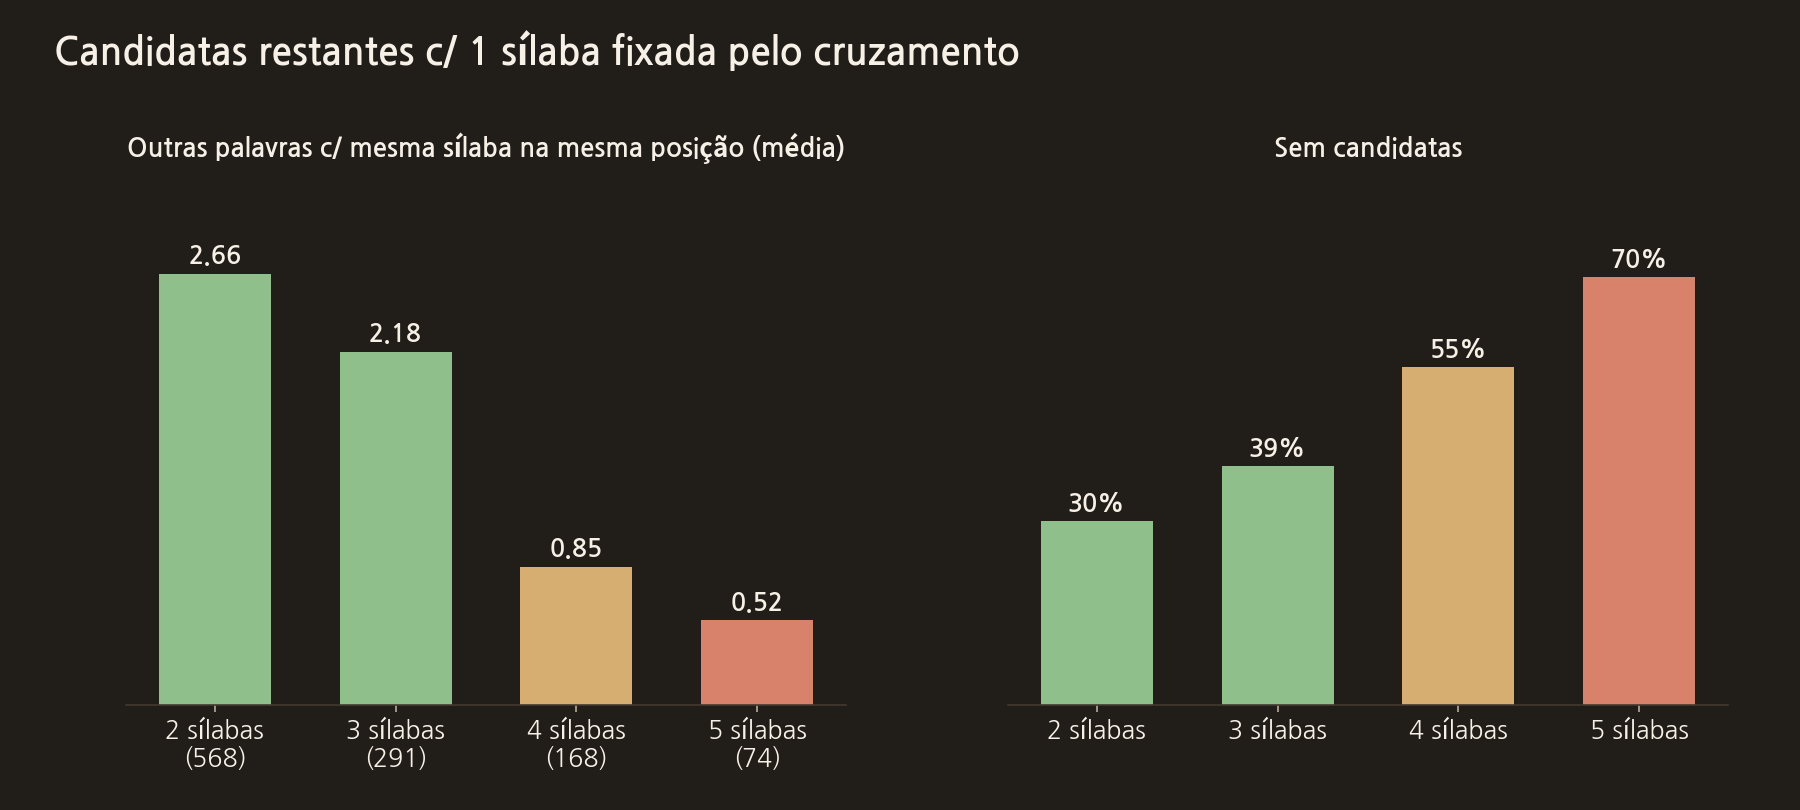
As palavras cruzadas em inglês se cruzam pelas 26 letras do alfabeto. Nas palavras cruzadas em coreano, uma sílaba ocupa uma casa, então há muito mais tipos de caracteres. Só as sílabas que aparecem no banco de palavras são 545 tipos, e 178 delas aparecem uma única vez.
Por isso, quando um cruzamento fixa uma casa, quase não sobram candidatos. Quando uma sílaba de uma sequência de 5 sílabas está fixada, há em média 0,52 outra palavra de 5 sílabas com a mesma sílaba naquela posição, e em 70% dos casos não há nenhuma. Para 4 sílabas, a média é 0,85, com 55% sem nenhuma.
As grades desenhadas de antemão têm de 64% a 75% de casas brancas, e a maioria das casas brancas pertence ao mesmo tempo a uma palavra horizontal e a uma vertical. Depois de colocar algumas palavras, uma das casas de cruzamento inevitavelmente fica com zero candidatos. As grades que de fato foram ao ar têm 36,4% de casas brancas, e só de 30% a 37% das casas são compartilhadas entre horizontal e vertical.
Projeto de grade pela IA: 0/9
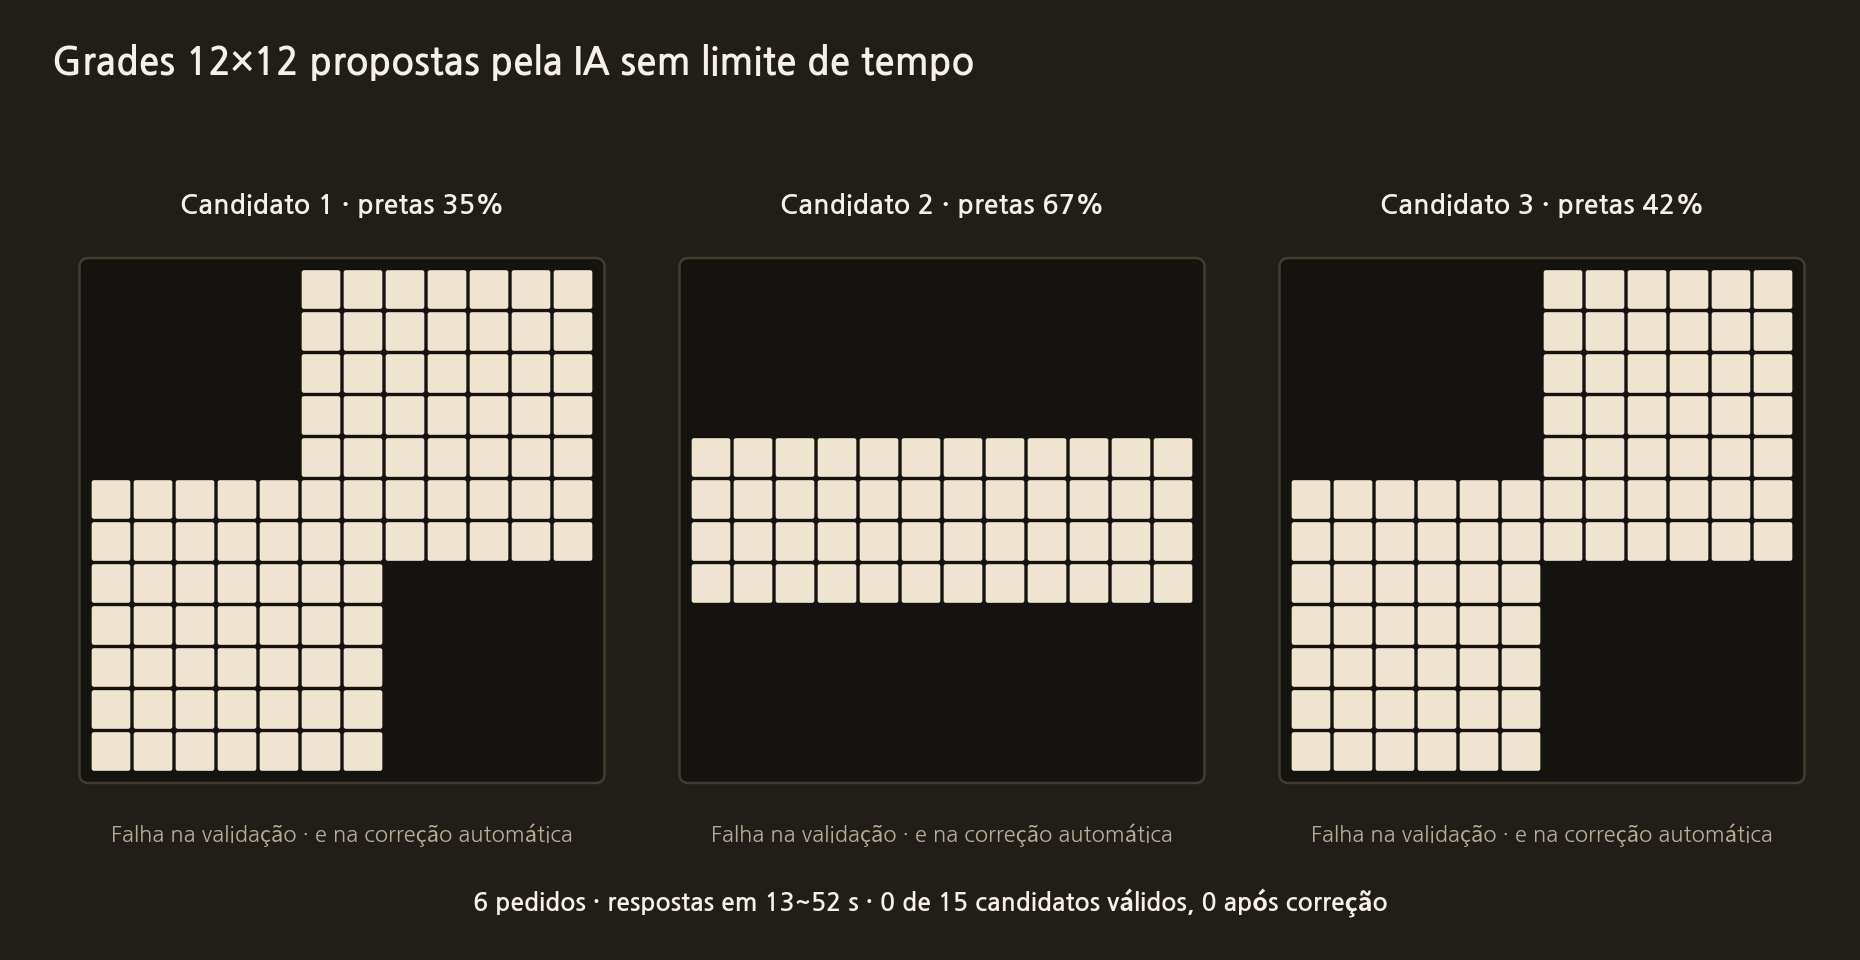
Toda vez que uma grade nova é criada, ele espera 15 segundos pelo projeto da grade. Em 8 das 9 vezes a resposta não chegou em 15 segundos, e uma vez a resposta chegou, mas não tinha nenhuma grade utilizável.
Tiramos o limite de tempo e pedimos mais 6 vezes. As respostas levaram de 13 a 52 segundos, e dos 15 candidatos recebidos, 0 passaram nas regras, e 0 mesmo depois da correção automática. A maioria era um bloco com uma coluna inteira pintada de preto, como na imagem acima. Uma vez, a resposta ficou longa e foi cortada em 1.200 tokens. Na estrutura atual, os 15 segundos gastos no projeto da grade são simplesmente jogados fora toda vez.
Pistas da IA: 2/9, e a qualidade das pistas
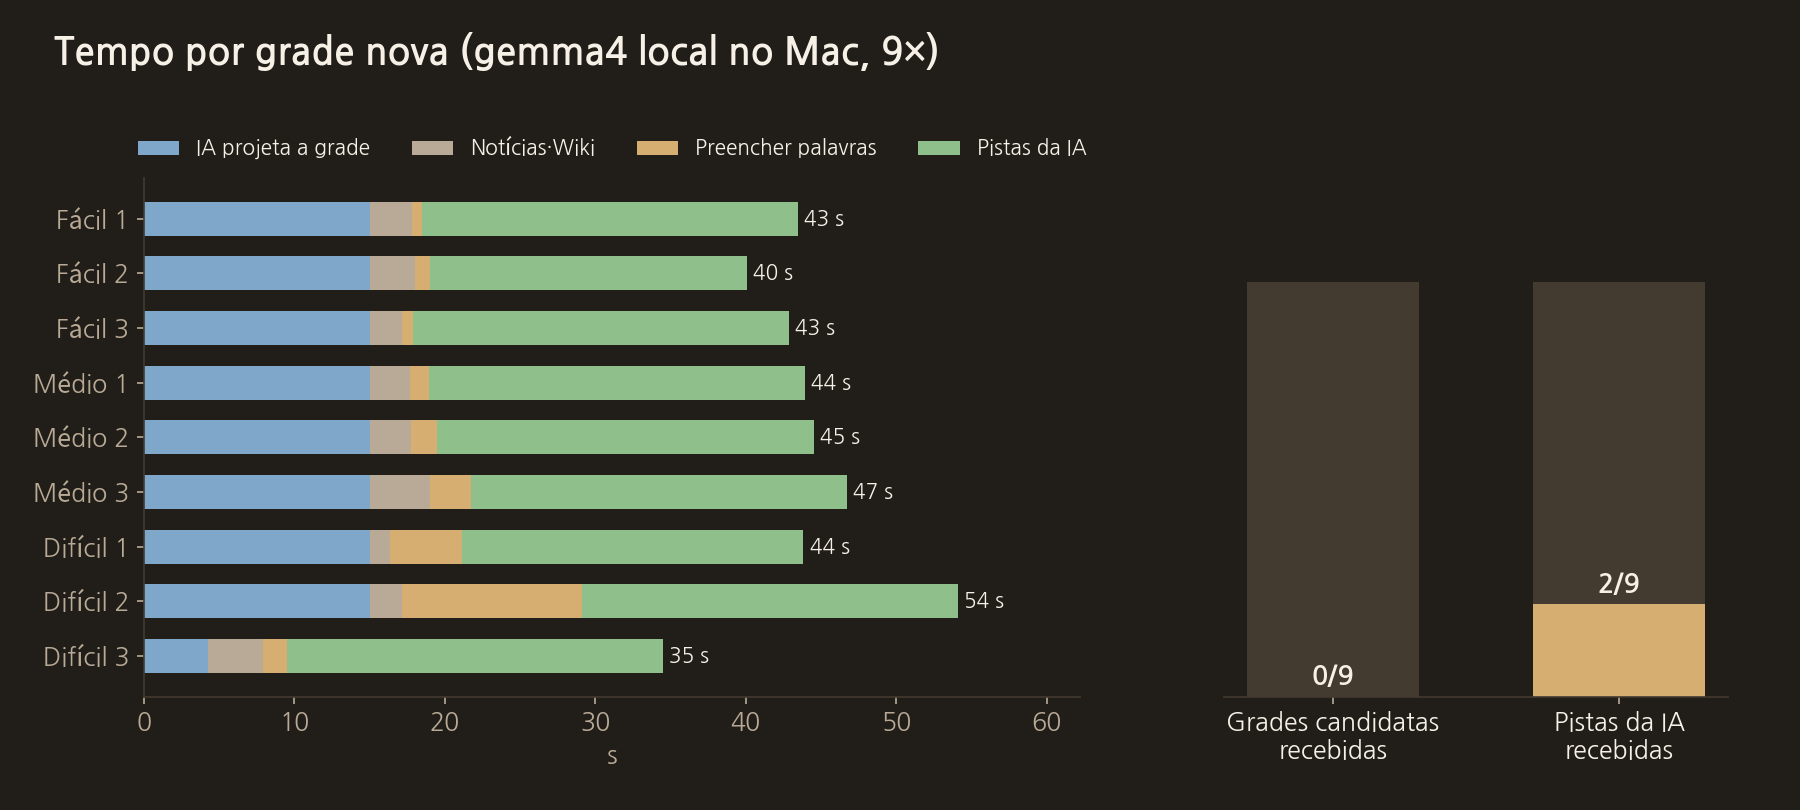
A escrita das pistas tem limite de 25 segundos. Em 7 das 9 vezes, o tempo estourou e foram usadas as frases padrão do banco de palavras. Receber uma grade nova levou de 35 a 54 segundos, com mediana de 44 segundos, e a maior parte disso é a espera pela IA duas vezes.
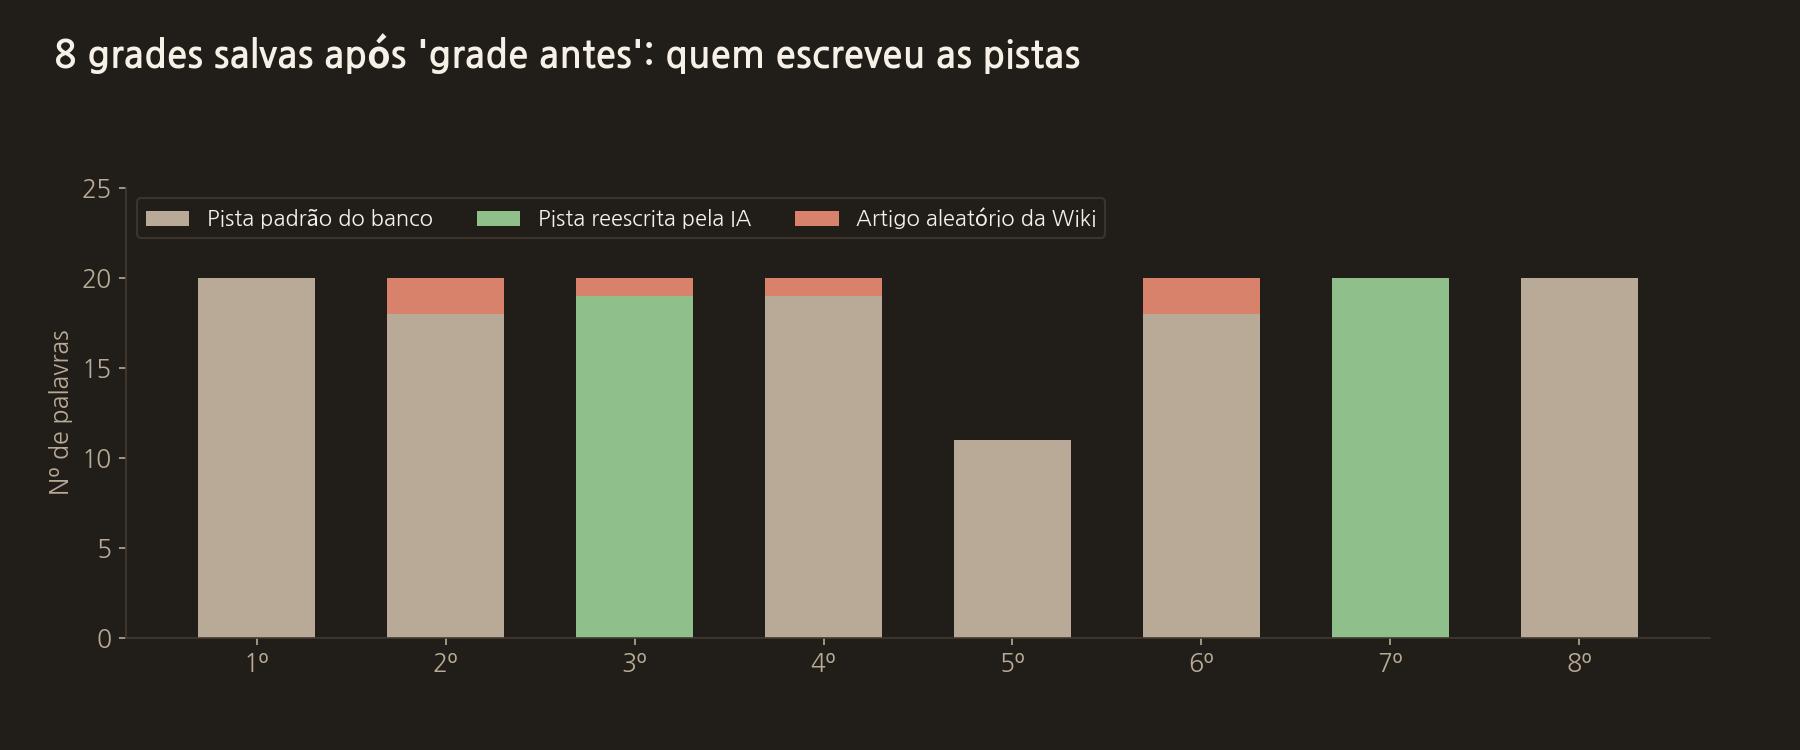
As 8 grades realmente salvas são parecidas. A IA reescreveu as pistas de só 2 delas.
As frases escritas pela IA também tinham problemas.
- Viram definições de dicionário em vez de quiz. "O torneio de futebol organizado em conjunto por Estados Unidos, México e Canadá em 2026" virou "um torneio internacional de futebol em que seleções de vários países se reúnem para competir". As pistas de atualidades colocadas para aumentar a dificuldade viram definições comuns.
- Citação errada: uma pista sobre Confúcio trouxe "o ensinamento 'Tornando-se um grou, aprender e praticar de tempos em tempos'". A primeira frase dos Analectos é "Aprender e praticar de tempos em tempos".
- Tempo verbal: descreveu os Jogos Olímpicos de Inverno de 2026, que já terminaram, como "um festival de esportes de inverno que será realizado".
- Um livro que não existe: chamou d'Alembert de "a pessoa que escreveu o *Pilsoenon*".
- Chamou a Cidade Metropolitana de Daejeon de "distrito autônomo metropolitano".
O banco de palavras e as palavras de atualidades
- Há entradas em que as palavras foram cortadas para preencher sequências de 5 sílabas. São 8, como 'Incheon-gukjegong' (Incheon Internacion…), 'Gimpo-gukjegong' (Gimpo Internacion…), 'siwoe-beoseuteo' (terminal de ônibus intermunici…) e 'gukhoe-uiwonseon' (eleição parlamen…), com pistas do tipo "a primeira parte de …". A resposta da ponte de São Francisco é 'Geummun' (Golden Gate), e não 'Geummungyo' (ponte Golden Gate).
- Há entradas em que a própria pista está errada. A pista de 'naengjanggomun' (porta da geladeira) é "a porta que se abre e fecha em um armário".
- Respostas vindas de artigos aleatórios da Wikipédia: palavras como 'Sibalikeu-geup-guchukham' (fragata da classe Shivalik), 'Randoeo-gwa', 'Illineeo-rekojeu' (Illionaire Records) e 'Im-hyeok-dongeumiui' (desambiguação de Lim Hyuk). 'Dongeumiui' (desambiguação) é uma palavra que vai no título dos artigos. A pista é a primeira frase do artigo da wiki cortada em 70 caracteres, então a pista de 'Lee-chaeyun-gasu' (Lee Chae-yoon, cantora) quase entrega a resposta, como em "Chaeyoon (nome verdadeiro: Lee Seul, …) é uma cantora sul-coreana". 4 das 8 grades salvas tinham palavras assim.
- Na prática, as notícias recentes quase não são usadas. A API de grade nova chama a função que faz a IA escolher palavras a partir das notícias com ela desligada. As manchetes só são usadas em uma regra: se tiverem 'Nepal', 'enchente' e 'geleira', acrescenta Nepal e Himalaia. O Nepal entra até em notícias de enchentes de outros países. A maioria das pistas de atualidades são as 12 colocadas à mão.
- Os níveis de vocabulário por dificuldade (comum, normal, rara) existem só como uma função que os calcula; o gerador não os usa. Hoje a dificuldade só se diferencia pelo tamanho da grade, pelas casas reveladas e pelo comprimento das respostas.
Continuar de onde parou funciona bem
As grades com salvamento parcial puderam ser reabertas pelos registros e retomadas, e as grades vazias foram apagadas. Depois da mudança para escrever a resposta inteira, duas grades de 20 pistas concluídas levaram 24 e 27 entradas e 24 e 15 minutos.
Uma coisa precisa ser corrigida. A sala de jogo salva o tempo decorrido a cada 5 segundos, então o tempo vai se acumulando mesmo que uma grade sem nenhuma entrada fique só aberta em uma aba. Uma grade vazia tinha mais de 13 horas registradas e, como nunca passou pelo lobby, também nunca foi apagada.
Direções para corrigir
- Tirar a IA do projeto da grade ou deixá-la para depois. Hoje ela gasta 15 segundos e não traz nada. O programa vai criar as grades, optando por grades mais esparsas, com menos casas compartilhadas entre horizontal e vertical.
- Buscar as palavras de acordo com a grade. Dar ao modelo as sílabas já fixadas na sequência, como '○seu○○', fazer com que ele proponha palavras candidatas e conferi-las em um dicionário antes de colocá-las. Só o banco de palavras definido de antemão não tem palavras suficientes de 4 e 5 sílabas.
- Criar as grades com antecedência. Cada grade leva cerca de 44 segundos, então basta criá-las em segundo plano e estocá-las por dificuldade, entregando-as na hora. Assim também dá para aumentar os limites de tempo e sobra tempo para revisão.
- Revisar as pistas. Fazer as pistas de atualidades manterem o formato de quiz e conferir mais uma vez datas, tempos verbais e citações. Tirar os artigos de "desambiguação" da wiki e os nomes próprios longos demais, e verificar se parte da resposta aparece na pista.
- Organizar as palavras cortadas e as pistas erradas, e refletir os níveis de vocabulário na dificuldade real.
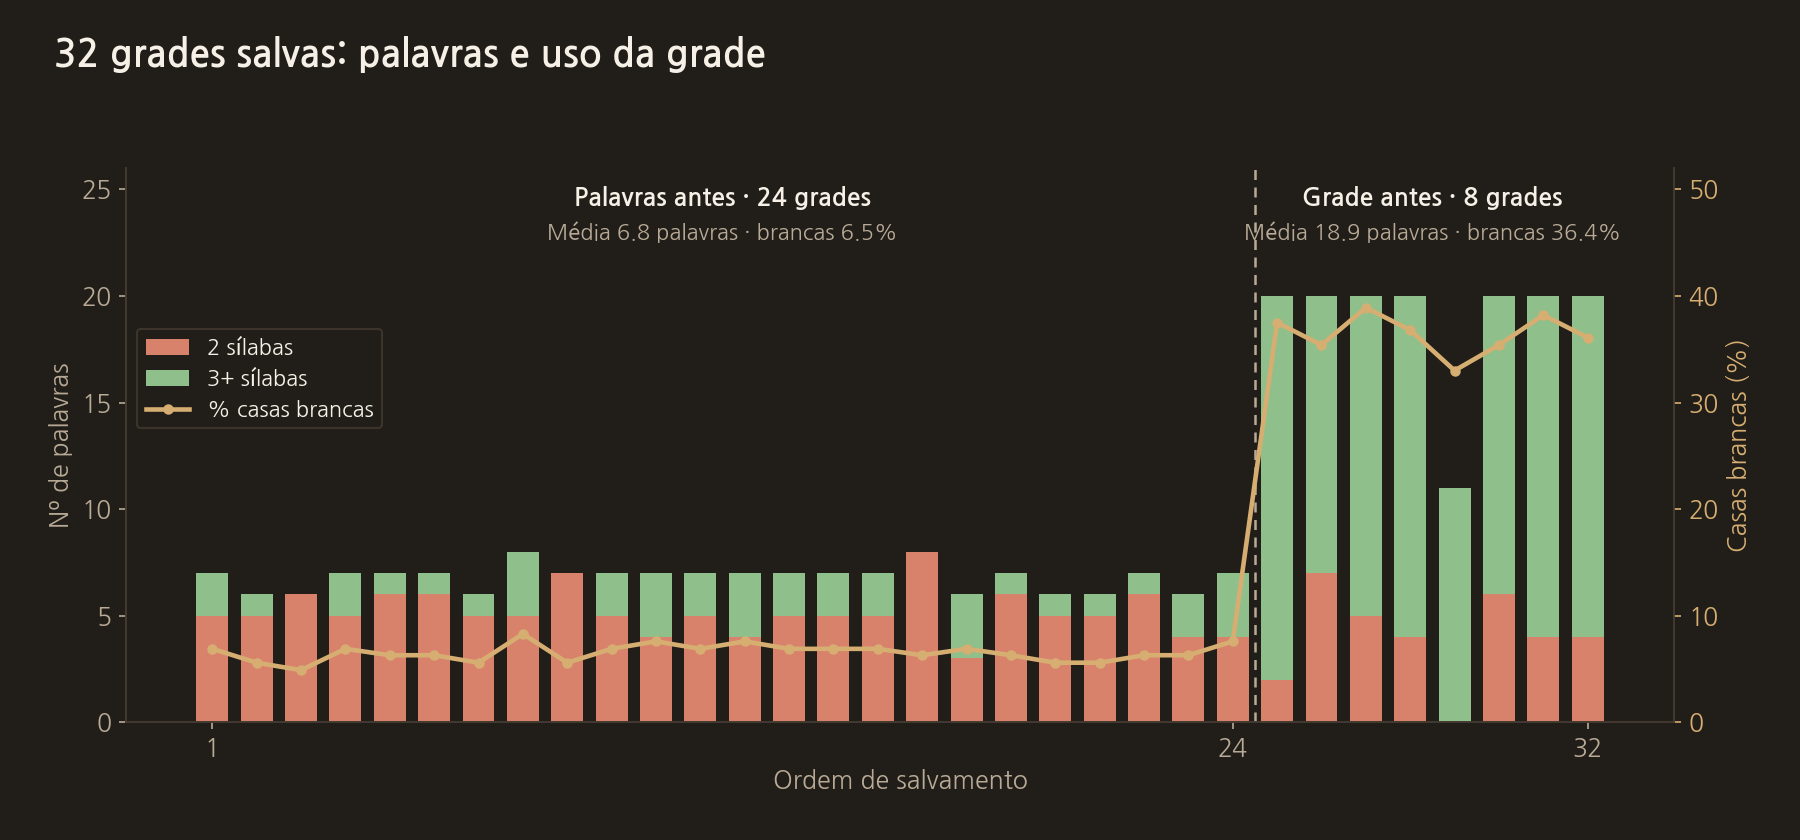
Estas são todas as 32 grades salvas. O número de palavras e o aproveitamento da grade melhoraram claramente. Mas essas grades vieram do caminho reserva, não do caminho planejado da grade primeiro, e o que falta resolver é o formato da grade e a qualidade das pistas.
O código real desta etapa
Esta é a ordem de preenchimento da grade. Ele tenta grade desenhada de antemão → grade aleatória → posicionador que encaixa palavras. Nas medições, as duas primeiras etapas nunca deram certo, então ele sempre descia até a última linha.
lib/gridFill.ts
for (const mask of shuffle(readyBoards(size, cap), rng)) {
  const filled = tryMask(mask);
  if (filled) return filled;
}
for (let attempt = 0; attempt < 8; attempt++) {
  const mask = makePattern(size, 2, cap, rng);
  if (!mask) continue;
  const filled = tryMask(mask);
  if (filled) return filled;
}
for (let attempt = 0; attempt < 5; attempt++) {
  const connected = tryBuildConnected(size, maxLen, bank, prefer, avoid, rng);
  if (connected) return connected;
}
return null;
Esta é a parte que reúne as palavras de atualidades. A API de grade nova passa useLlm como false, então as palavras da IA baseadas em notícias ficam vazias, e as manchetes só são usadas na regra do Nepal.
lib/dynamicBank.ts
export async function loadDynamicBank(
  difficulty: DiffKey,
  avoid: Iterable<string>,
  options?: { useLlm?: boolean },
): Promise<DynamicBankResult> {
  const avoidList = [...avoid];
  const [headlines, wiki] = await Promise.all([fetchNewsHeadlines(), fetchWikiEntries(16)]);
  const llm = options?.useLlm === false ? [] : await fetchLlmEntries(difficulty, headlines, avoidList);
  const newsHints: WordEntry[] = [];
  if (headlines.some((h) => h.includes("네팔") || h.includes("홍수") || h.includes("빙하"))) {
    const nepal = asHangulEntry("네팔", "이번에 히말라야 빙하가 무너져 큰 홍수가 난 나라");
    const himal = asHangulEntry("히말라야", "올해 빙하가 붕괴해 네팔에 대홍수를 일으킨 산맥");
    if (nepal) newsHints.push(nepal);
    if (himal) newsHints.push(himal);
  }
  const entries = [...llm, ...newsHints, ...wiki];
  const source: DynamicBankResult["source"] = llm.length >= 12 ? "llm" : wiki.length ? "wiki" : headlines.length ? "news" : "bank";
  return { entries, source };
Estas são as palavras cortadas para caber em 5 sílabas.
lib/words.ts
{ word: "시외버스터", clue: "시외버스가 모이는 곳의 앞말" },
{ word: "인천국제공", clue: "서해 관문 국제공항의 앞말" },
{ word: "김포국제공", clue: "서울 서쪽 국제공항의 앞말" },
O próximo post é "4. O código-fonte completo e as ferramentas usadas".
COMMENTS · CHAPTER 03
O processo de criação e seus problemas, revistos com estatísticas 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google