Método
O llm_macro_client.py é um cliente que se conecta à tela em Qt.
- No tabuleiro recebido, apaga a peça em movimento e deixa só os blocos travados.
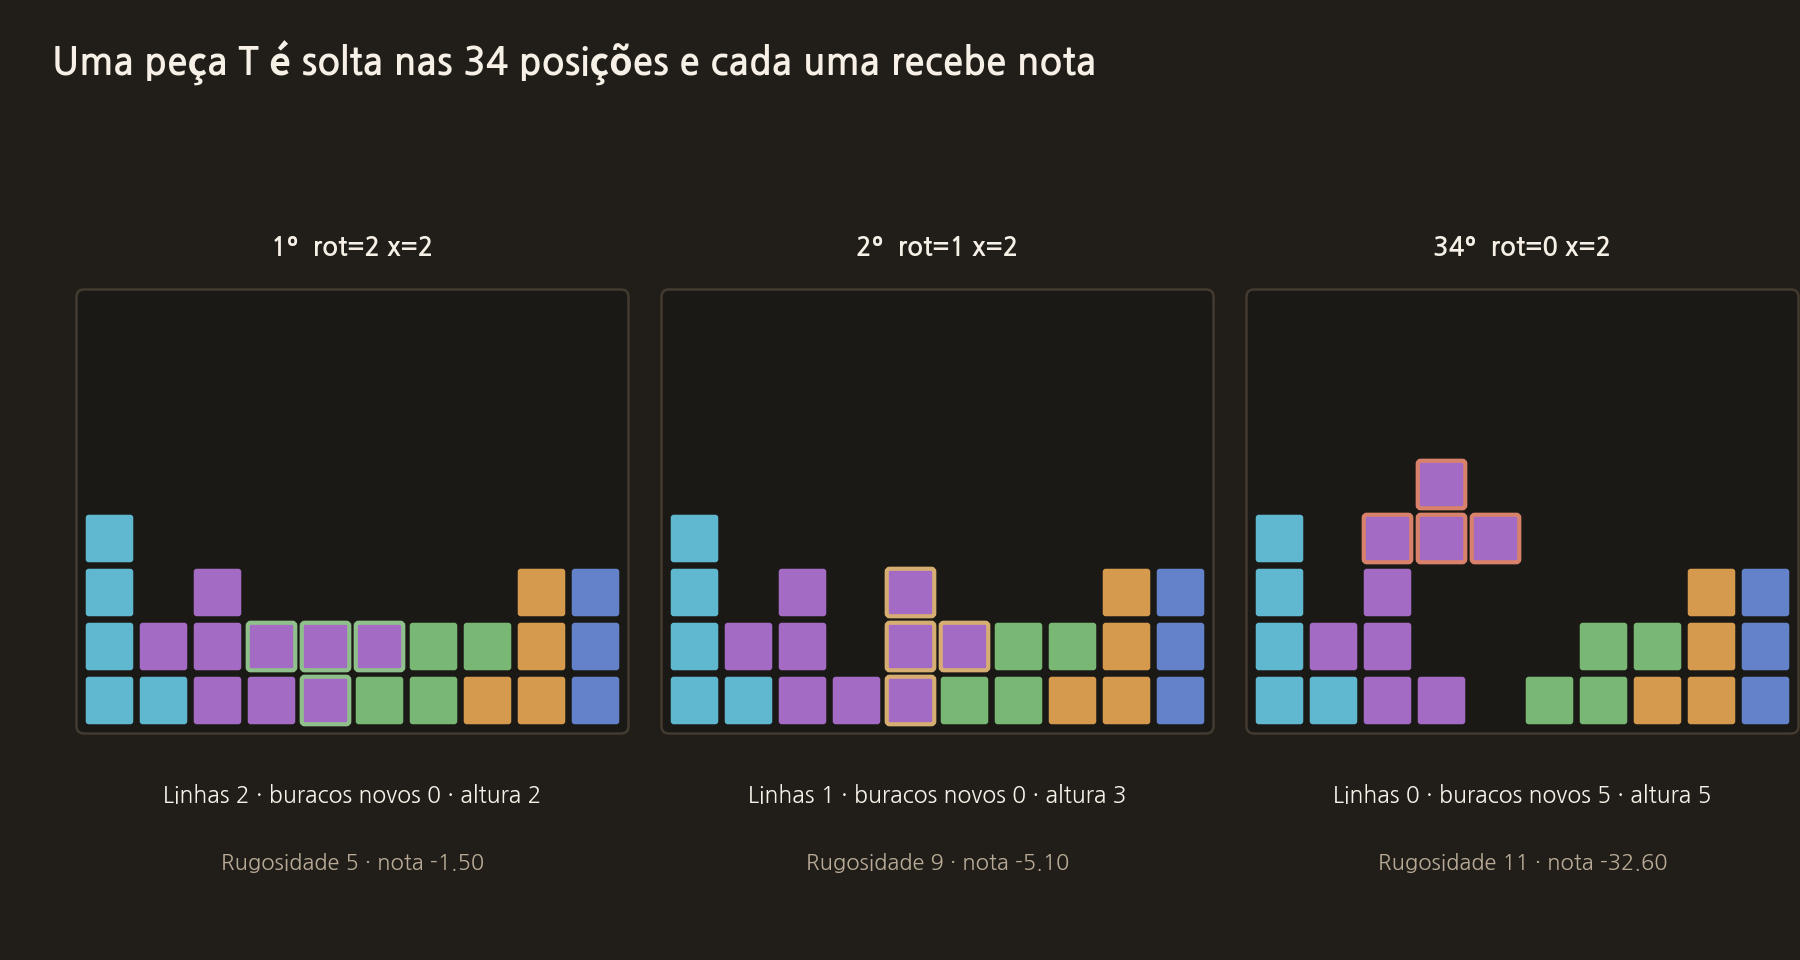
- Experimenta soltar a peça atual em cada rotação e em cada x. Para a peça T, são 34 lugares. Lugares com x negativo também entram.
- Para cada lugar, calcula as linhas eliminadas, os buracos novos, as casas empilhadas sobre buracos, a irregularidade, a altura máxima, a altura de pouso e os poços, e dá uma pontuação.
- Coloca mais uma vez a próxima peça, soma 0,7× a melhor pontuação dela e reordena.
- Mostra os 6 primeiros ao LLM (Qwen2.5-3B GGUF) junto com o tabuleiro em texto e faz com que ele escolha só um número. O LLM não tem como inventar coordenadas.
- Ajusta a rotação e o movimento para o lugar escolhido e solta a peça de vez.
Com --no-llm, ele usa a 1ª opção sem o LLM.
Só com a heurística
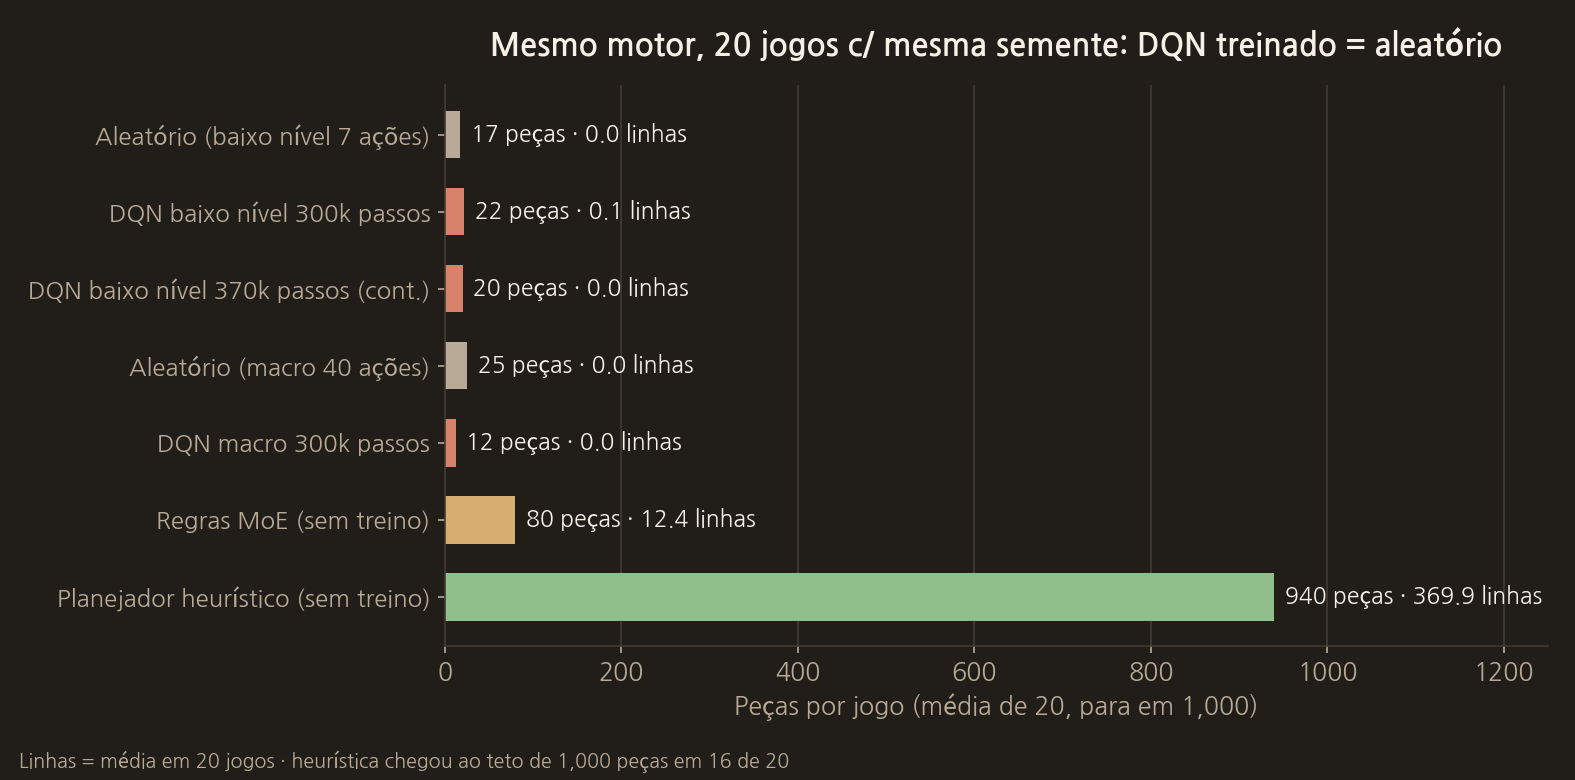
A C API não fornece a próxima peça, então neste teste pulamos o passo 4 (olhar uma peça à frente) e usamos só a 1ª opção. Foram 20 partidas com as mesmas seeds, paradas em 1.000 peças.
- Média de 940 peças e 370 linhas
- 16 de 20 partidas sobreviveram até 1.000 peças. As outras 4 terminaram em 375, 736, 811 e 863 peças.
- Das 16 partidas que chegaram a 1.000, 12 terminaram com a altura da pilha em 6 casas ou menos.
Sem treino, com uma única fórmula de pontuação, ela supera de longe o DQN (0 linhas) e o MoE (12 linhas).
Quando o LLM escolhe
Com o LLM conectado, rodamos 1 partida com a seed 0 até 150 peças. Terminamos cedo porque a GPU está sendo dividida com o treino do gomoku.
- Em 147 de 150 vezes (98%), ele escolheu a 1ª opção. A 2ª opção 2 vezes e a 3ª 1 vez.
- Terminou com 55 linhas, 0 buracos e altura de 7 casas. Nas mesmas condições, usando só a 1ª opção da heurística, são 58 linhas.
- Cada escolha levou em média 1,7 segundo. Só com a heurística, 20 partidas, mais de 18 mil peças, são jogadas em 14 segundos.
O prompt diz "se [0] satisfizer as condições, escolha 0", e os candidatos já vêm ordenados por pontuação, então o LLM quase sempre segue a heurística. Na estrutura atual, o LLM não melhora o tabuleiro; só deixa tudo mais lento.
Resumo
- DQN de baixo nível: quase nunca vê a recompensa por linha, então é igual ao aleatório.
- DQN macro: a representação das ações bloqueou a coluna mais à esquerda, e ele repete só dois lugares no meio.
- Recompensa do VLM e escolha direta pelo VLM: não distinguem os tabuleiros e empilham no meio.
- Cálculo de candidatos e pontuação: passa de 1.000 peças sem treino. O LLM serve no máximo para confirmar a 1ª opção.
Em seguida, pretendo trocar as ações macro pelos 162 lugares onde as peças podem de fato ser colocadas e treinar de novo o DQN usando como exemplo os tabuleiros jogados pelo planejador heurístico.
O código real desta etapa
Esta é a pontuação de um único lugar.
llm_macro_client.py
on_hole_w = 3.0 * max(0.2, 1.0 - max_h_global / 16.0)

score = (
    + 1.0 * cleared
    - 4.0 * new_holes
    - on_hole_w * cells_above_hole
    - 0.36 * holes_after
    - 1.00 * max_h            # 0.5 → 1.0 (높이 누적 강하게 회피)
    - 0.30 * bump_eff         # 0.18 → 0.30 (양쪽 우물 패턴 회피)
    - 0.70 * landing_height   # 0.5 → 0.7 (깊게 박기 우선)
    - 0.40 * other_well_sum
    + 0.30 * well_bonus       # 0.5 → 0.3 (테트리스 욕심을 줄임)
)
Experimenta soltar a peça atual em todos os lugares possíveis.
llm_macro_client.py
def enumerate_candidates(board: np.ndarray, ptype: int) -> list[dict]:
    if ptype == 0:
        return []
    heights_before = column_heights(board)
    hole_cols_before = column_hole_count(board, heights_before)
    holes_before = sum(hole_cols_before)

    nrot = _PIECE_NROT[ptype]
    w = board.shape[1]
    cands = []
    for rot in range(nrot):
        cells = PIECE_CELLS[ptype][rot]
        min_dx = min(dx for dx, _ in cells)
        max_dx = max(dx for dx, _ in cells)
        x_lo = -min_dx
        x_hi = w - 1 - max_dx
        for x in range(x_lo, x_hi + 1):
            r = evaluate_placement(
                board,
                ptype,
                rot,
                x,
                heights_before=heights_before,
                hole_cols_before=hole_cols_before,
                holes_before=holes_before,
            )
            if r is not None:
                cands.append(r)
    cands.sort(key=lambda r: r["score"], reverse=True)
    return cands
Estas são as regras de escolha dadas ao LLM.
llm_macro_client.py
"Selection priorities (STRICT, in order):\n"
"  1) on_hole == 0  (NEVER stack on a column that already contains buried holes)\n"
"  2) new_holes == 0 (do not create new holes)\n"
"  3) cleared >= 1 (clear lines if possible)\n"
"  4) higher 'look' (1-step lookahead) wins ties\n"
"  5) lower max_h, then lower bump, then lower land_h.\n"
"If [0] already satisfies (1)+(2), just pick 0.\n"
f'Reply EXACTLY as: {{"choice": <integer 0..{len(candidates) - 1}>}}'
O próximo post é "6. O código-fonte completo e os modelos usados".
COMMENTS · CHAPTER 05
O código calcula os lugares, o LLM só escolhe 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google