Aprender jogando
Abandonamos a memorização da ordem e deixamos o modelo jogar o tabuleiro sozinho. Quando o modelo faz uma jogada, o servidor a compara com a resposta e, se estiver errada, um oráculo (um código que sabe a resposta) faz a jogada correta no lugar dele. Com os registros acumulados dessa forma, o treinamento do LoRA continuava a cada 3 partidas.
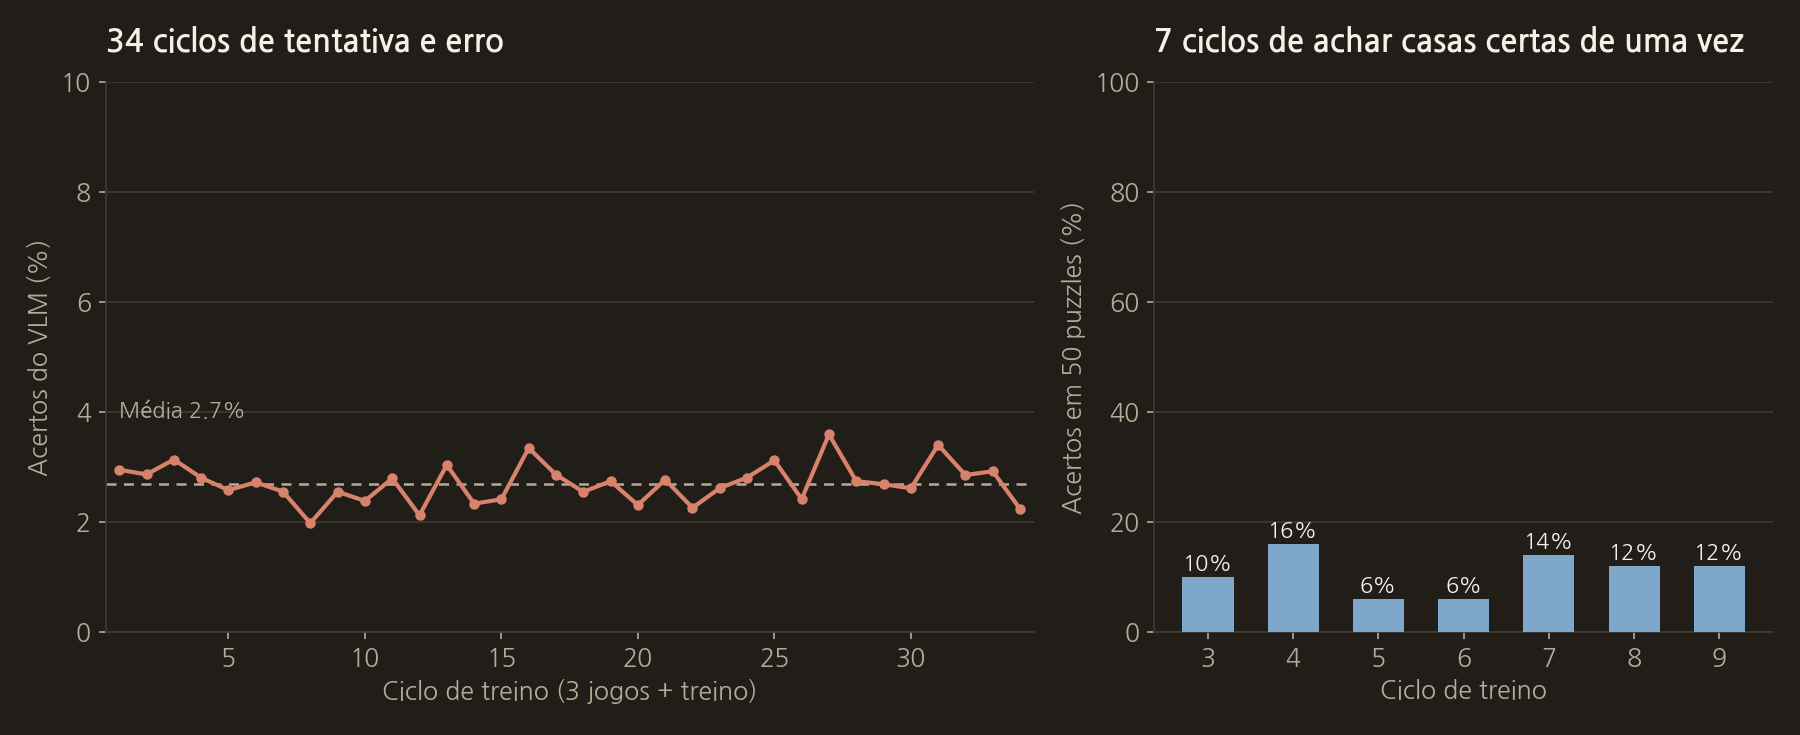
Rodamos 34 ciclos ao longo de três dias. A proporção de jogadas corretas do modelo foi de 2,0–3,6% por ciclo, e de 1.695 em 62.842 (2,7%) no total. Por mais que treinássemos, ela não subia.
Encontrar uma casa certa de uma vez
Em seguida, fizemos o modelo escolher diretamente uma casa 100% certa no tabuleiro inteiro (lora_cell). Rodamos 7 ciclos, colocando de volta os problemas que ele errava, mas a taxa de acerto em 50 problemas de teste foi de 6–16%. Quando o colocamos para fazer 15 jogadas em tabuleiros reais, ficou entre 0 e 33%.
Também tentamos um currículo que separava dígitos e casas e ensinava primeiro a parte fácil. O acerto de dígitos caiu de 34% para 26%, e o acerto de casas não saiu de 0%.
O que o oráculo ensinou
Nessa época, escrevi separadamente no solve.md como as pessoas resolvem sudoku. Nesse documento, descrevi assim o motivo da falha.
O oráculo conhece valores com probabilidade abaixo de 20% e treina o VLM com esses valores, então os resultados treinados não mostram diferença, e por isso parece que o VLM não tem nenhuma regularidade sobre exatamente por que essa resposta fica desse jeito.
O oráculo sempre sabe a resposta. Ele não se importa se aquela casa pode ser deduzida a partir do tabuleiro atual. Com respostas misturadas que não têm base no tabuleiro, não havia regra para o modelo aprender. Era o mesmo problema da folha de respostas do post 1.
O código real desta etapa
Este é um ciclo do loop que joga 3 partidas e depois treina. Ele joga as partidas, extrai dados de treinamento dos registros acumulados e continua o treinamento do LoRA.
vlm_play_train_loop.py
results, play_accuracy = run_games(
    session,
    games=args.games_per_cycle,
    difficulty=args.difficulty,
    max_steps=args.max_steps,
    verbose=args.verbose,
    save_images=None,
    game_id_start=state.game_id_next,
    accuracy=play_accuracy,
    human=args.human,
)
state.game_id_next += args.games_per_cycle
print_summary(results, play_accuracy)
print(f"\n사이클 {cycle} 시도정답률(리젝 포함): {play_accuracy.fmt()}")

# ...

total_lines = count_replay_lines(replay_path)
cycle_jsonl = cycle_sft_dir / f"cycle_{cycle:04d}.jsonl"
kept, new_total, by_outcome = export_trainable(
    replay_path,
    cycle_jsonl,
    since_line=state.replay_line_offset,
)

# ...

t0 = time.monotonic()
exit_code = run_training(
    dataset_jsonl=cycle_jsonl,
    base_model=args.base_model,
    adapter_dir=adapter_in,
    output_dir=args.output_dir,
    device=args.device,
    epochs=args.train_epochs,
    batch_size=args.batch_size,
    grad_accum=args.grad_accum,
)
O próximo post é "3. Transformando a resolução humana em regras".
COMMENTS · CHAPTER 02
Ela não conseguiu aprender por tentativa e erro 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google