O que o VLM está aprendendo agora
O treinamento automático junta só as jogadas do lado vencedor e faz o VLM imitá-las. Mas, nas partidas de treinamento, as brancas (o VLM) venceram 94%, e as jogadas das brancas ficaram registradas como se tivessem sido feitas pela IA local. Por isso, 10.513 dos 12.080 exemplos eram jogadas das brancas, ou seja, jogadas feitas pelo próprio VLM. Como vimos no post 1, até esse treinamento quebrou com uma loss NaN.
A pergunta enviada ao VLM também não contém nenhuma regra de gomoku. Ela mostra o tabuleiro e pede só dois números, as coordenadas de uma casa vazia. Palavras como três, quatro ou jogada proibida nunca aparecem.
O que aprendemos com o go e com o quebra-cabeça deslizante
No go, enquanto corrigíamos a heurística e a colocávamos para jogar contra o R5, a heurística acabou ensinando o R5. No quebra-cabeça deslizante, colocar na heurística as regras que as pessoas usam para resolver fez com que ela resolvesse todos os 4.000 tabuleiros em um dia. Nas duas vezes, regras sem ganância abriram o caminho antes do treinamento que persegue recompensa futura.
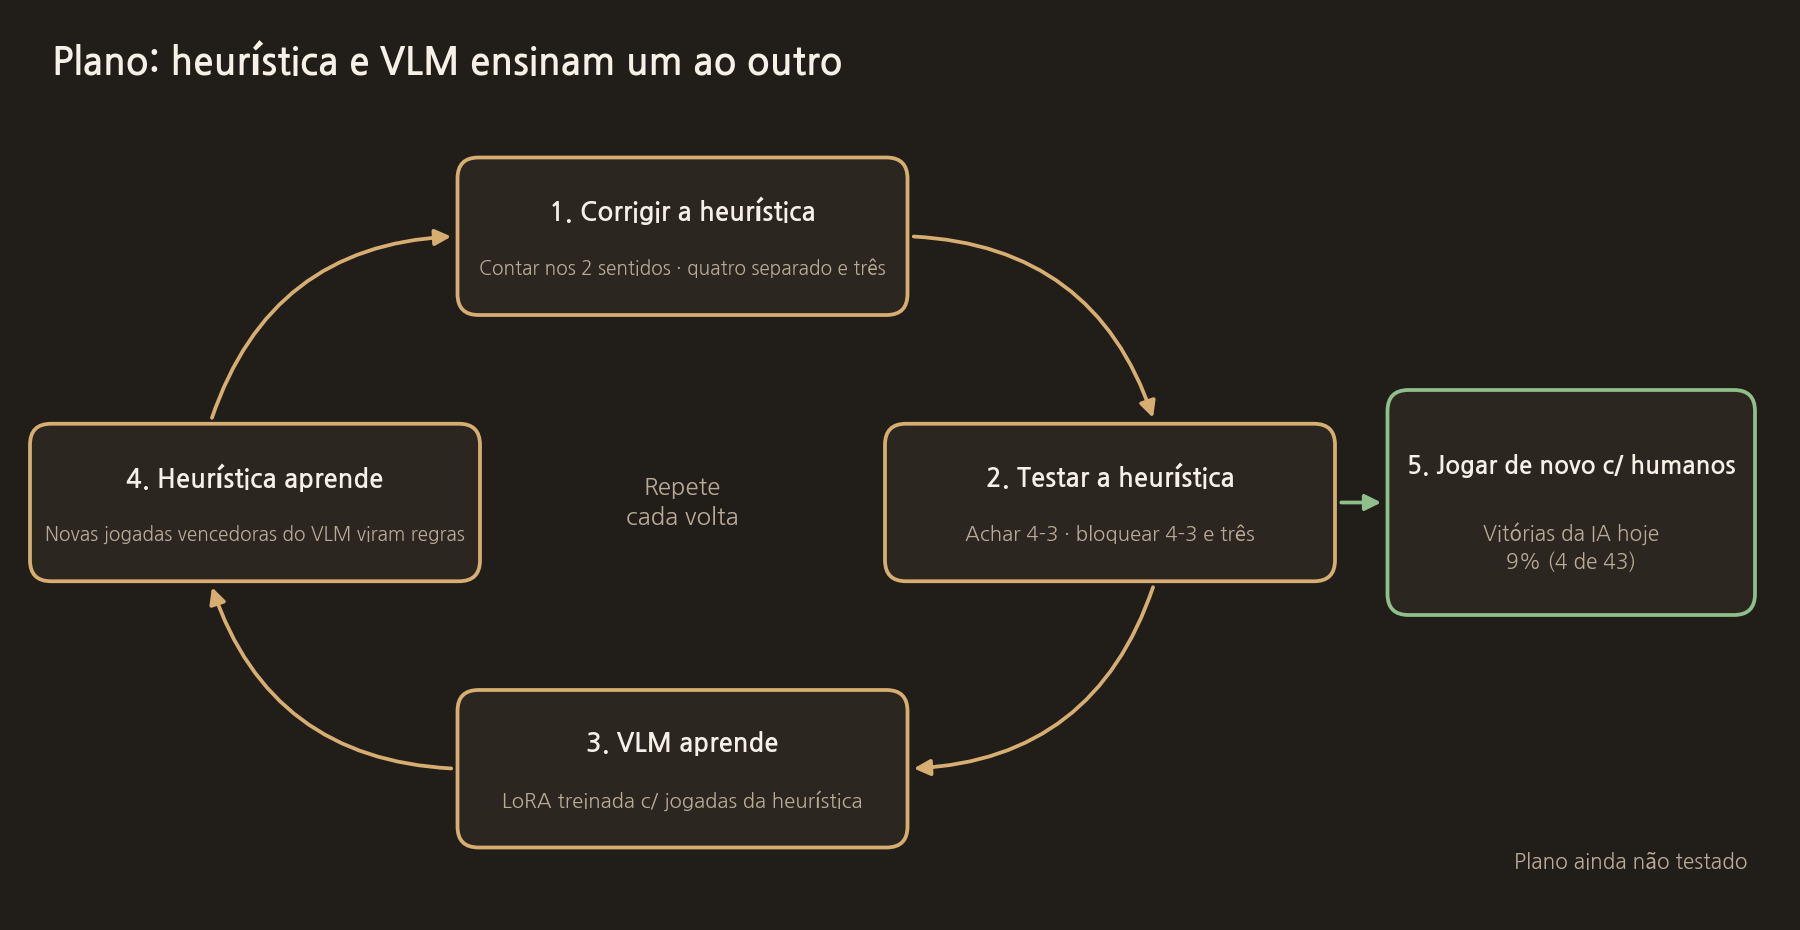
Pretendemos tentar o mesmo método no gomoku. Este plano ainda não foi testado.
O plano
- Corrigir a heurística: contar cada linha nas duas direções, e contar quatros separados (○_○○○) e três separados como os mesmos formatos. Encontrar primeiro as próprias posições de quatro-três e bloquear antes as posições em que o adversário poderia formar um quatro-três ou um quatro aberto na jogada seguinte.
- Testar a heurística: rodar de novo, toda vez, os testes do post 3 (encontrar o próprio quatro-três, bloquear a posição de quatro-três do adversário, bloquear três) e verificar de novo se as regras favorecem algum lado, com partidas em que a mesma IA alterna entre pretas e brancas.
- Fazer o VLM aprender a heurística: treinar o LoRA de novo usando as jogadas da heurística corrigida como respostas corretas. Incluir na pergunta as jogadas proibidas e os formatos de ameaça, e começar corrigindo a configuração de treinamento quebrada (MPS fp16).
- Fazer a heurística voltar a ser professora: juntar as jogadas em que o VLM jogou diferente da heurística e venceu, e levar esses formatos de volta para as regras da heurística. Foi assim que o R5 e a heurística aprenderam um com o outro no go.
- Jogar de novo contra pessoas: avaliar pelo quanto a taxa de vitórias da IA contra pessoas sobe em relação aos 9% atuais (4 de 43 partidas).
O código real desta etapa
Esta é a pergunta enviada atualmente ao VLM. Ela pede só as coordenadas de uma casa vazia e não contém nenhuma regra de gomoku.
vlm_pva_server.py
base_prompt = (
    f"{turn_line}\n"
    f"{board_txt}\n"
    f"Choose your next {you_label} move on an EMPTY cell (a '.' in the TEXT board)."
    f"{opening_rule} "
    "Trust the TEXT board coordinates over the image. "
    "Reply with EXACTLY two integers separated by a single space: \"row col\". "
    f"row and col are both in 0..{last_idx}. No other text."
)
O próximo post é "5. O código-fonte completo e os modelos usados".
COMMENTS · CHAPTER 04
Um plano para o VLM aprender a heurística e para a heurística voltar a ser professora 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google