Ainda não começou
O Othello não tem nem código de treino nem dados de treino. O que vem a seguir é um plano.
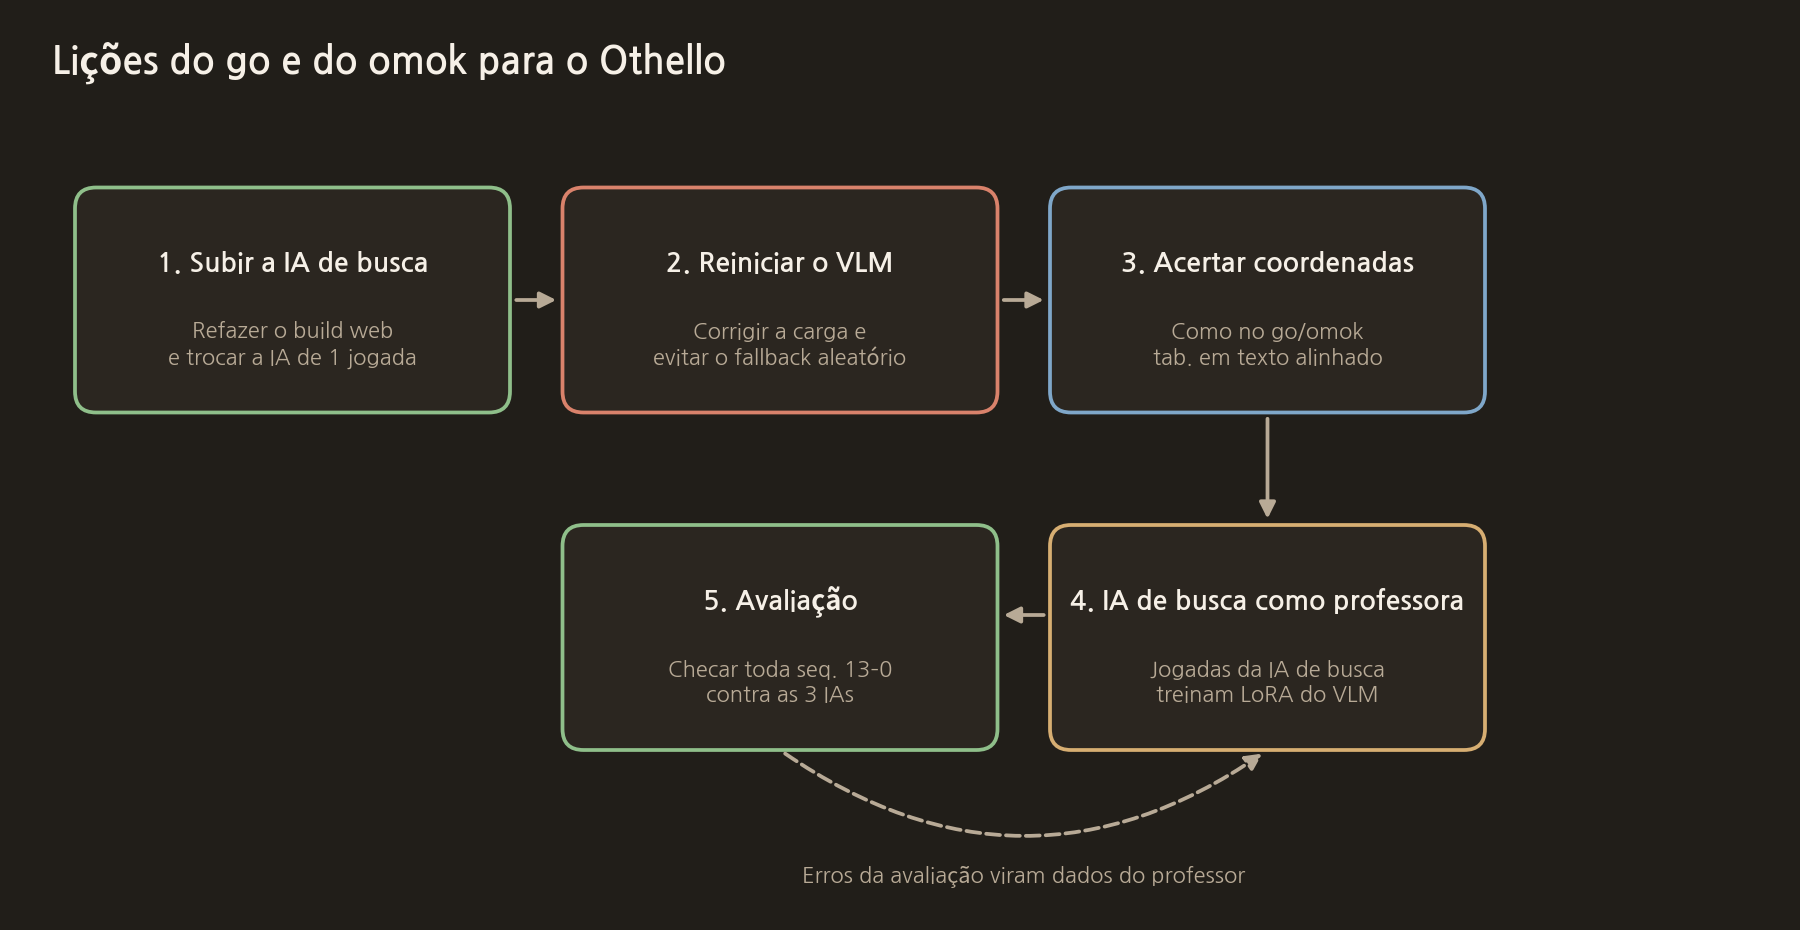
1. Colocar a IA de busca no ar
Refazendo o build da web, a IA de busca do post 2 entra no ar. As sequências do 13–0 do post 1 deixam de funcionar.
2. Colocar o VLM no ar de novo
Corrigimos o problema de carregamento ou trocamos para o Qwen3-VL-8B, que o servidor de go usa. Se o modelo não puder ser carregado, o servidor não sobe, e toda jogada trocada por uma aleatória fica registrada e também aparece na tela.
3. Alinhar as coordenadas
No go, depois de descobrir que cada modelo escreve as coordenadas de um jeito diferente, passamos muito tempo treinando o alinhamento de coordenadas. Estamos aplicando o mesmo treino ao gomoku. No teste antes do treino, só alinhar corretamente as colunas do tabuleiro em texto já reduziu a taxa de escolha de casas já ocupadas de 40% para 21%.
O Othello é 8×8 e o prompt traz a lista de jogadas legais, então o peso das coordenadas é pequeno. Mesmo assim, começamos pelo mesmo teste.
4. A IA de busca como professora
No go, depois de corrigir a heurística, treinamos o modelo usando essa heurística como professora. No Othello, a professora é a IA de busca. O LoRA do VLM é treinado com as jogadas escolhidas pela IA de busca como respostas corretas.
Como a resposta de cada jogada é decidida pela busca, os dados não ficam desequilibrados como no treino automático do gomoku, que juntava só as jogadas do lado vencedor.
5. Avaliação
- Como no post 1, expandimos todas as jogadas das pretas até a 11ª e contamos se existe alguma sequência de aniquilação.
- Jogamos 100 partidas contra cada uma: aleatória, IA de uma jogada e IA de busca.
- Nas partidas contra pessoas, registramos o tipo de adversário. Os registros de partida atuais não têm esse campo.
As jogadas das partidas perdidas na avaliação voltam como dados para a professora.
O código real desta etapa
Este é o prompt que damos ao VLM hoje. Ele inclui a lista de jogadas legais e pede a resposta em uma linha de JSON.
vlm_server/server.py
SYSTEM_PROMPT = (
    "당신은 8×8 오델로(Reversi)의 강한 플레이어입니다. "
    "보드 이미지와 텍스트 격자를 보고 다음 단 한 수를 고르세요. "
    "텍스트 격자가 이미지와 다르면 텍스트를 우선하세요. "
    "좌표는 0-indexed 정수 (row, col) 이며 각각 0..7 입니다. "
    "(0,0)은 좌상단 A1, 열 A–H = col 0–7, 행 1–8 = row 0–7. "
    "X=흑, O=백, .=빈칸. 반드시 합법수만 고르세요. "
    "합법수는 상대 돌을 하나 이상 끼워 뒤집는 빈 칸입니다. "
    "응답은 설명 없이 JSON 한 줄만 출력하세요."
)

# ...

def build_prompt(
    board: bytes,
    ai_side: int,
    legal: list[tuple[int, int]],
    forbidden: Optional[list[tuple[int, int]]] = None,
) -> str:
    side = "흑(X)" if ai_side == 1 else "백(O)"
    n_b, n_w = rules.counts(board)
    forbid_note = ""
    if forbidden:
        banned = ", ".join(f"({r},{c})" for r, c in forbidden[:16])
        forbid_note = f"\n금지 좌표(고르지 마세요): {banned}\n"
    return (
        f"당신의 차례: {side}. 흑 {n_b} · 백 {n_w}.\n"
        "보드 (X=흑, O=백, .=빈, 행=row 0=위, 열=col 0=왼쪽):\n"
        f"{rules.board_text(board)}\n\n"
        f"합법수: {rules.format_moves(legal)}\n"
        f"{forbid_note}"
        '다음 수를 JSON 한 줄로만 답하세요. 예: {"row": 2, "col": 3} '
        '합법수가 없으면 {"pass": true} 만 출력.'
    )
O próximo post é "5. O código-fonte completo e os modelos usados".
COMMENTS · CHAPTER 04
Um plano para levar ao Othello o que aprendemos com o go e o gomoku 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google