Como é a IA de gomoku atual
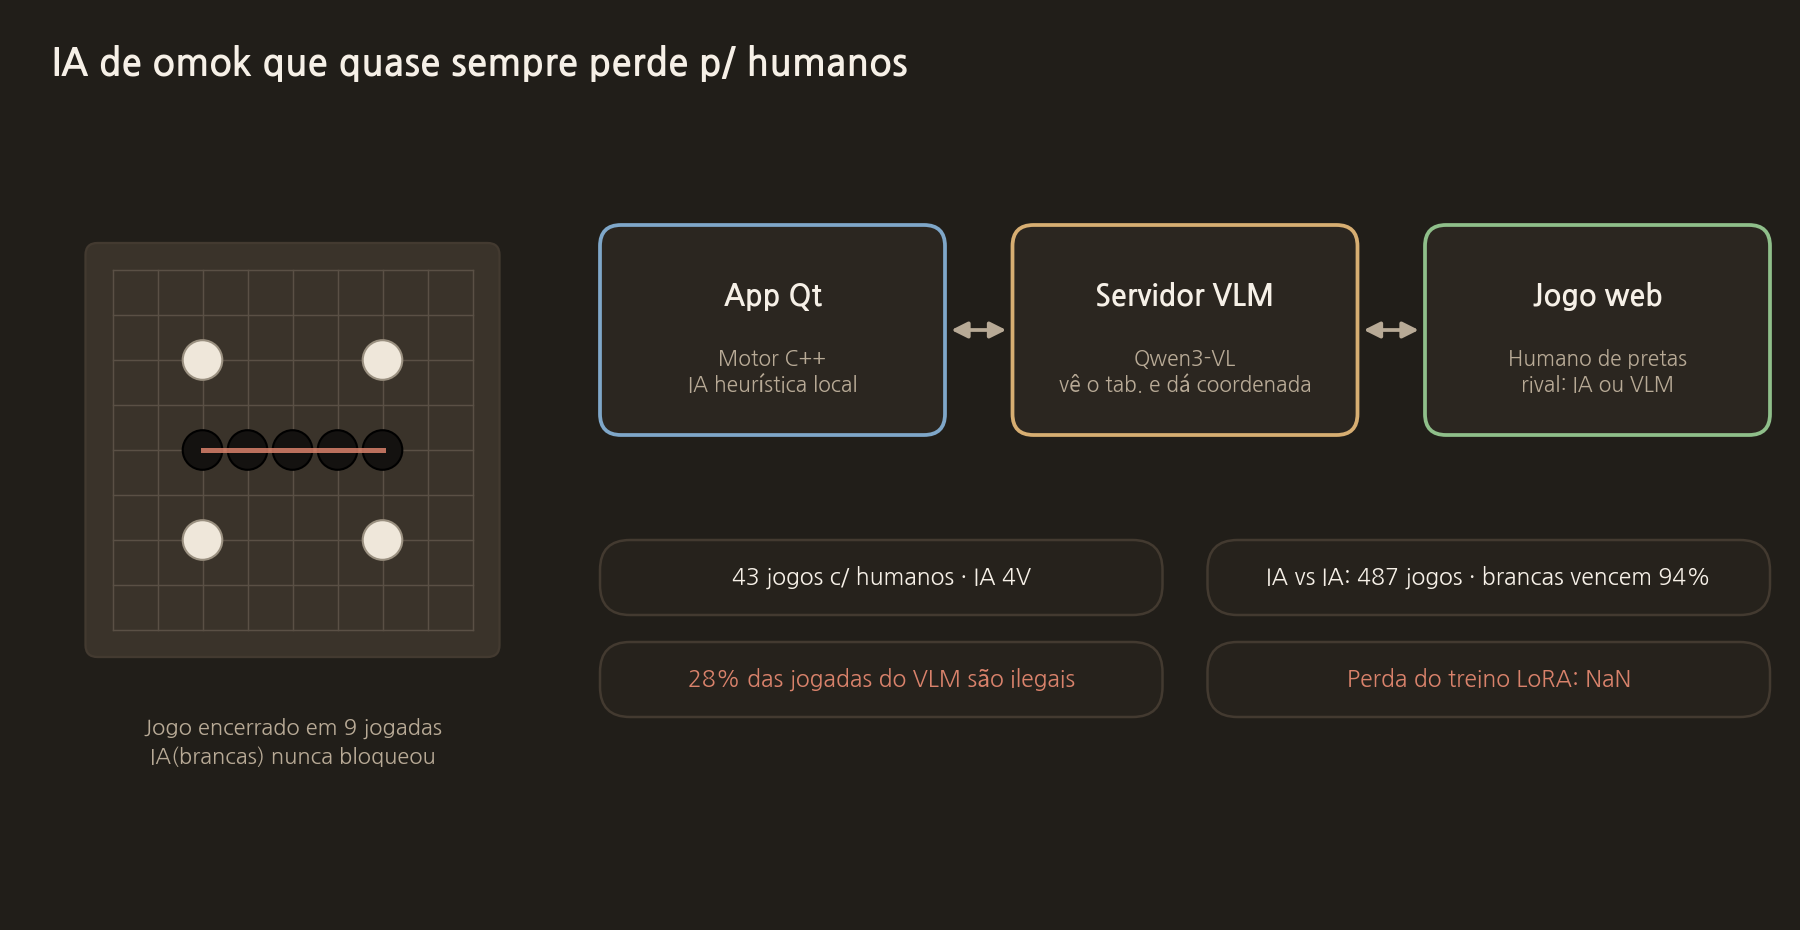
A IA de gomoku tem três partes.
- App Qt: um motor de gomoku e uma IA heurística local escritos em C++. Ele permite partidas humano contra IA, humano contra VLM e IA contra VLM.
- Servidor VLM: o Qwen3-VL olha uma imagem do tabuleiro e um tabuleiro em texto e responde a coordenada da próxima jogada.
- Partida na web: em [omook.mariago.kr](https://omook.mariago.kr/play), uma pessoa joga com as pretas e escolhe como adversário a IA local ou o VLM.
Resultados contra pessoas
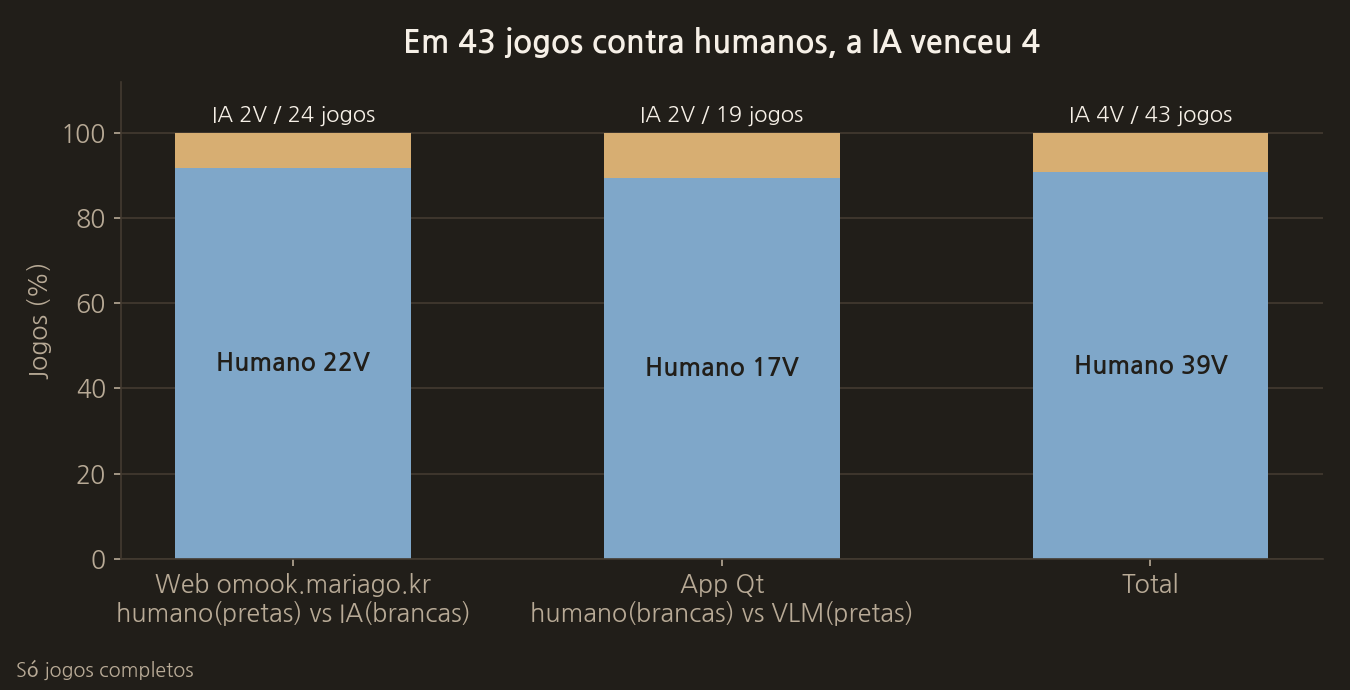
Contando só as partidas jogadas até o fim, as pessoas venceram 39 de 43. Na web, as pessoas venceram 22 de 24 e, no app Qt contra o VLM, 17 de 19. Duas partidas na web terminaram em 9 jogadas porque a IA não bloqueou nenhuma vez enquanto as pretas colocavam cinco pedras.
Partidas de treinamento entre IAs
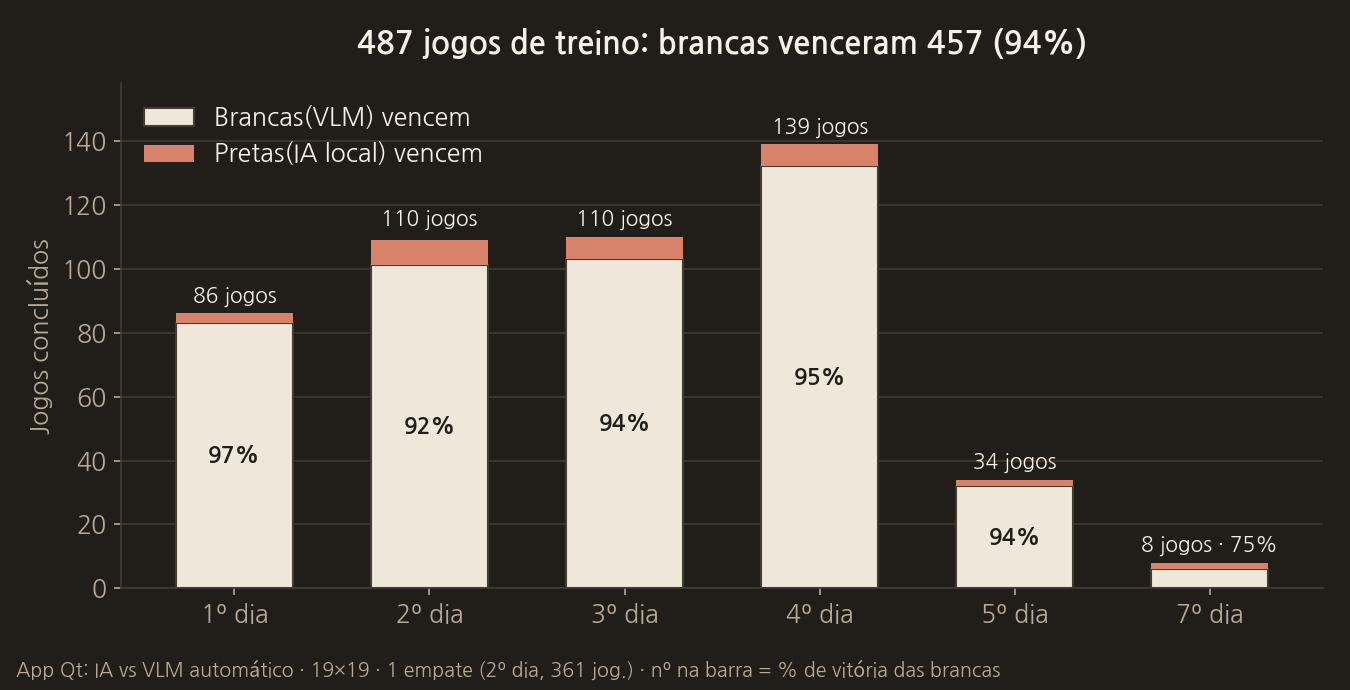
Durante uma semana, o app Qt deixou a IA local (pretas) e o VLM (brancas) jogando um contra o outro automaticamente. Das 487 partidas terminadas, as brancas venceram 457. As pretas venceram 29, e uma partida foi até a jogada 361 e terminou empatada.
O VLM erra primeiro as coordenadas
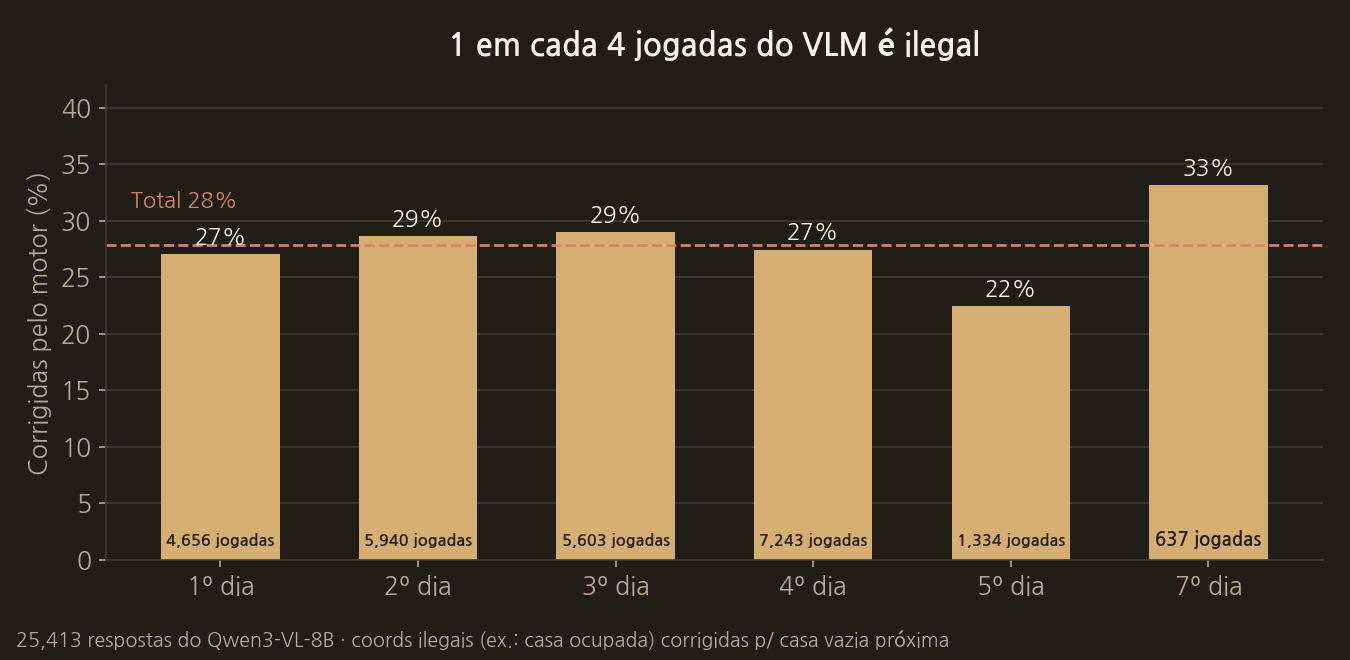
Das 25.413 jogadas escolhidas pelo VLM, 7.089 (28%) eram posições impossíveis, como casas que já tinham uma pedra. Nesse caso, o servidor pergunta de novo e, se ainda estiver errado, coloca a pedra na casa vazia mais próxima. Como diz o comentário no código, essa correção só salva a coordenada; ela não garante uma boa jogada.
O treinamento automático também estava quebrado
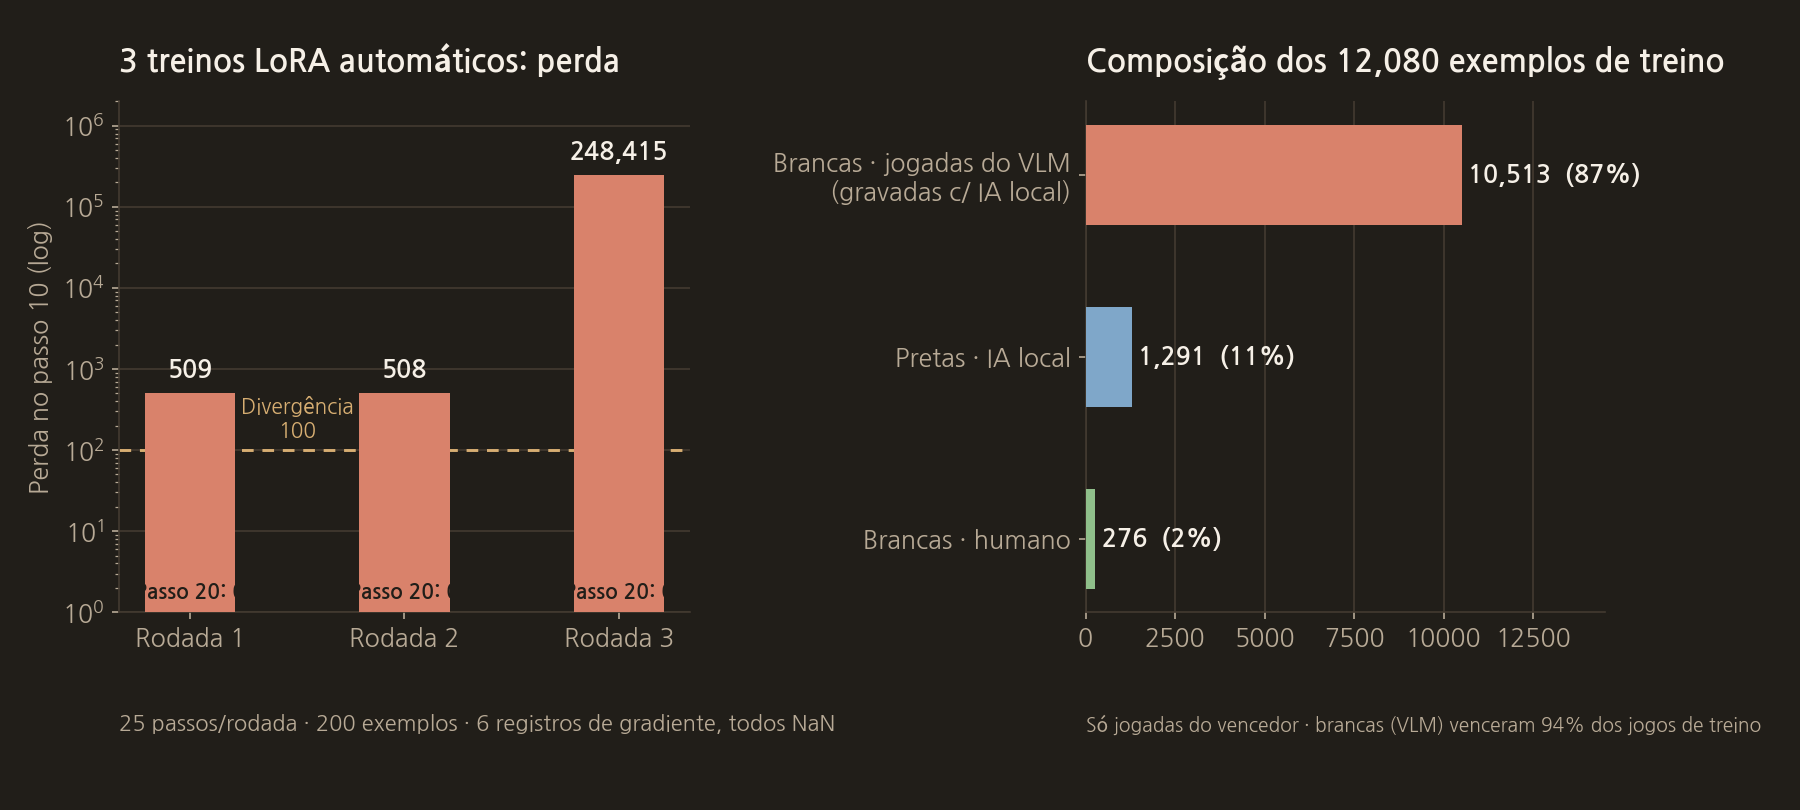
Configuramos o LoRA para ser treinado de novo com as jogadas do lado vencedor ao fim de cada partida de treinamento. Os dados chegaram a 12.080 exemplos, mas o último log de treinamento mostra a loss caindo de 248.414 para 0, com gradientes NaN. Isso significa que o treinamento não funcionou. Hoje o servidor está rodando o modelo base Qwen3-VL-2B, sem LoRA.
Há três treinamentos registrados. Todos rodaram no quinto dia de partidas automáticas, cada um usando só 200 exemplos por 25 passos. Nos três, a loss passou de 500 no passo 10 e chegou a 0 no passo 20. Os seis registros de gradiente são todos NaN. O train_vlm.py considera divergência uma loss acima de 100, e os três treinamentos passaram dessa linha.
Os dados coletados também estão desequilibrados. Dos 12.080 exemplos, 10.513 (87%) são jogadas das brancas. Isso acontece porque as brancas venceram 94% das partidas de treinamento, e essas jogadas das brancas foram feitas pelo VLM, mas registradas como jogadas da IA local. Apenas 1.291 jogadas vêm de partidas que a IA local venceu com as pretas, e só 276 de partidas vencidas por pessoas.
Resumindo, a IA de gomoku atual perde quase todas as partidas para pessoas, e o VLM ainda não aprendeu nada. A partir do próximo post, vamos passar pelas regras, pelos pontos fracos e pelo plano de correção, um de cada vez.
O código real desta etapa
Esta é a parte que move a escolha do VLM para uma casa vazia próxima quando ele escolhe uma casa impossível.
vlm_pva_server.py
if (
    not illegal_adj_fallback
    and board is not None
    and not _is_legal_vlm_move(board, r, c, size)
):
    if args.strict:
        raise RuntimeError(f"모델이 부적절 칸을 반환: ({r},{c})")
    why = _move_rejection_reason(board, r, c, size)
    if _is_opening_board(board, size):
        near = _opening_center(size)
    else:
        near = _nearest_empty(board, r, c, size=size)
    if near is None:
        raise RuntimeError("빈 칸 없음 (보드 가득 참)")
    logging.warning(
        "모델 좌표 (%d,%d) 부적절 — 사유: %s → 인접·근접 빈 칸 (%d,%d) 로 보정 "
        "(보정은 좌표 복구용 휴리스틱이라 좋은 수를 보장하지 않음)",
        r,
        c,
        why,
        *near,
    )
    r, c = near
    corrected = True
    correct_reason = why
O próximo post é "2. A regra renju deixou as brancas invencíveis".
COMMENTS · CHAPTER 01
Uma IA de gomoku que perde para pessoas 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google