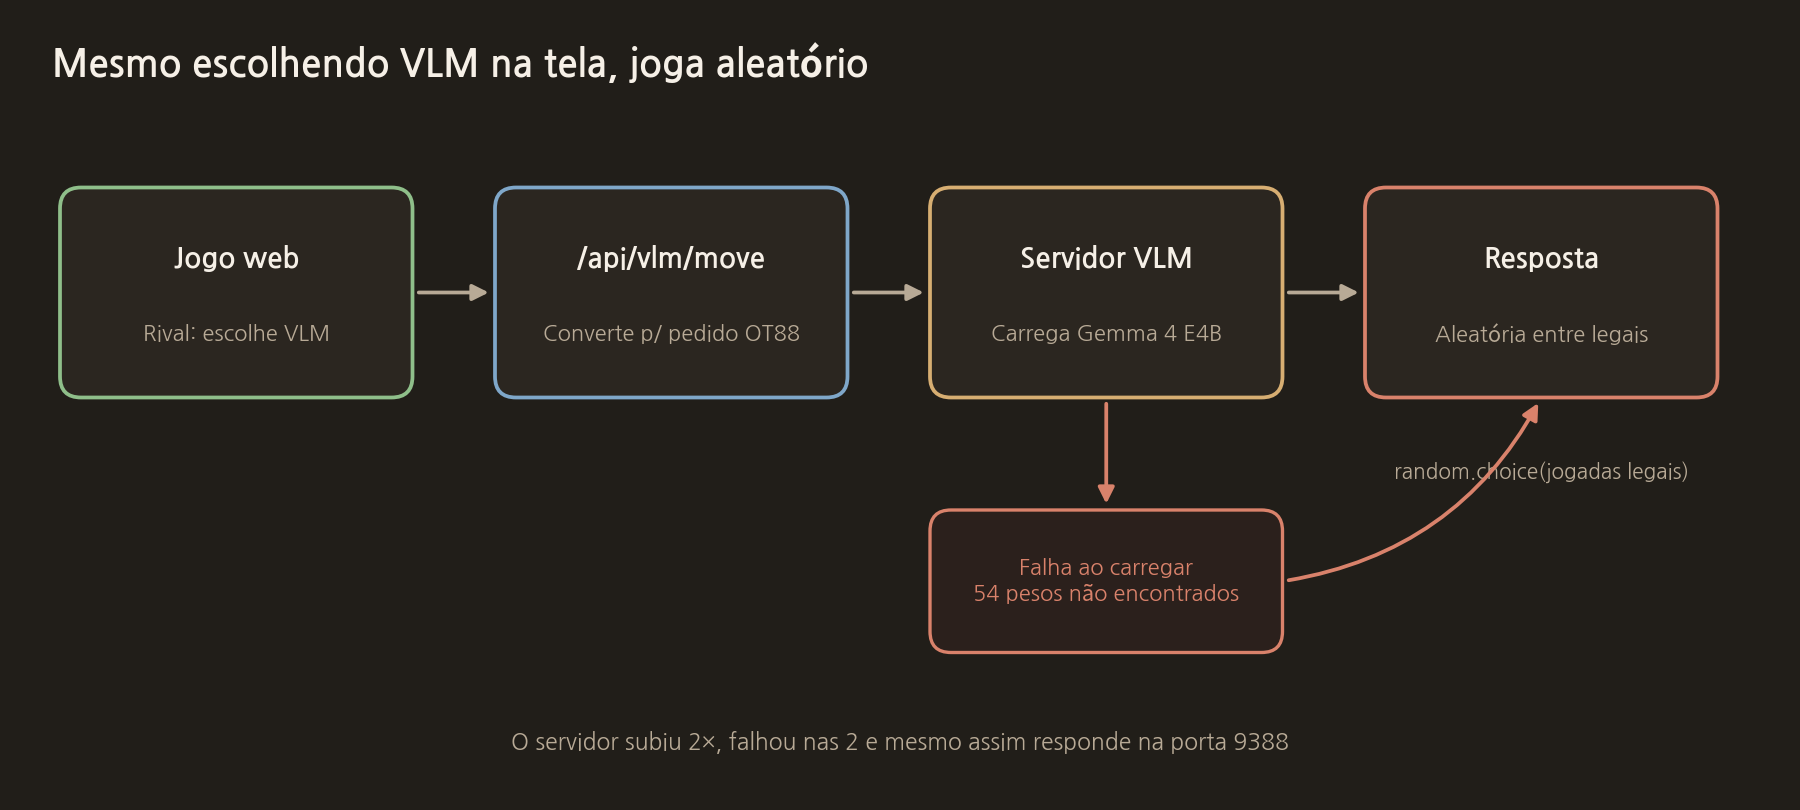
O servidor de VLM
O servidor de VLM carrega o Gemma 4 E4B (mlx 4bit) com o mlx-vlm e faz com que ele escolha uma jogada olhando a imagem e o texto do tabuleiro. Ele recebe pedidos do app em Qt e da web pelo protocolo OT88, feito na mesma estrutura do GO19 do go. O prompt inclui a lista de jogadas legais.
Falha ao carregar
O log do servidor mostra duas inicializações, e as duas falharam com o mesmo erro.
ValueError: Missing 54 parameters
Os pesos que faltam são self_attn k_proj, v_proj e k_norm das camadas 24 a 41 do modelo de linguagem. O mlx-vlm instalado é o 0.5.0. Parece que os arquivos do modelo não batem com a estrutura que o mlx-vlm espera.
O servidor sobe mesmo com a falha
Se o servidor não consegue carregar o modelo, ele passa para o "modo de jogada legal aleatória" e abre a porta mesmo assim. O script de monitoramento só verifica se a porta responde, por isso considera o servidor saudável. Ao escolher o VLM na tela, voltava uma jogada legal aleatória.
O log só tem mais de 30 mil conexões e desconexões, e não há como saber quais conexões eram pedidos de partida de verdade. É por isso que não dá para saber quantas das 31 partidas do post 1 foram contra o VLM.
Caminhos para a jogada aleatória
Mesmo depois de o modelo ser carregado, há três caminhos que trocam a jogada por uma aleatória.
- Quando ocorre um erro durante a inferência
- Quando o modelo passa a vez mesmo havendo onde jogar
- Quando o modelo escolhe uma casa onde não se pode jogar ou uma coordenada proibida
A tela da web volta para a IA local se a resposta do VLM for uma casa onde não se pode jogar. A IA local implantada hoje é a IA de uma jogada do post 2. Em qualquer caso, a tela mostra como se fosse uma jogada do VLM. No go decidimos nunca trocar às escondidas por uma jogada arbitrária, mas o Othello foi feito do jeito oposto.
O código real desta etapa
Esta é a parte que esvazia model e mantém o servidor no ar quando o carregamento falha.
vlm_server/server.py
model: Optional[_MlxVlmModel] = None
if load_model:
    model = _MlxVlmModel(model_id, max_new_tokens=max_new_tokens, temperature=temperature)
    try:
        model.start(wait_load=True)
    except BaseException as e:
        LOGGER.exception("모델 로드 실패 → 무작위 합법수 모드: %s", e)
        model = None
Esta é a parte que recebe o pedido e decide a jogada. Se não houver modelo ou se a resposta não for uma jogada legal, ela escolhe ao acaso.
vlm_server/server.py
model = self.server.model
row = col = None
is_pass = False
if model is not None:
    try:
        row, col, is_pass = model.predict_move(
            img, board, ai_side, legal, forbidden=list(bans), timeout_s=180.0
        )
    except Exception as e:
        LOGGER.warning("VLM 추론 실패, 합법수 무작위: %s", e)
        row = col = None
        is_pass = False

if is_pass:
    LOGGER.info("모델 PASS (합법수 있음) → 합법수 무작위")
    row = col = None

if row is None or col is None or (row, col) not in legal or (row, col) in bans:
    if row is not None and col is not None:
        LOGGER.info("불법/금지 (%s,%s) → 합법수 무작위", row, col)
    pick = _choose_legal(legal, bans)
    if pick is None:
        _send_pass(sock)
        continue
    row, col = pick

# ...

def _choose_legal(
    legal: list[tuple[int, int]], forbidden: set[tuple[int, int]]
) -> Optional[tuple[int, int]]:
    remain = [m for m in legal if m not in forbidden]
    pool = remain or legal
    if not pool:
        return None
    return random.choice(pool)
O próximo post é "4. Um plano para levar ao Othello o que aprendemos com o go e o gomoku".
COMMENTS · CHAPTER 03
O VLM nunca fez uma jogada: falha ao carregar o Gemma 4 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google