Por que falhou no começo
O modelo inicial respondia coordenadas do canto inferior direito do tabuleiro com frequência exagerada. Parecia falta de registros de partidas, mas a causa real era o formato da entrada. Os dados de treinamento usavam um tabuleiro alinhado com números, enquanto o servidor real enviava um tabuleiro com espaçamento diferente. Em especial, a partir do ponto em que os números das colunas passavam a ter dois dígitos, o modelo lia a posição das pedras com uma casa de diferença.
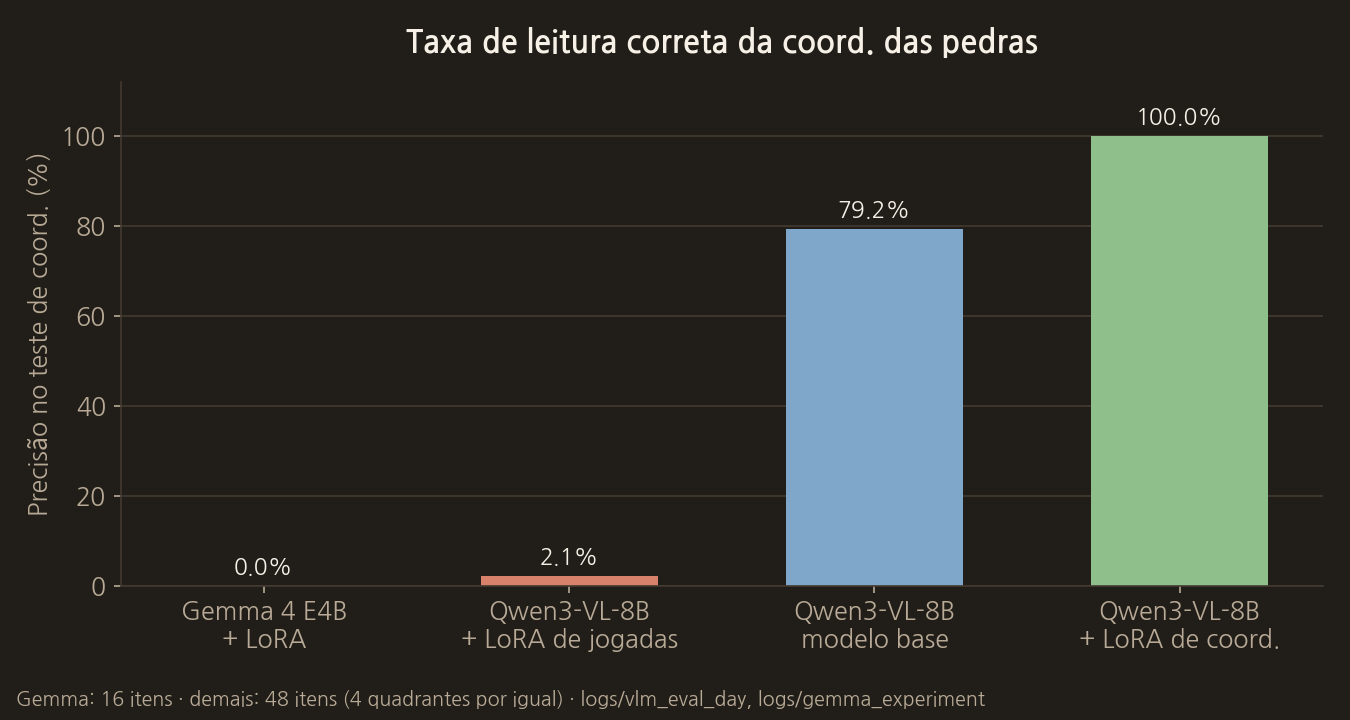
O primeiro modelo, o Gemma 4 E4B com LoRA, não acertou nenhuma das 16 questões do teste de coordenadas. Mesmo depois de trocar para o Qwen3-VL-8B, um adaptador treinado rapidamente com apenas 400 exemplos de jogadas caiu para 2,1%. Por isso, criamos primeiro um adaptador só para coordenadas e treinamos as jogadas em cima dele.
Etapa 1: Fixar a largura das coordenadas
Linhas e colunas são escritas com dois dígitos, como 00, 01, 02, e não 0, 1, 2. Pontos vazios, pedras pretas e pedras brancas também ficam fixados em um caractere cada, e o número de espaços de separação nunca muda. Mesmo que a função que gera os dados de treinamento e a função que monta as requisições das partidas reais sejam separadas, o mais seguro é que elas compartilhem um único gerador da string final.
- Imprimir os cabeçalhos das colunas de 00 a 18.
- Colocar também um número de 00 a 18 na frente de cada linha.
- Deixar os símbolos de vazio, preta e branca com a mesma largura.
- Escrever a vez atual e os pontos proibidos em uma posição fixa abaixo do tabuleiro.
Etapa 2: Passar primeiro no teste de coordenadas
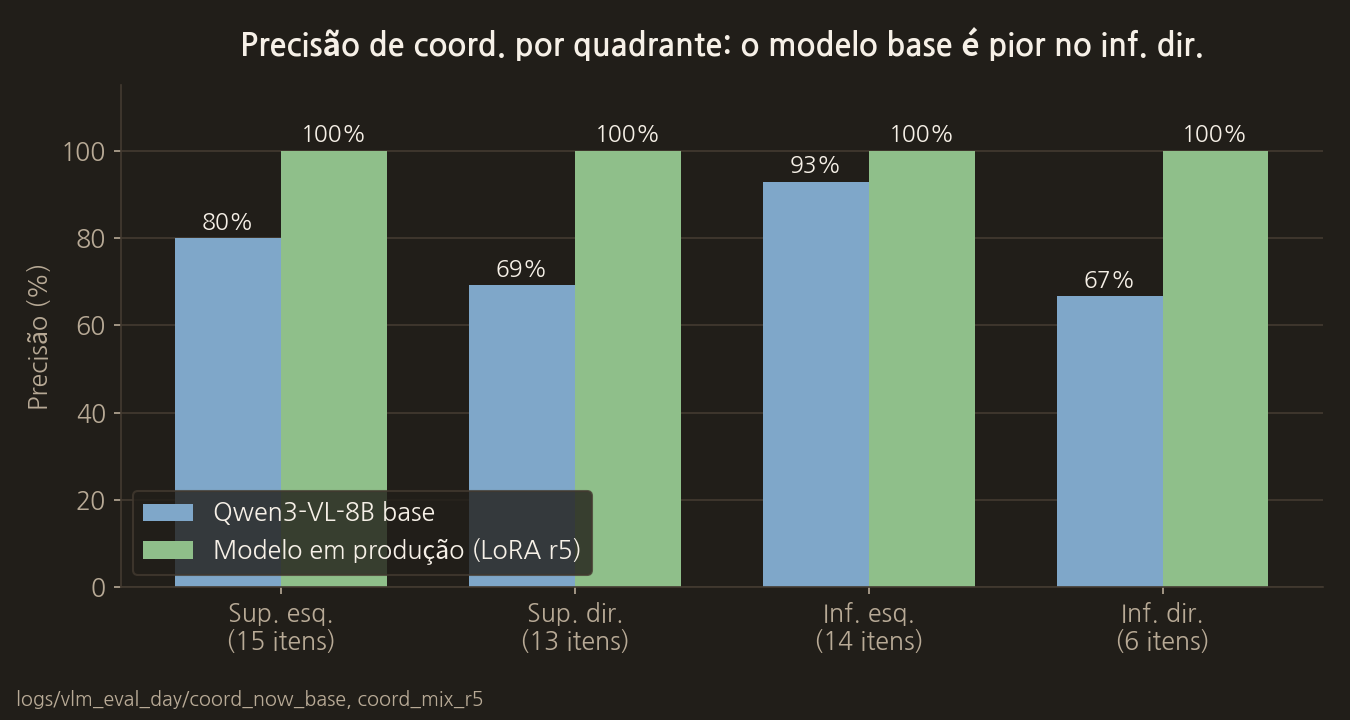
Antes de treinar a força de jogo, coloque uma pedra em um ponto aleatório e peça ao modelo que responda a coordenada. Não teste só o centro; crie o mesmo número de questões em cada uma das quatro áreas: superior esquerda, superior direita, inferior esquerda e inferior direita. Mesmo com precisão geral alta, se só o canto inferior direito for fraco, as partidas reais vão mostrar um viés de direção.
Até o Qwen3-VL-8B base teve sua menor precisão, 66,7%, no canto inferior direito entre as quatro áreas.
Rode o teste de coordenadas de novo sempre que treinar o modelo outra vez ou mudar o prompt. Salve a direção das respostas erradas junto com a taxa de acerto. Dependendo de ele errar repetidamente uma casa para a direita ou trocar linhas e colunas, dá para verificar separadamente o alinhamento da entrada e o parser da saída.
Etapa 3: Restringir o formato da saída
Quando o modelo responde com uma explicação longa, o parser de coordenadas fica instável. A saída normal é limitada a uma única coordenada ou PASS. Usar escondido só a primeira coordenada quando vem uma explicação junto pode ocultar jogadas erradas, então isso é registrado como erro de formato e a requisição é repetida apenas um número fixo de vezes.
Enquanto a precisão das coordenadas não estiver garantida, colocar mais registros de partidas pode só reforçar o hábito de ler errado.
O código real desta etapa
Este é o gerador da string do tabuleiro que deixa os cabeçalhos das colunas, os números das linhas e os símbolos das pedras todos com dois caracteres de largura. Tanto a geração dos dados de treinamento quanto o servidor real de recomendação de jogadas usam esta função, para que os formatos de entrada nunca fiquem diferentes.
vlm_server/dataset_baduk.py
def board_text_aligned(cells: bytes, size: int = BOARD_SIZE) -> str:
    """v3 권장: 열·행·셀이 모두 두 글자 토큰으로 정렬.

    셀 기호는 **왼쪽 정렬** (``X `` / ``. ``). 오른쪽 정렬(`` X``)은
    모델이 열을 한 칸 왼쪽(col-1)으로 읽는 오차를 유발했다.
    """
    col_header = "   " + " ".join(f"{c:02d}" for c in range(size))
    lines: List[str] = [col_header]
    for r in range(size):
        cells_s: List[str] = []
        for c in range(size):
            v = cells[r * size + c]
            ch = "." if v == 0 else ("X" if v == 1 else "O")
            cells_s.append(f"{ch:<2}")
        lines.append(f"{r:02d} " + " ".join(cells_s))
    return "\n".join(lines)
A saída correta do modelo é limitada a uma linha de JSON contendo apenas uma coordenada ou um passe.
vlm_server/dataset_baduk.py
def assistant_text(point: Optional[Tuple[int, int]]) -> str:
    if point is None:
        return '{"pass": true}'
    r, c = point
    return f'{{"row": {r}, "col": {c}}}'
Modelo usado: Qwen3-VL-8B-Instruct + adaptador LoRA (lora_mix_qwen_r5). O código-fonte completo e a descrição do modelo estão no post "8. O código-fonte completo e os modelos usados".
COMMENTS · CHAPTER 03
Transformando um tabuleiro 19×19 em uma entrada que a IA consegue ler 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google