Ações macro
O MacroPlanningTetrisEnv coloca uma peça até o fim com uma única ação. O número da ação é coluna-alvo×4 + rotação-alvo, 40 no total. Dentro do ambiente, primeiro a rotação é ajustada, depois a peça é movida para a esquerda ou para a direita e solta de vez. As mais de 20 decisões por peça viram uma só, e a recompensa por eliminar linhas fica ligada diretamente à ação que escolheu aquela peça.
Resultados
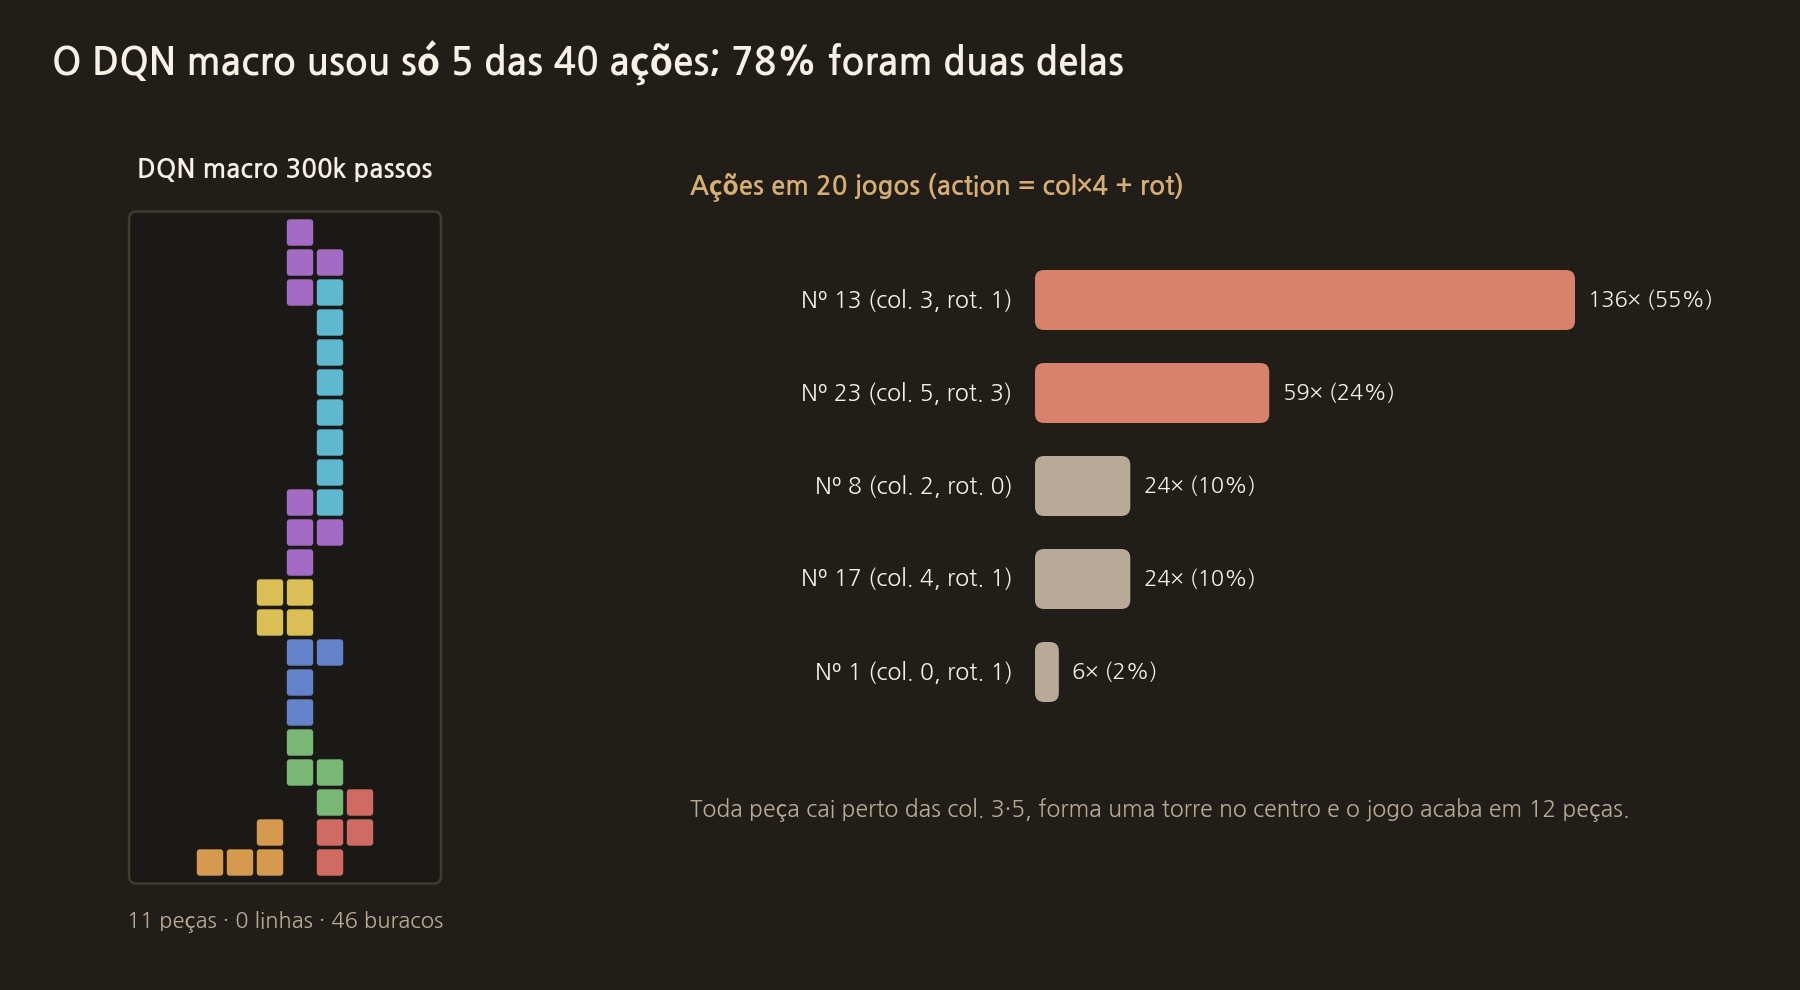
O DQN macro (dqn.zip) foi treinado por 300 mil passos, ou seja, 300 mil peças. Estes são os resultados de 20 partidas com as mesmas seeds.
- Macro aleatório: média de 25 peças, 0 linhas
- DQN macro: média de 12 peças, 0 linhas
Ele termina mais cedo que o aleatório. Nas 20 partidas, escolheu só 5 tipos de ação, e as ações 13 (coluna 3, rotação 1) e 23 (coluna 5, rotação 3) somam 78%. Ele solta as peças em dois lugares no meio, independentemente do tipo de peça.
A representação das ações bloqueou a coluna mais à esquerda
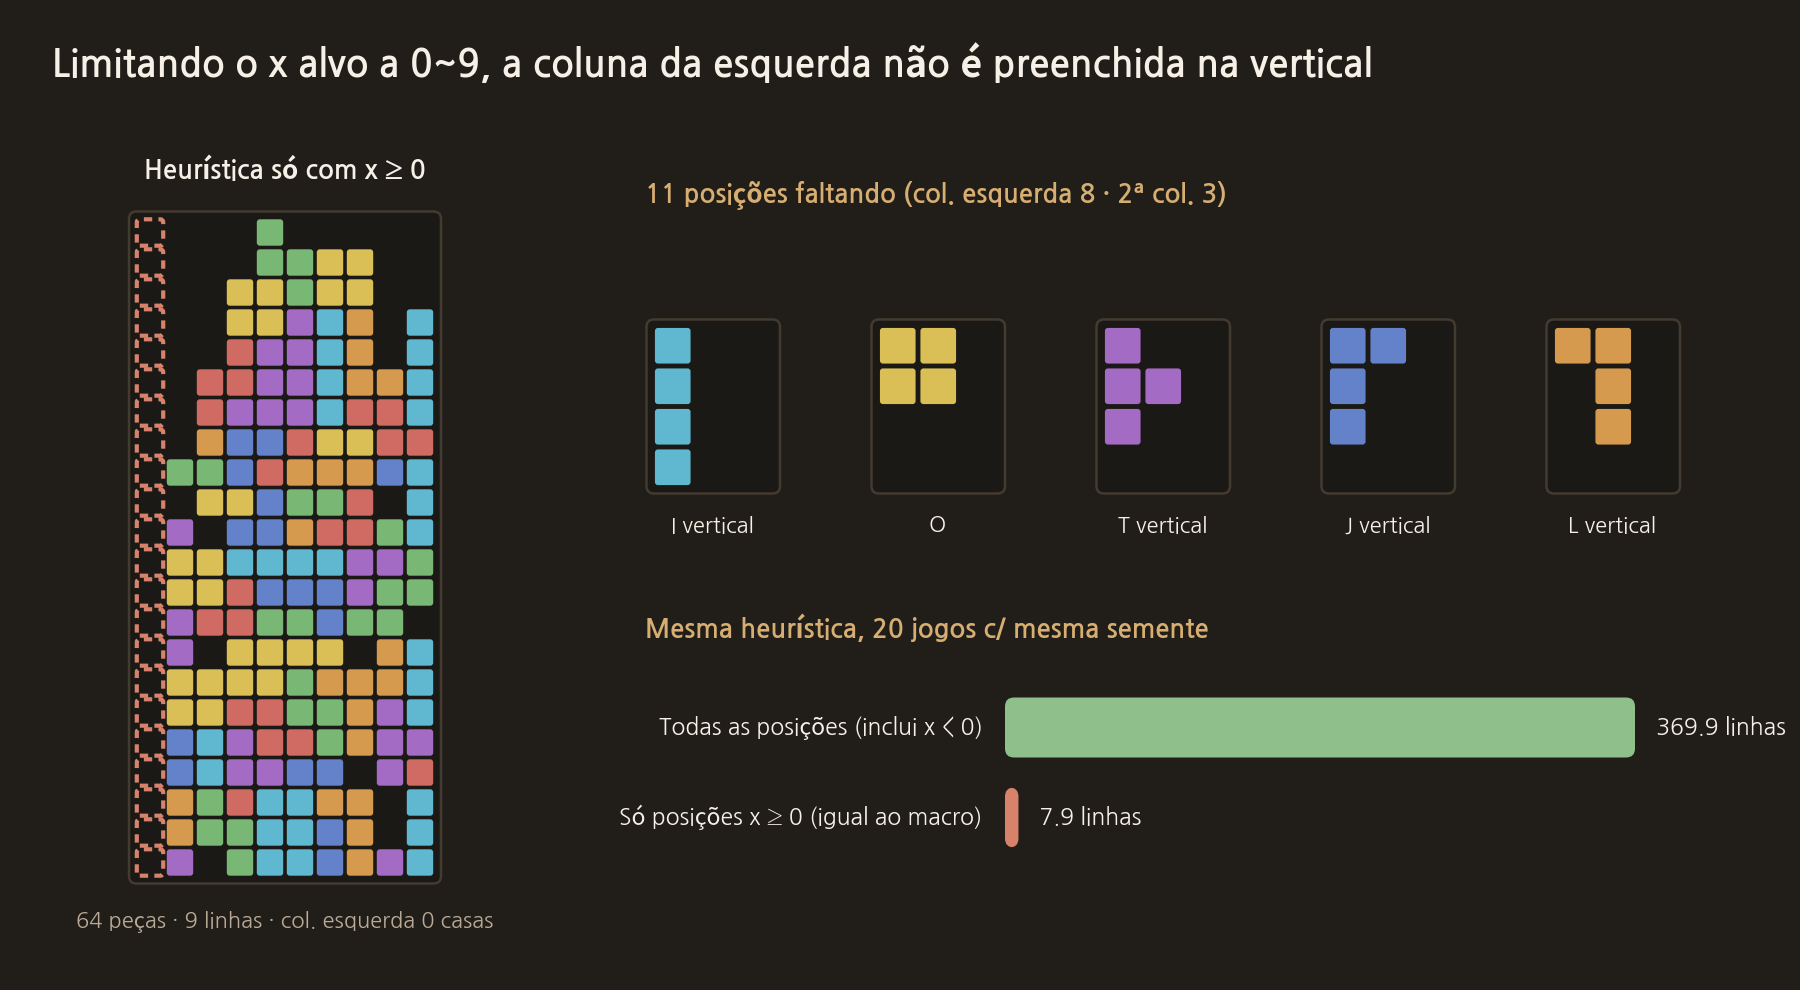
A forma das peças é desenhada dentro de uma caixa 4×4, e o x do motor é a borda esquerda dessa caixa. O I vertical fica na terceira casa da caixa, então para colocá-lo na coluna mais à esquerda o x precisa ser -2. As ações macro limitam a coluna-alvo a 0–9, então esses lugares não podem ser escolhidos.
Há 162 lugares no total onde as sete peças podem ser colocadas, e 151 deles podem ser escolhidos com as 40 ações. Os 11 que faltam são os de colocar um I vertical, um O ou um T, J ou L vertical na coluna mais à esquerda (8) e na segunda coluna (3).
Aplicamos a mesma restrição ao planejador heurístico que aparece no post 5. Usando todos os lugares, ele elimina em média 370 linhas em 20 partidas; usando só lugares com x igual ou maior que 0, 7,9 linhas. Quando a coluna mais à esquerda vira um poço, não há peça para preenchê-la, e essa coluna fica vazia até o fim.
O MoE que ordena os candidatos por regras (moe_macro_policy.py) também rodava sobre essas 40 ações e ficou em apenas 12,4 linhas em média. No tabuleiro final do MoE, a coluna mais à esquerda também está quase toda vazia.
Recompensas do VLM
Tentamos compensar a escassez de recompensas por linha com um VLM. O LLMRewardWrapper desenha o tabuleiro como imagem a cada 10 passos, mostra ao Qwen2.5-VL-3B e recebe em JSON uma nota de -1 a 1 e a próxima ação. A recompensa de treino é a recompensa do motor + 0,2×nota. Os outros 9 passos reaproveitam a nota anterior. A ação recomendada só é registrada, não é usada. Um juiz Qwen2.5-3B (GGUF) que lê o tabuleiro em texto também está incluído com a mesma estrutura.
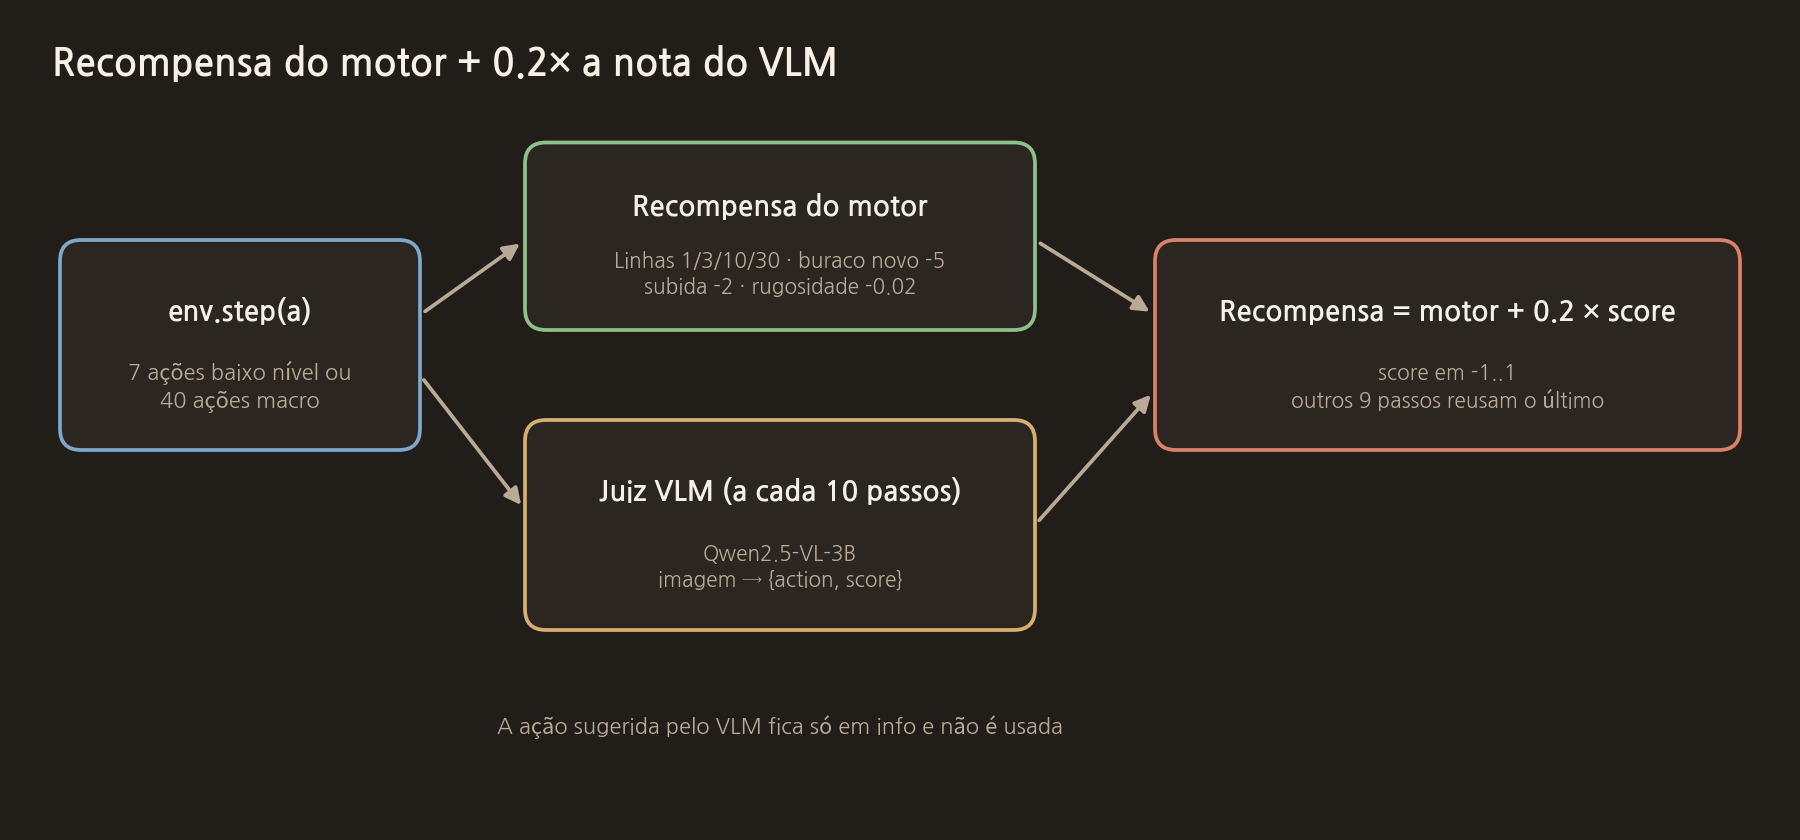
Não restou nenhum resultado de treino com essa recompensa ativada. O DQN macro foi salvo antes do código de recompensa do VLM, e não há registro de com qual configuração de recompensa o modelo de baixo nível de 370 mil passos foi treinado.
Então testamos o juiz sozinho. Depois de avançar um tabuleiro até a metade com a heurística, mostramos, no mesmo tabuleiro, o resultado de colocar a peça no lugar mais bem classificado e no pior classificado. O pior lugar cria em média 7,0 buracos novos.
- Nota média em 15 pares: melhor lugar -0,77, pior lugar -0,79
- Pares em que o melhor lugar recebeu nota maior: 4; nota igual: 10; nota menor: 1
- Todas as notas recebidas foram -0,8 ou -0,7
Somando com peso 0,2, só se acrescenta a mesma penalidade de cerca de -0,15 a quase todos os passos, sem transmitir nada sobre se o lugar é bom ou ruim.
O código real desta etapa
Isto desdobra uma ação macro em ações de baixo nível e coloca uma peça. A linha que limita a coluna-alvo a 0–9 é a que bloqueou a coluna mais à esquerda.
macro_planning_env.py
def step(self, action: int):
    target_rot = int(action) % 4
    target_col = int(action) // 4
    if target_col < 0 or target_col >= self._w:
        target_col = int(np.clip(target_col, 0, self._w - 1))

    start_pi, _, _, _, _ = self._piece_state()
    total_reward = 0.0
    terminated = truncated = False
    info: dict[str, Any] = {}

    for _ in range(self._max_micro_steps):
        pi, ptype, px, py, prot = self._piece_state()
        if self._micro._lib._dll.tetris_game_over(self._micro._h):
            obs = self._micro._obs()
            terminated = True
            info = {
                "lines_cleared_total": int(
                    self._micro._lib._dll.tetris_lines_cleared_total(self._micro._h)
                ),
                "piece_index": int(self._micro._lib._dll.tetris_piece_index(self._micro._h)),
                "macro_steps": _ + 1,
            }
            return obs, total_reward, terminated, truncated, info

        if pi > start_pi:
            break

        if self._controller is not None:
            # RL low-level controller (Discrete(7))
            micro_a, _ = self._controller.predict(obs, deterministic=True)
            micro = int(micro_a)
        else:
            micro = next_micro_for_target(ptype, prot, px, target_rot, target_col)
        obs, r, terminated, truncated, info = self._micro.step(micro)
        total_reward += float(r)
        if terminated or truncated:
            info = dict(info)
            info["macro_steps"] = _ + 1
            return obs, total_reward, terminated, truncated, info
Esta é a parte que soma a nota do VLM à recompensa.
llm_reward_wrapper.py
def step(self, action: int):
    self._last_action = int(action)
    obs, reward, terminated, truncated, info = self.env.step(action)

    # LLM judge uses obs after action
    next_action, score = self.teacher.judge_and_suggest(obs, self._last_action, dict(info))
    shaped = float(reward) + float(self.cfg.alpha) * float(score)

    info = dict(info)
    info["llm_score"] = float(score)
    info["llm_next_action"] = int(next_action)
    info["reward_env"] = float(reward)
    info["reward_shaped"] = float(shaped)

    return obs, shaped, terminated, truncated, info
O próximo post é "4. Deixando o VLM escolher diretamente o lugar da peça".
COMMENTS · CHAPTER 03
Ações macro escolhidas uma vez por peça e recompensas do VLM 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google