Configuração do treino
- Algoritmo: DQN do stable-baselines3. Taxa de aprendizado 1e-4, replay buffer de 100 mil, batch 32, treino a cada 4 passos e rede-alvo atualizada a cada 10 mil passos.
- Exploração: nos primeiros 20%, a taxa de aleatoriedade cai de 1 para 0,02.
- Rede de política: como os valores da observação vão de 0 a 7, o SB3 não os trata como imagem e escolhe a MlpPolicy. As 220 casas do tabuleiro entram achatadas em uma linha.
Recompensa
Calculada toda vez que uma peça trava.
- Eliminar linhas: 1 linha 1 ponto, 2 linhas 3, 3 linhas 10, 4 linhas 30
- Um pouco mais quanto mais baixo a peça for colocada (altura de pouso×0,1)
- -5 para cada buraco novo
- -2 para cada casa que a altura da pilha subir
- Subtrai-se a irregularidade (soma das diferenças de altura entre colunas vizinhas)×0,02 e a altura da pilha×0,03
Resultados
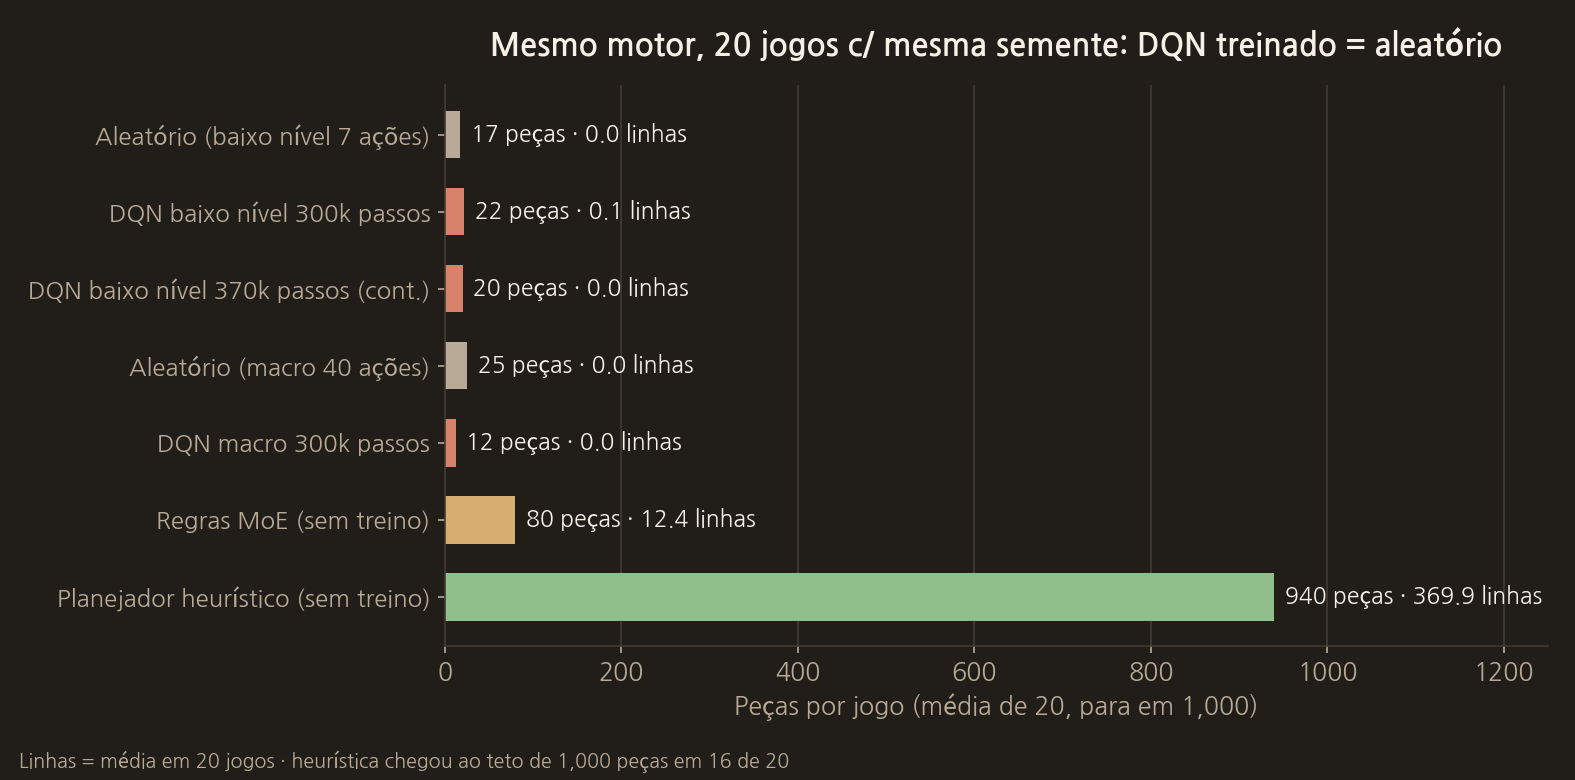
Restam dois modelos de baixo nível: o modelo de 300 mil passos (live_latest.zip.bak) e o modelo de 370 mil passos treinado a partir dele (live_latest.zip). O treino continuado começou com a meta de 620 mil passos, mas parou em 370 mil.
Rodamos 20 partidas com as seeds 0 a 19 no mesmo motor. O modelo sempre escolheu a ação de maior valor.
- 7 ações aleatórias: média de 17 peças, 0 linhas
- DQN 300 mil passos: média de 22 peças, 2 linhas no total das 20 partidas
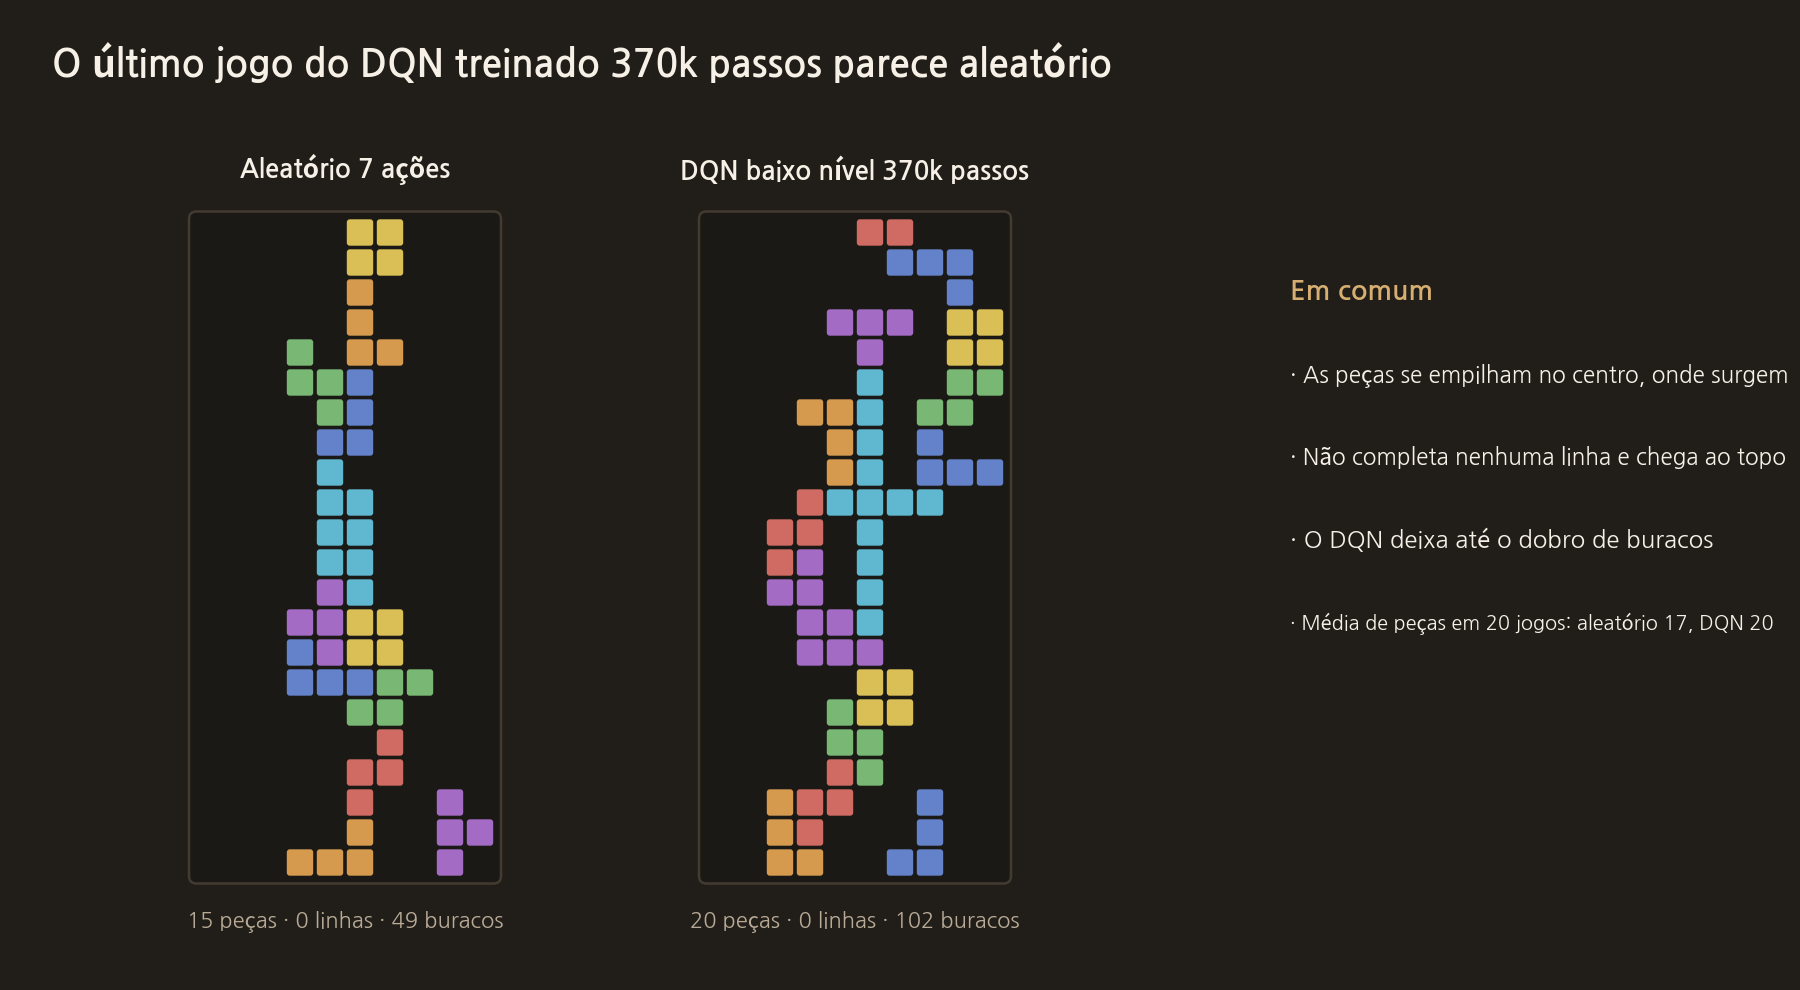
- DQN 370 mil passos: média de 20 peças, 0 linhas
Por que não aprendeu
- Ele quase nunca vê a recompensa por linha. Apertando ao acaso, não se elimina nenhuma linha em 20 partidas. Para eliminar uma linha é preciso encaixar várias peças, o que raramente acontece durante a exploração. Os sinais que entram no treino são quase só as penalidades de buraco e de altura.
- Uma peça consome mais de 20 ações. Só se sabe se o lugar foi bom no momento em que a peça trava, e é difícil dizer qual dos movimentos e rotações anteriores acertou.
- Um MLP pequeno olha 220 números achatados. É difícil para ele ler a forma das peças e as relações de posição, e ele também não conhece a próxima peça.
Por isso reduzimos as ações para uma por peça e pusemos um VLM para ajudar na recompensa.
O código real desta etapa
Esta é a recompensa que o motor calcula quando uma peça trava.
tetris/src/tetris_engine.cpp
// Line clear reward (non-linear scaling)
double line_r = 0.0;
switch (cleared) {
    case 1: line_r = cfg_.line_reward_1; break;
    case 2: line_r = cfg_.line_reward_2; break;
    case 3: line_r = cfg_.line_reward_3; break;
    case 4: line_r = cfg_.line_reward_4; break;
    default: break;
}

// Height reward: lower placement = higher reward
double height_r = cfg_.height_reward_scale * landing_y;

const int holes_after = count_holes();
const int new_holes = holes_after - holes_before;
double hole_penalty = 0.0;
if (new_holes > 0) {
    hole_penalty = cfg_.hole_penalty_scale * static_cast<double>(new_holes);
}

// Stack height penalty: penalize increases of the board height (after line clears)
double height_penalty = 0.0;
if (cfg_.stack_height_penalty_scale > 0.0) {
    const int height_after = stack_height();
    const int dh = height_after - height_before;
    if (dh > 0) {
        height_penalty = cfg_.stack_height_penalty_scale * static_cast<double>(dh);
    }
}

// Surface shaping penalties (post line-clear)
double bump_penalty = 0.0;
if (cfg_.bumpiness_penalty_scale > 0.0) {
    bump_penalty = cfg_.bumpiness_penalty_scale * static_cast<double>(bumpiness());
}
double max_height_penalty = 0.0;
if (cfg_.max_height_penalty_scale > 0.0) {
    max_height_penalty = cfg_.max_height_penalty_scale * static_cast<double>(stack_height());
}

last_reward_ += line_r + height_r - hole_penalty - height_penalty - bump_penalty - max_height_penalty;
Estes são os valores da recompensa e a configuração do DQN.
config/rl_config.py
    # ── 보상/패널티 스케일 (C++ 엔진으로 전달) ───────────────────────────────
    # 한쪽으로 몰빵되는 탑쌓기를 억제하려면 아래 2개를 켜는 게 효과적
    stack_height_penalty_scale: float = 2.0   # 스택 높이 "증가분" 패널티 (권장 0.5~5.0)
    # bumpiness는 값 범위가 커서(최대 수백) 스케일을 너무 크게 주면 보상이 붕괴합니다.
    bumpiness_penalty_scale: float = 0.02     # 인접 열 높이 차이 합 패널티 (권장 0.005~0.05)
    max_height_penalty_scale: float = 0.03    # 절대 스택 높이 패널티 (권장 0.0~0.1)


@dataclass(frozen=True)
class DQNConfig:
    timesteps: int = 300_000
    learning_rate: float = 1e-4
    buffer_size: int = 100_000
    batch_size: int = 32
    train_freq: int = 4
    target_update_interval: int = 10_000
    exploration_fraction: float = 0.2
    exploration_final_eps: float = 0.02
O próximo post é "3. Ações macro escolhidas uma vez por peça e recompensas do VLM".
COMMENTS · CHAPTER 02
DQN por 370 mil passos, zero linhas eliminadas 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google