A heurística original
A heurística de go começava colocando uma pedra no centro e continuava jogando só no centro, enrolando-se como uma cobra. Muitas vezes ela vencia respondendo às jogadas da IA e provocando as reações estranhas que a IA tinha na época. Era mais um amontoado de pedras do que inteligência.
Corrigindo contra o R5
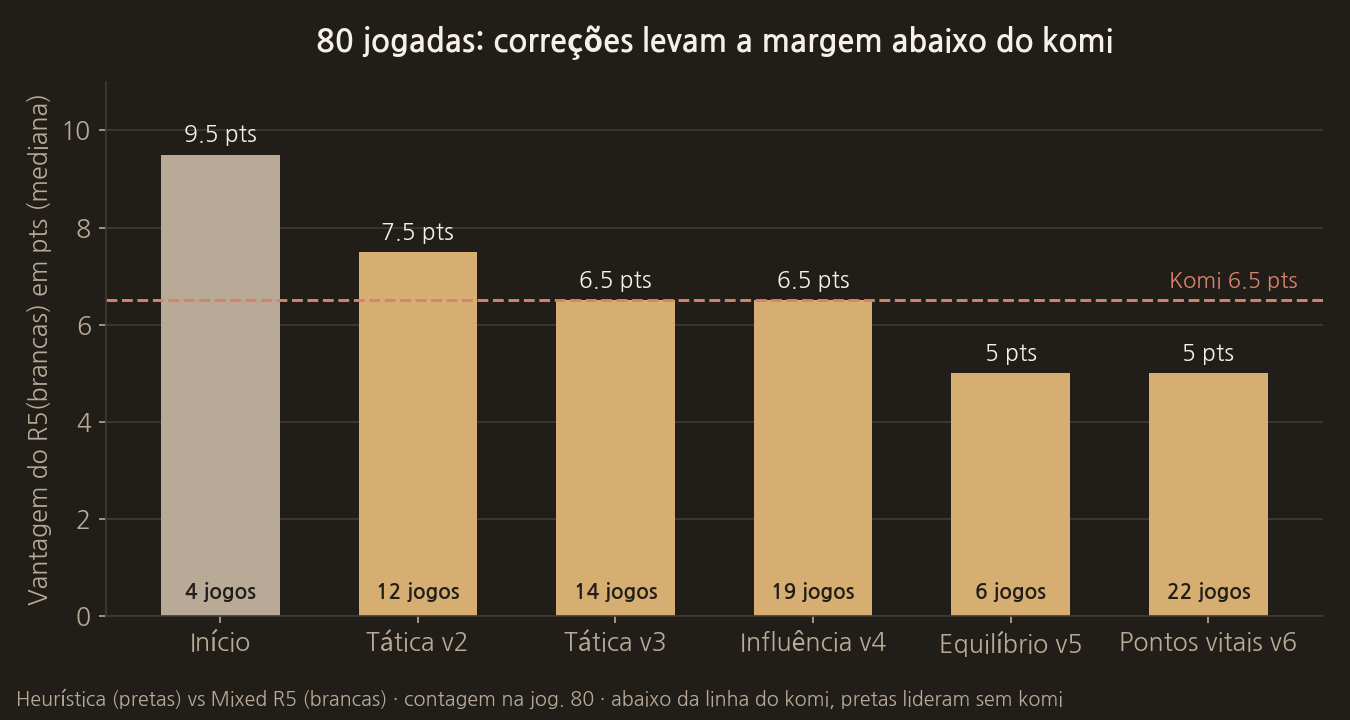
Então começamos a corrigir a heurística contra o Mixed R5, o modelo treinado mais recentemente. A heurística ficou com as pretas e o R5 com as brancas; eles jogaram até a jogada 80 e então a partida foi contada. Fizemos cinco correções em um dia.
- Tática: capturar as pedras que podem ser capturadas, salvar as pedras em atari e evitar jogadas que entram sozinhas em atari.
- Abertura: até a jogada 70, jogar primeiro na 3ª e 4ª linhas dos cantos e evitar a 1ª e 2ª linhas e o espalhamento sem motivo no centro. O enrolamento no centro desapareceu aqui.
- Influência: preferir jogadas ligadas de forma folgada às próprias pedras, como saltos de uma casa, movimentos de cavalo e extensões de duas casas.
- Pontos vitais: se houver uma pedra em atari que pode ser salva, salvá-la antes de qualquer outra jogada.
- Erros vistos nas partidas contra o R5: penalizar jogadas na boca de tigre, escadas inúteis, preencher o próprio território e duplos ataris próximos.
Depois das correções, a heurística logo se acertou, e agora parecia jogar melhor que o R5. Por causa do limite de 80 jogadas, as brancas ainda venciam pelo komi, mas a disputa ficou quase empatada. A última versão perdeu 21 de 22 partidas, mas a mediana da vantagem do R5 foi de 5 pontos, menor que o komi de 6,5 pontos. Em 12 das 22 partidas, a heurística estava à frente sem contar o komi. Na prática, sem o komi, o R5 teria perdido.
Aumentando o limite de jogadas e fazendo um aprender com o outro
Então aumentamos o limite para 150 jogadas e fizemos um confronto de 100 partidas seguidas. Nas 78 partidas que ficaram registradas, a heurística ficou à frente com 47 vitórias e 31 derrotas.
Em seguida, aplicamos o conteúdo das partidas diretamente na heurística e no R5. Das jogadas feitas por um lado, só as capturas, as jogadas que salvaram pedras em atari e as escadas que realmente capturaram são selecionadas e passadas ao outro lado como pontos de bônus. PASS, suicídio, boca de tigre e escadas inúteis não são repassados, e as jogadas do lado vencedor contam em dobro. Depois de fazer um aprender com o outro dessa forma, em 189 partidas de 150 jogadas a heurística teve 125 vitórias e 64 derrotas.
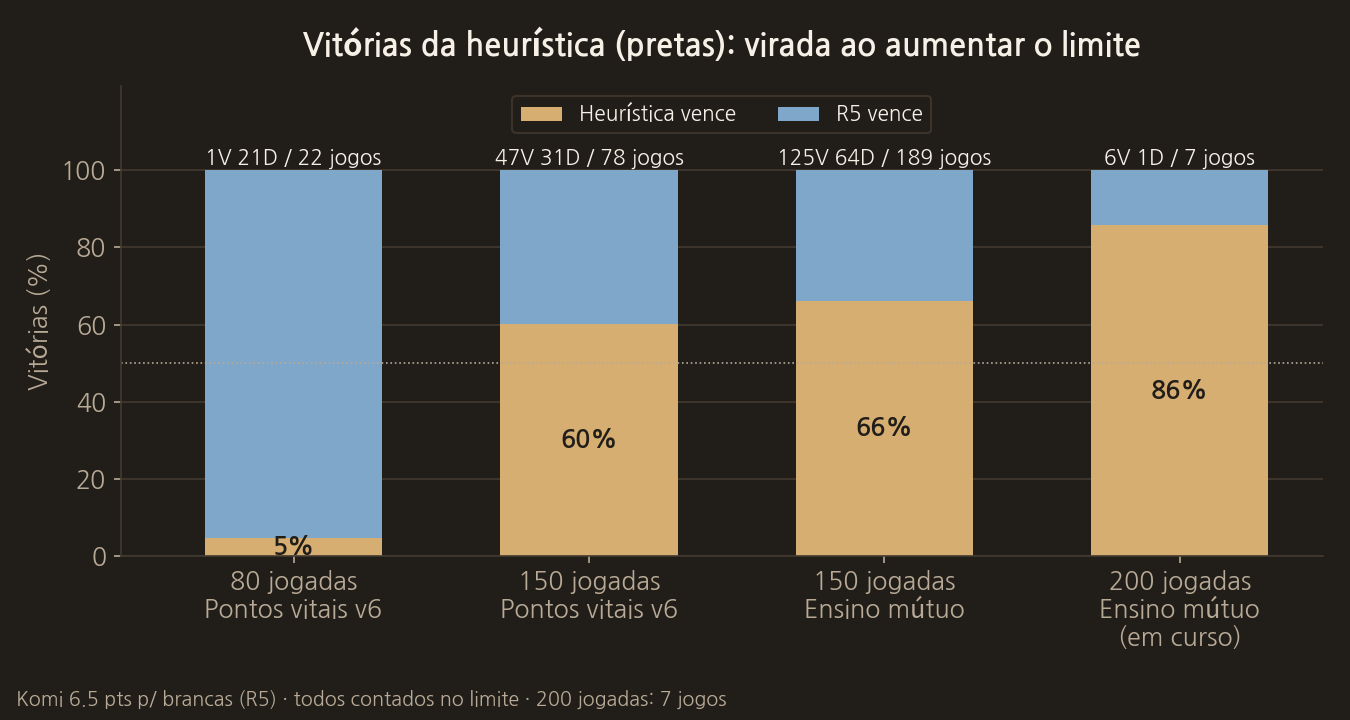
Agora estamos rodando 40 partidas com o limite aumentado para 200 jogadas. O resultado ainda não saiu, mas mudanças surpreendentes começaram a aparecer na heurística e no R5. Das 7 partidas terminadas até agora, a heurística venceu 6.
A heurística virou professora
Contando os pontos de bônus repassados em cada direção, foram muito mais da heurística para o R5. O R5 aprendeu capturas e escadas com a heurística, enquanto a heurística aprendeu com o R5 principalmente jogadas que salvam pedras em atari.
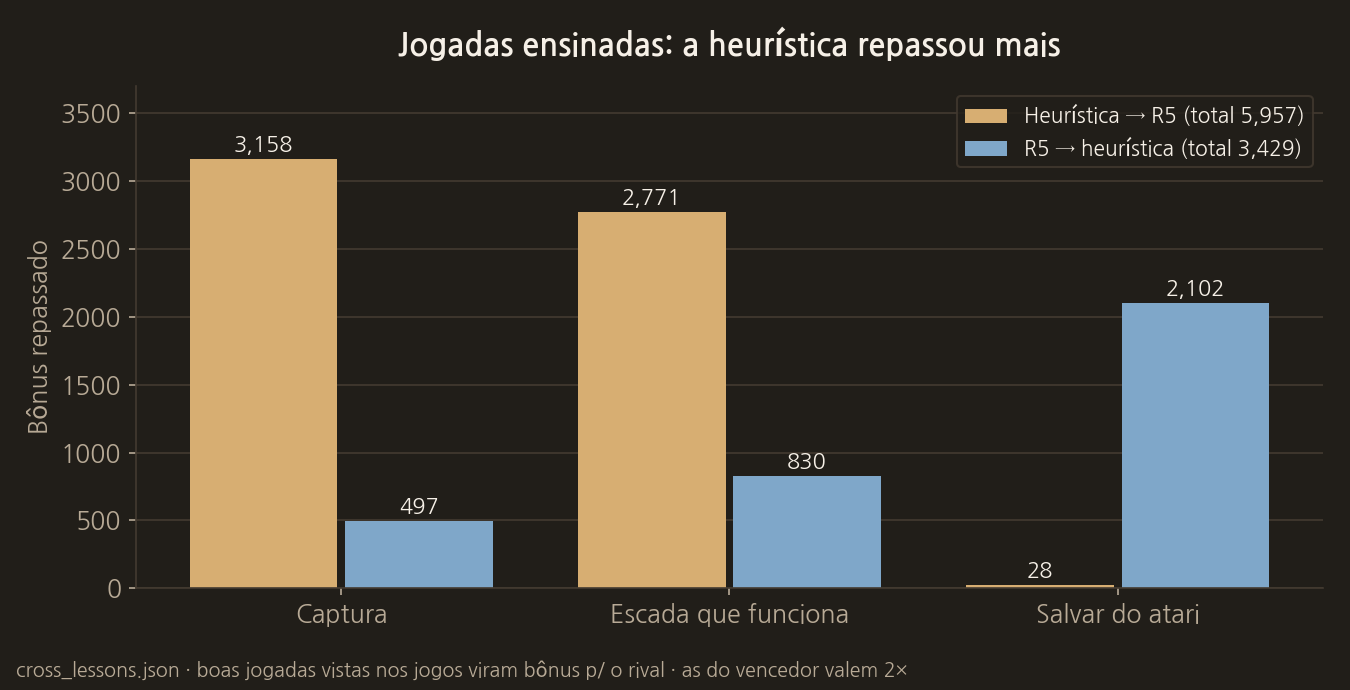
Na prática, a heurística está servindo de professora para ensinar o R5. De certa forma, uma heurística escrita com regras está produzindo jogadas melhores do que a inteligência artificial treinada.
Todas as partidas usam uma contagem de referência que para no limite de jogadas e conta apenas o território e as pedras capturadas. A vida e morte das pedras mortas não foi julgada.
O código real desta etapa
Esta parte acumula as boas jogadas de um lado na tabela do outro lado. As jogadas das pretas (a heurística) vão para o R5, as jogadas das brancas (o R5) vão para a heurística, e as jogadas do vencedor contam em dobro.
vlm_server/cross_lessons.py
def absorb_move(book: dict, actor: str, tags: Iterable[str], winner: Optional[str]) -> None:
    """actor 가 둔 좋은 수를 상대 테이블에 넣는다. actor 는 black|white."""
    tags = [t for t in tags if t in ("capture", "atari_save", "working_chase")]
    if not tags:
        return
    if actor == "white":
        target = "to_heuristic"
        weight = 2 if winner == "white" else 1
    else:
        target = "to_r5"
        weight = 2 if winner == "black" else 1
    _add_tags(book, target, tags, weight)
Esta parte coloca na pontuação da heurística os erros encontrados nas partidas contra o R5. Boca de tigre e escadas inúteis recebem uma penalidade grande, e as escadas que realmente capturam recebem pontos de bônus na medida do que foi aprendido.
vlm_server/cross_lessons.py
def r5_live_delta(board, r: int, c: int, who: int) -> int:
    cells = _cells(board)
    score = 0
    hogu = hogu_verdict(cells, r, c, who)
    if hogu == "hogu_entry":
        score -= 9000
    elif hogu == "hogu_fill":
        score -= 2000
    if (r, c) in _futile_points(cells, who):
        score -= 14000

    if _puts_opponent_in_atari(cells, r, c, who):
        verdict = chase_verdict(cells, r, c, who)
        if verdict is not None:
            if verdict.kind == "working_chase":
                score += 2500 + verdict.group_size * 80
                score += int(_bonus(load_book(), "to_heuristic", ("working_chase",), 35.0, 1400.0))
            elif verdict.kind == "broken_chase":
                score -= 2000

    if _own_territory_fill(cells, r, c, who):
        score -= 3500
    if _nearby_double_atari(cells, r, c, who):
        score -= 6000
    return score
Modelo usado: Qwen3-VL-8B-Instruct + adaptador LoRA (lora_mix_qwen_r5). O código-fonte completo e a descrição do modelo estão no post "8. O código-fonte completo e os modelos usados".
COMMENTS · CHAPTER 07
Corrigindo a heurística de go 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google