Uma das tarefas que encarei no começo foi o quebra-cabeça deslizante (daqui em diante, TSP, de Tiles-Sliding Puzzle). Logo que começava, a IA ficava repetindo a mesma posição e não conseguia resolver o quebra-cabeça. Se ela tivesse avançado um pouco antes, eu até entenderia, mas ela nem conseguia começar; só ficava indo e voltando no mesmo lugar. Acho que o motivo é a recompensa. Toda IA, seja LLM ou não, trabalha em direção a uma recompensa da tarefa e tenta obter o máximo de recompensa possível. Mas, para resolver um TSP, é preciso conhecer algumas regras distribuídas em várias etapas. Suponha que o tabuleiro tenha os números de 1 a 15 mais uma casa vazia, e que o objetivo seja posicionar o 1. É preciso montar uma faixa (loop) que contenha o 1, e essa faixa deve incluir a casa de destino do 1, a posição atual do 1 e uma casa vazia entre elas. Girando esse grupo mínimo de seis casas, que contém a casa vazia, o destino e o número 1, o 1 chega ao seu lugar. O problema é que a casa vazia fica logo atrás do 1, e o 1 só recebe recompensa quando avança para a casa vazia. Depois que ele se move, a casa vazia sobe e, de novo, mover o 1 para a casa vazia é a maior recompensa. Assim começa um vaivém infinito entre a casa vazia e o 1. Se você disser à IA para não tentar chegar à resposta logo de cara, mas primeiro montar o loop e continuar girando até que o 1 chegue à zona de destino final, recompensando-a na chegada e também por completar o primeiro loop, a IA para de fazer jogadas que se repetem infinitamente. Casos assim acontecem bastante quando se treina IA de verdade. Antes se usava muito aprendizado por reforço (reinforcement learning), mas com o aprendizado por reforço esses loops acontecem inúmeras vezes. O treinamento também é muito lento e, quando chega ao ponto em que o loop aparece, todo o treinamento anterior vira loss. Hoje não uso mais aprendizado por reforço; baixo modelos do Hugging Face e faço o treinamento a partir deles. O aprendizado por reforço costumava causar problemas num combo triplo de custo, tempo e loss de treinamento. Acredito que quem treina IA poderá usar LLMs em muitas áreas entendendo por que o problema do loop infinito acontece e mudando o método de treinamento.
Olhando os registros
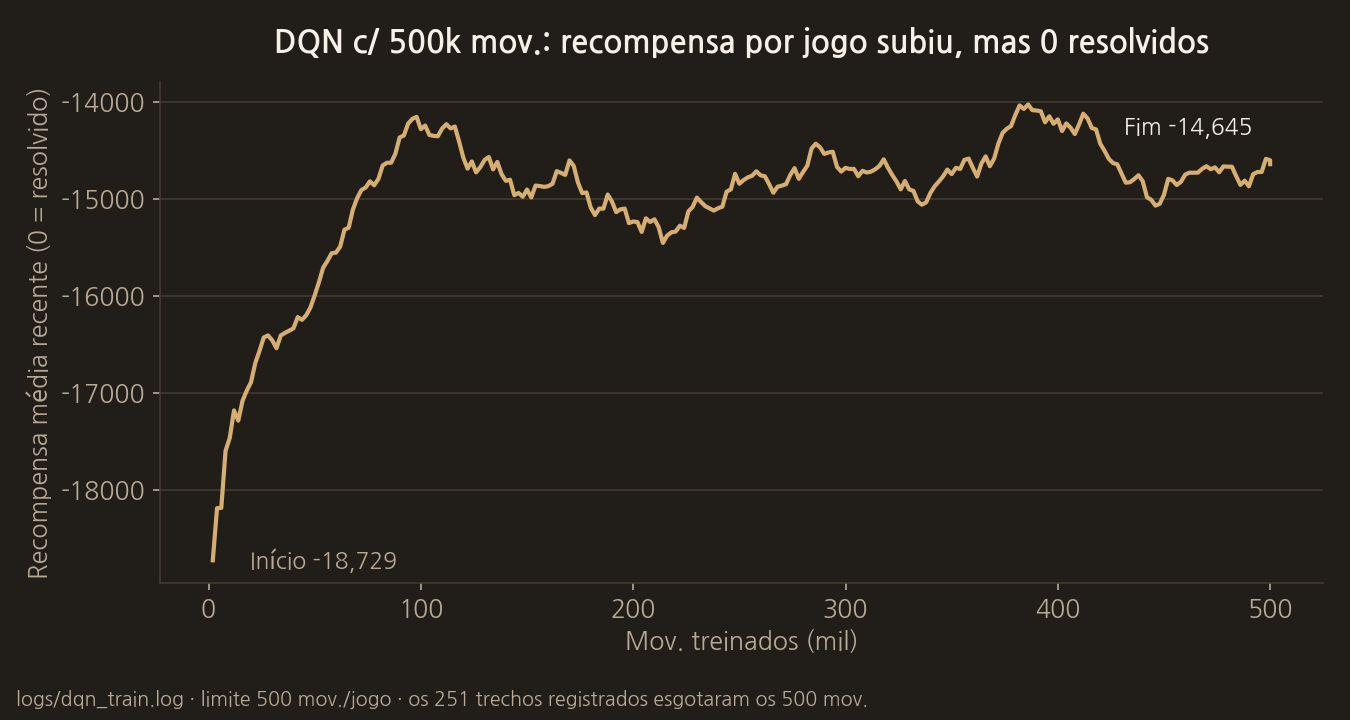
Este é o log do treinamento de uma DQN por 500.000 jogadas (cerca de 1.000 partidas). A recompensa subiu, mas nenhuma partida foi concluída dentro do limite de 500 jogadas.
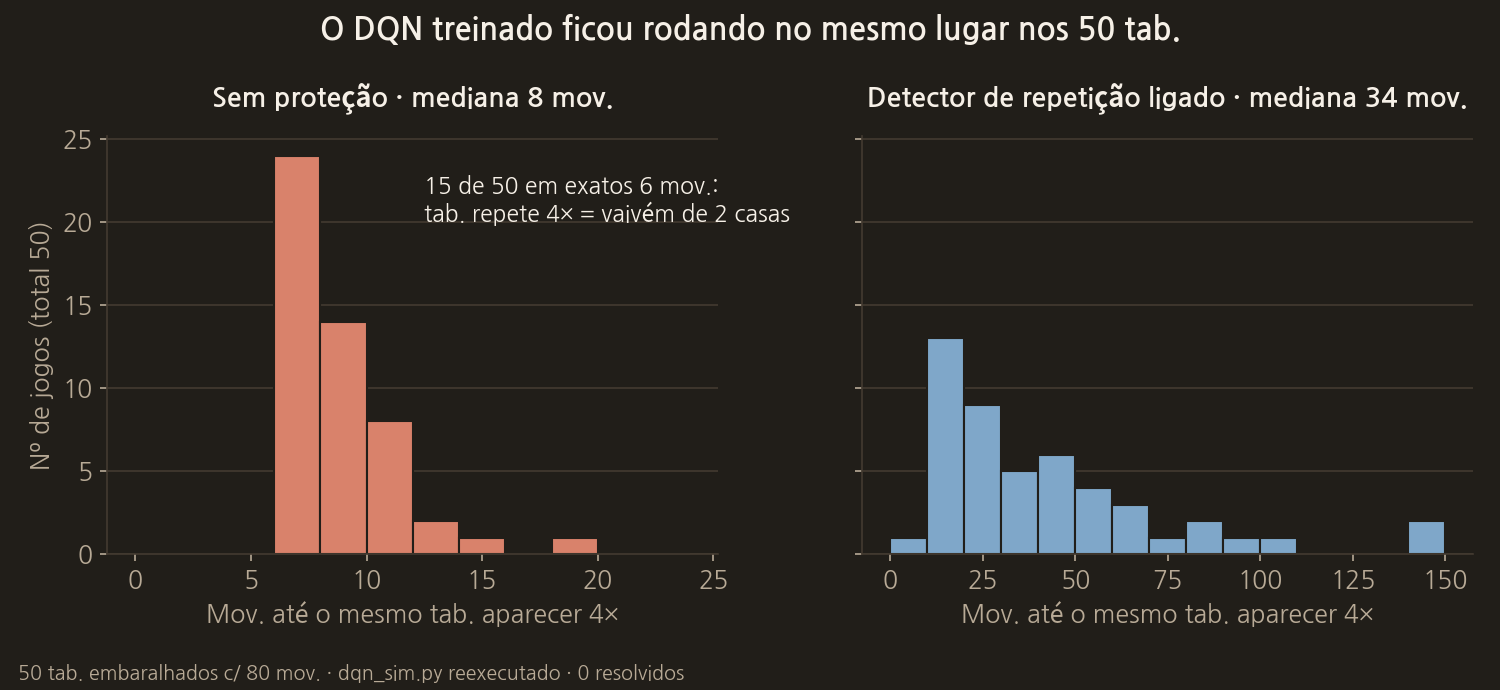
Rodei o modelo treinado de novo em 50 tabuleiros embaralhados com 80 jogadas. Sem uma proteção, o mesmo tabuleiro apareceu quatro vezes após uma mediana de 8 jogadas, e em 15 tabuleiros ela só ficou indo e voltando entre duas casas desde o início.
COMMENTS · CHAPTER 01
Por que é difícil treinar uma IA no quebra-cabeça deslizante 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google