Material a preparar
SGF é um formato de texto que guarda o tamanho do tabuleiro, as jogadas das pretas e das brancas e o resultado da partida. Primeiro, reúna apenas registros cuja origem e condições de reutilização você já verificou. Mais importante do que a quantidade de arquivos é filtrar os registros que falham na leitura, os tabuleiros que não são 19×19 e as partidas com coordenadas de jogada corrompidas.
- Verificar se o tamanho do tabuleiro é 19×19.
- Reproduzir as jogadas das pretas e das brancas desde o início.
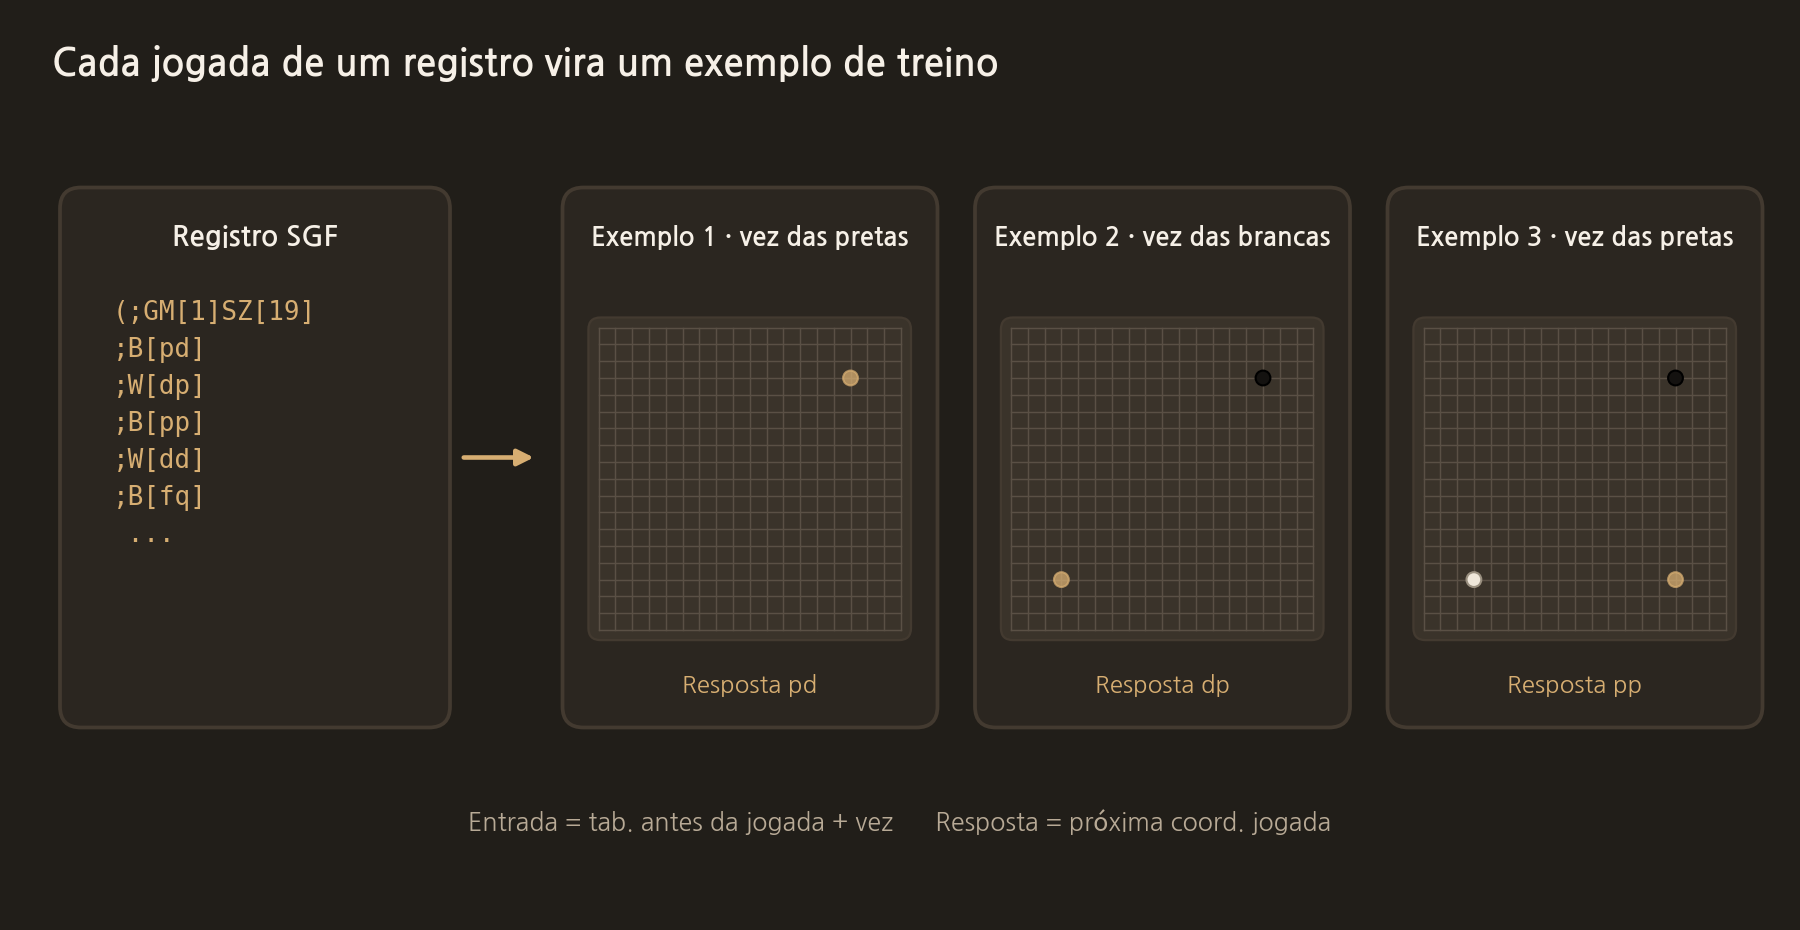
- Salvar como entrada o tabuleiro logo antes de cada jogada.
- Salvar como resposta a coordenada realmente jogada em seguida.
- Guardar também o resultado da partida e o número da jogada.
Etapa 1: Reproduzir as jogadas em um tabuleiro vazio
Ao ler as coordenadas do SGF, converta as coordenadas em letras do arquivo original para linhas e colunas internas de 0 a 18 uma única vez. Depois disso, o motor de regras passa a usar apenas coordenadas numéricas. Salve uma jogada como dado, coloque essa pedra também no tabuleiro real, remova as pedras capturadas e passe para a próxima jogada.
Se a verificação de jogadas legais estiver ligada durante esse processo, os erros dos registros originais e do parser aparecem rapidamente. Se um registro normal for julgado como suicídio, muitas vezes o erro está na direção das coordenadas, na ordem de vez entre pretas e brancas ou na ordem de remoção das pedras.
Etapa 2: Dividir uma partida em vários exemplos de treinamento
Um registro de 100 jogadas não é um exemplo, e sim até 100 pares de entrada e resposta. O primeiro exemplo é o tabuleiro vazio e a primeira jogada das pretas; o segundo é o tabuleiro com uma pedra preta e a resposta das brancas. A entrada precisa sempre indicar de quem é a vez, para que no mesmo formato de tabuleiro dê para distinguir qual cor vai jogar.
Etapa 3: Verificar duplicatas e viés
Se o mesmo tabuleiro se repete em vários arquivos, o peso dele no treinamento pode ficar grande demais. Crie um hash combinando a disposição do tabuleiro, a vez atual e a informação de ko para reduzir as duplicatas. Manter apenas as jogadas do vencedor é simples, mas você perde todos os padrões de defesa e de erro que poderiam ser aprendidos com as jogadas do perdedor. No MariaGO, priorizamos os registros do vencedor, mas as posições com atari e captura recebem uma marcação separada para poderem ser avaliadas.
O que verificar
Sorteie 20 exemplos e marque você mesmo a jogada correta no tabuleiro de entrada. É preciso conferir a olho que esquerda e direita ou cima e baixo não estão invertidos, e que o alinhamento não se desloca nos números de coluna de dois dígitos. Estatísticas dizendo que há muitos dados nunca vão revelar erros de conversão de coordenadas.
O código real desta etapa
Esta função converte as coordenadas em letras do SGF para linhas e colunas de 0 a 18 uma única vez. Em um tabuleiro 19×19, tt é tratado como passe.
vlm_server/sgf_parser.py
def _decode_point(s: str, size: int) -> Optional[Tuple[int, int]]:
    if not s:
        return None
    s = s.strip().lower()
    if not s:
        return None
    # SGF: 'tt' 는 19x19 에서 패스 관용 표기
    if size == 19 and s == "tt":
        return None
    if len(s) < 2:
        return None
    col = ord(s[0]) - ord("a")
    row = ord(s[1]) - ord("a")
    if not (0 <= col < size and 0 <= row < size):
        return None
    return (row, col)
Esta função divide uma partida em exemplos por jogada de "tabuleiro anterior, jogador da vez, coordenada correta". winning_side_only corresponde a priorizar as jogadas do vencedor, e tactical_bias a marcar as posições de atari e captura.
vlm_server/dataset_baduk.py
def iter_training_samples(
    game: SgfGame,
    max_per_game: int,
    rng: random.Random,
    winning_side_only: bool = False,
    winner: Optional[int] = None,
    tactical_bias: bool = False,
    tactics_only: bool = False,
) -> Iterator[Tuple[bytes, int, Optional[Tuple[int, int]], bool]]:
    """게임 1개에서 (board_before_move, ai_side, target_move, is_tactical) 4-tuple yield."""
    if game.size != BOARD_SIZE:
        return
    sim = _GoSim(BOARD_SIZE)
    for r, c in game.setup_black:
        sim.set(r, c, 1)
    for r, c in game.setup_white:
        sim.set(r, c, 2)

    # tactics_only 든 tactical_bias 든 어느 쪽이라도 분류기를 켜야 한다.
    need_tactical_flag = tactical_bias or tactics_only

    states: List[Tuple[bytes, int, Optional[Tuple[int, int]], bool]] = []
    # (snap_before, side, point, is_tactical)
    for color, point in game.moves:
        side = 1 if color == "B" else 2
        if winning_side_only and winner is not None and side != winner:
            if point is not None:
                sim.play(point[0], point[1], side)
            continue
        snap = sim.packed()
        is_tac = _is_tactical_move(sim, side, point) if need_tactical_flag else False
        states.append((snap, side, point, is_tac))
        if point is not None:
            sim.play(point[0], point[1], side)

    if not states:
        return

    if tactics_only:
        # 전술 순간만 yield (max_per_game 무시).
        for snap, side, point, is_tac in states:
            if is_tac:
                yield (snap, side, point, True)
        return

    if max_per_game <= 0 or len(states) <= max_per_game:
        chosen_indices = list(range(len(states)))
    else:
        if tactical_bias:
            # 절반은 전술 순간 우선, 나머지는 균등.
            tactical_idx = [i for i, st in enumerate(states) if st[3]]
            half = max_per_game // 2
            if len(tactical_idx) > half:
                rng.shuffle(tactical_idx)
                tactical_pick = sorted(tactical_idx[:half])
            else:
                tactical_pick = sorted(tactical_idx)
            need = max_per_game - len(tactical_pick)
            # 나머지 균등 샘플 (tactical_pick 와 중복 피함)
            taken = set(tactical_pick)
            uniform: List[int] = []
            if need > 0:
                step = max(1.0, len(states) / need)
                k = 0
                while len(uniform) < need and k < len(states):
                    idx = int(k * step)
                    if idx >= len(states):
                        break
                    if idx not in taken:
                        uniform.append(idx)
                        taken.add(idx)
                    k += 1
            chosen_indices = sorted(set(tactical_pick + uniform))
        else:
            step = len(states) / max_per_game
            chosen_indices = sorted(set(int(i * step) for i in range(max_per_game)))

    for i in chosen_indices:
        snap, side, point, is_tac = states[i]
        yield (snap, side, point, is_tac)
Modelo usado: Qwen3-VL-8B-Instruct + adaptador LoRA (lora_mix_qwen_r5). O código-fonte completo e a descrição do modelo estão no post "8. O código-fonte completo e os modelos usados".
COMMENTS · CHAPTER 02
Transformando registros de partidas SGF em dados de treinamento 0 comentários
Ainda não há comentários. Deixe uma pergunta ou algo que queira acrescentar.
Para publicar um comentário, comece com o Google e registre um apelido e um e-mail.
Começar com o Google