私が初期に挑戦した課題の一つに、スライドパズル(Tiles-Sliding puzzle、以下 TSP)がありました。ところが始めた途端、AIは同じ場所を繰り返すばかりで問題を解けませんでした。ある程度進んでからならまだしも、これは始めることすらできず、同じ場所を行ったり来たりしていました。私が考える理由は報酬です。LLMであろうとなかろうと、すべてのAIはタスクの報酬を目標に、より多くの報酬を得ようと努力します。しかし TSP では、問題を解くために何段階かのルールを知っている必要があります。盤全体に1〜15の数字と空きマス一つがあり、1を合わせることを目標にするとしましょう。1を含む帯(ループ)の構造を作る必要があり、この帯には1の本来の正解位置、現在の1の位置、そしてその間に空きマスが一つなければなりません。その空きマス、目標地点、数字1を含む最小のまとまりである合計6マスを回すと、1が自分の位置に収まります。ところが問題は、1のすぐ後ろに空きマスがあり、数字1が前進するには空きマスへ動かないと報酬がもらえないことです。動いた後は空きマスが上に移り、再び数字1を空きマスへ動かすことが最大の報酬になります。すると空きマスと1の間で無限に繰り返す現象が起きます。AIに最初から答えを解こうとさせず、まずループを作り、1が最終的な正解ゾーンに着くまでそのループを回し続けさせ、到着したときに報酬を与え、最初のループを完成させたときにも報酬を与えると、AIはもう無限に繰り返す手を出さなくなります。実際にAIを訓練すると、こうしたケースがよく起こります。以前は強化学習(reinforcement learning)をよく使っていましたが、強化学習ではこのようなループが数えきれないほど発生します。学習速度もとても遅く、ループが起きる地点まで来ると、それまでの学習はすべて loss になってしまいます。今は強化学習を使わず、Hugging Face からモデルをダウンロードして訓練しています。以前の強化学習は、費用、時間、学習の loss という三重苦でよく問題を起こしていました。AIを学習させている方は、無限ループの問題がなぜ起きるのかを理解し、学習方法を変えることで、LLMをさまざまな分野で使えるようになると思います。
記録で見ると
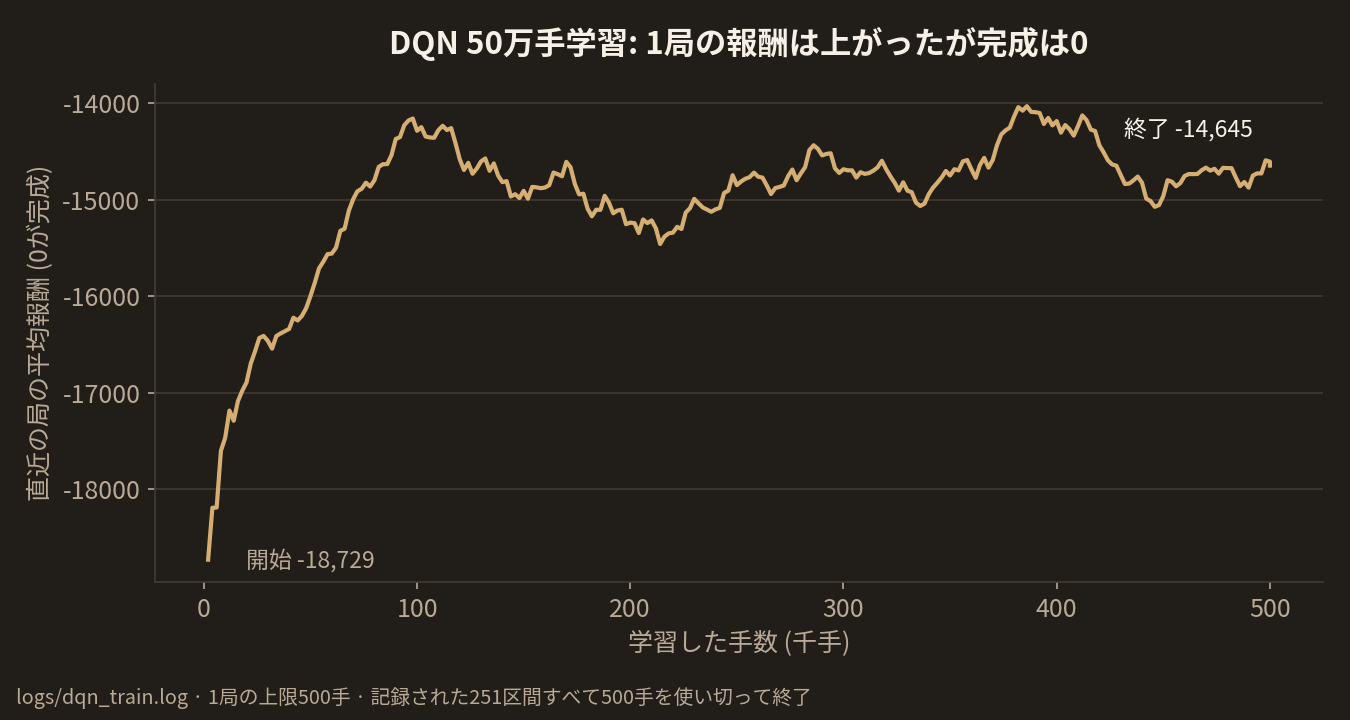
DQN を50万手(約1,000局)学習させたログです。報酬は上がりましたが、500手の上限内に完成した盤は一つもありませんでした。
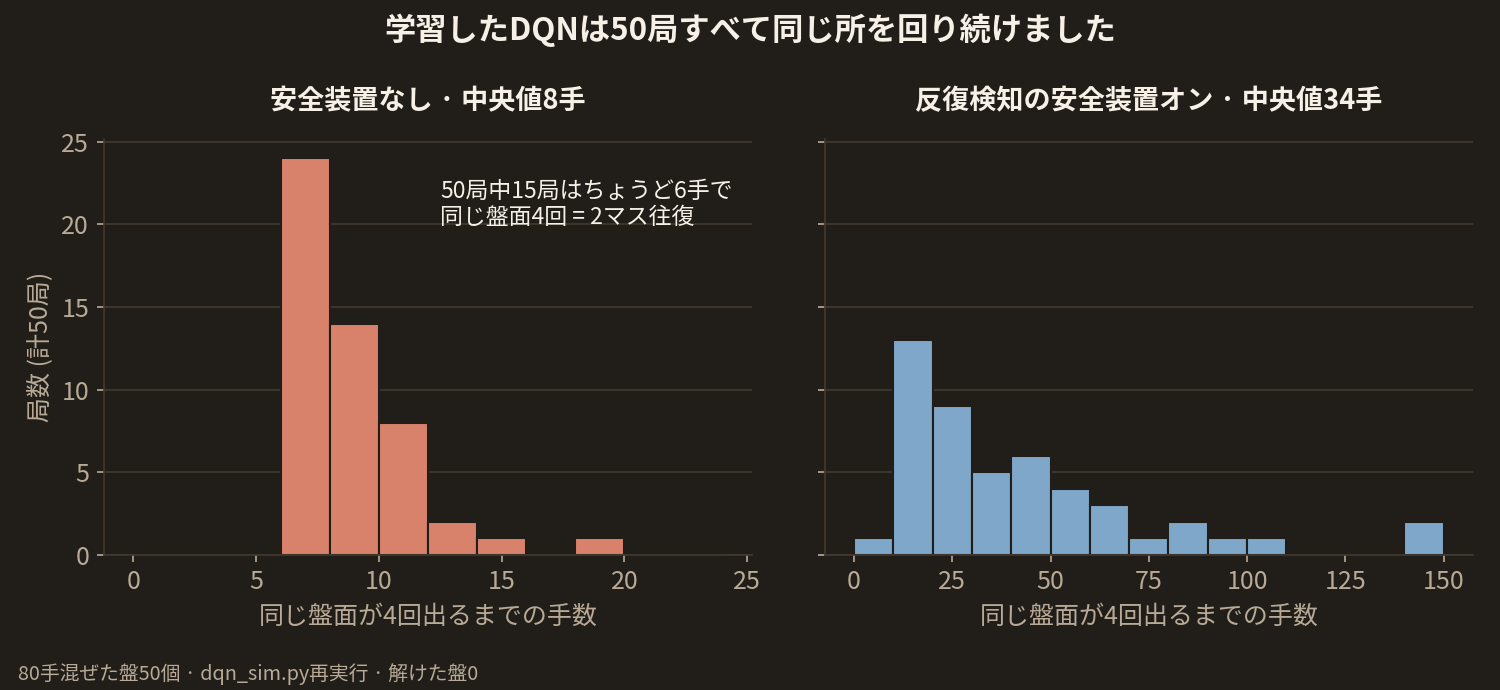
学習を終えたモデルで、80手シャッフルした盤50個をもう一度解かせてみました。安全装置なしでは中央値8手で同じ盤が4回現れ、15個の盤では最初から2マスを行ったり来たりするだけでした。
COMMENTS · CHAPTER 01
スライドパズルでAIを訓練する難しさ コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める