4人は同じ300億チップで開始し、アンティ支払い後の表示は299億だった。ほぼ同じスタート地点なのに、学習済みAIはすぐ目立つ行動へ偏った。弱いハンドや早いストリートでもオールインし、AI同士で巨大なポットを作って早期に脱落した。
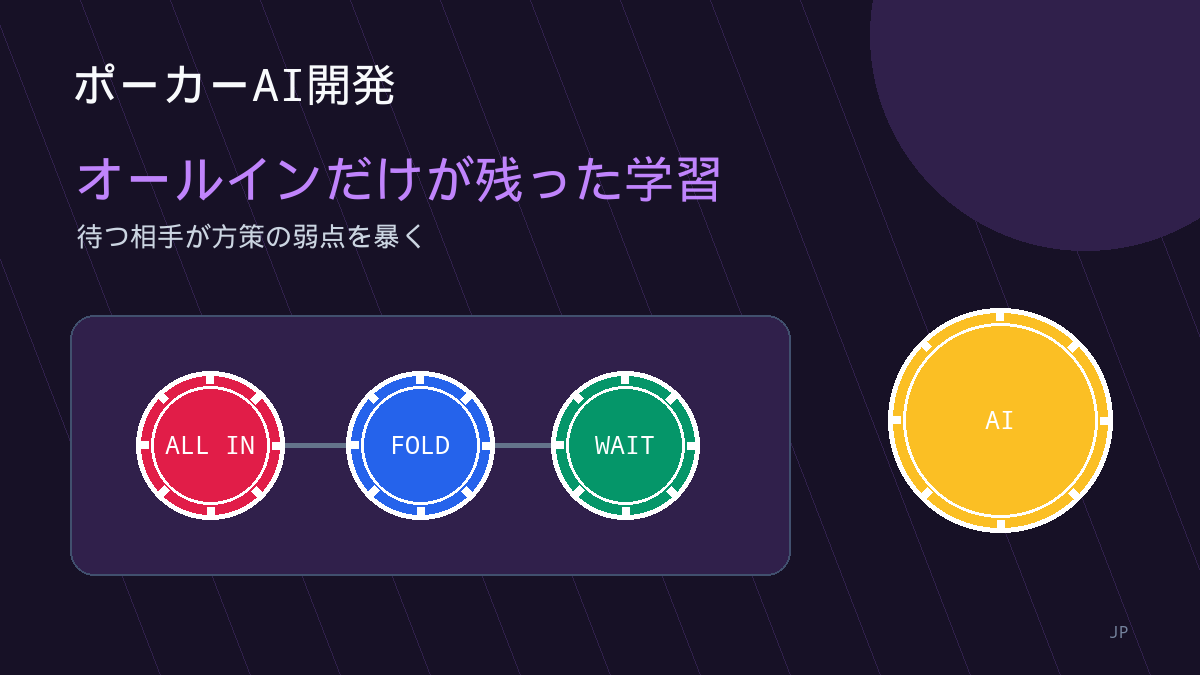
人間側に高度な妙手は要らなかった。弱いハンドをフォールドし、AI同士が衝突する間は待ち、ハンド強度と状況が整った時だけ参加した。最後に勝ったからといって、人間が完全なポーカーをした証明にはならない。相手方針に反復可能な欠陥があり、保守的な応答で利用できたという意味である。
確率も丁寧に区別したい。実力とスタックが等しい4人に追加情報がなければ、対称な事前確率は各25%。1人がフォールドしてそのハンドの競争から外れれば、残る3人の条件付きの取り分は `1 / 3`、約33.33%ずつとなる。3.4ではない。実際のエクイティはホールカード、ボード、ベット、スタックで変わり、これは人数だけの基準線にすぎない。
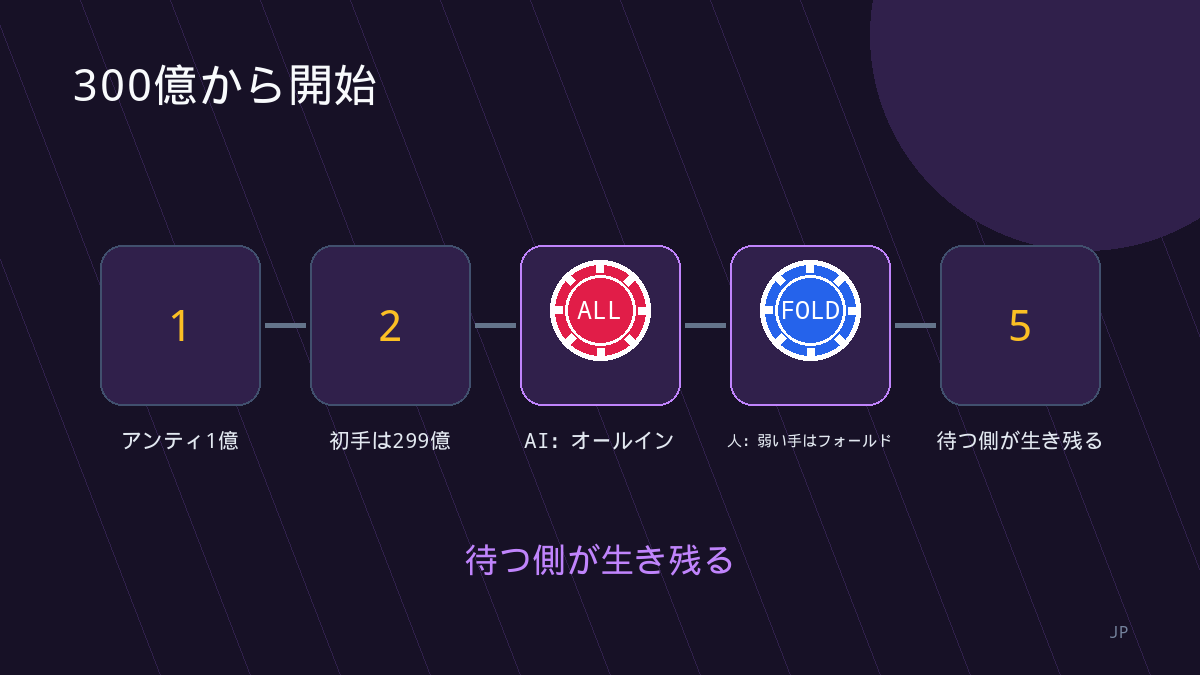
繰り返された流れは、AIの早期オールイン、人間の弱手フォールド、AI同士の脱落勝負、より良い局面での人間参加だった。フォールドは直ちにチップを増やさないが、不利な分散を避け、次の判断機会を残す。AIは優位を確認する前に全スタックを危険にさらした。
したがって、これは「オールインが最適だと学習した」証拠ではなく、exploitability、つまり攻略可能性の証拠である。1回の勝敗や派手なショーダウンでは最適性を示せない。ストリート別オールイン率、実行時の平均強度、脱落率、複数シードでの長期スタックを測る必要がある。この対局は結論ではなく、報酬設計を調べるための再現可能な診断信号だった。
COMMENTS · CHAPTER 01
人間が待つ一方で、ポーカーAIはオールインを繰り返した コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める