何を「良くなった」と呼ぶのか
学習の損失が下がったからといって、実際の対局が良くなったわけではありません。囲碁AIは座標を読み、合法手を出し、競り合いの最中にパスせず、自分の石を不必要に埋めないことが必要です。モデルを変える前に、これらの項目を同じ評価セットで測定しなければなりません。
ステップ1: 評価項目を分けます
座標テストは石の位置を正しく読めるかを測ります。ルールテストはモデルが出した反則手の割合を数えます。対局テストは決まった相手と黒白を入れ替えて打ち、取り、パスの時点、終局の理由を保存します。異なる失敗を一つの勝率にまとめると、何を直すべきか分からなくなります。
- 四つの象限の座標正答率
- 最初の応答と再要求での反則手の割合
- 80手より前の早すぎるパスの回数
- 同じ列や隅を繰り返し選ぶ方向の偏り
- 黒白を入れ替えた対局での取りと最終結果
ステップ2: 基準モデルの結果を保管します
新しいモデルだけを実行せず、現在の運用モデルの結果を同じJSON形式で保管します。評価データのバージョン、モデル名、プロンプト、ルールエンジンのコミットを一緒に書いておけば、後で数字を再現できます。ランダム性があるなら、シードと生成設定も固定します。
ステップ3: 短い対局の限界を明示します
80手で打ち切った仮の整地は、素早い回帰チェックには便利ですが、正式な勝率や段級として解釈することはできません。死活の判定とヨセが残っているからです。短い評価では反則手、早すぎるパス、明らかな戦術的損失を見て、棋力の比較は完局を十分に集めて別に判断します。
ステップ4: 失敗事例を次のデータにつなげます
評価で繰り返された失敗は、盤の状態、モデルの応答の原文、拒否の理由をまとめて保存します。座標エラーは入力テストへ、シチョウの無駄な逃げは戦術の例へ、早すぎるパスは進行中の盤の例へ分類します。すべての失敗をむやみに学習に入れず、ルールのコードで確実に防ぐ問題と、モデルが学ぶべき問題を分けます。
良い評価表はモデルを褒めるための点数ではなく、次に直す場所を教えてくれる地図です。
実際の記録
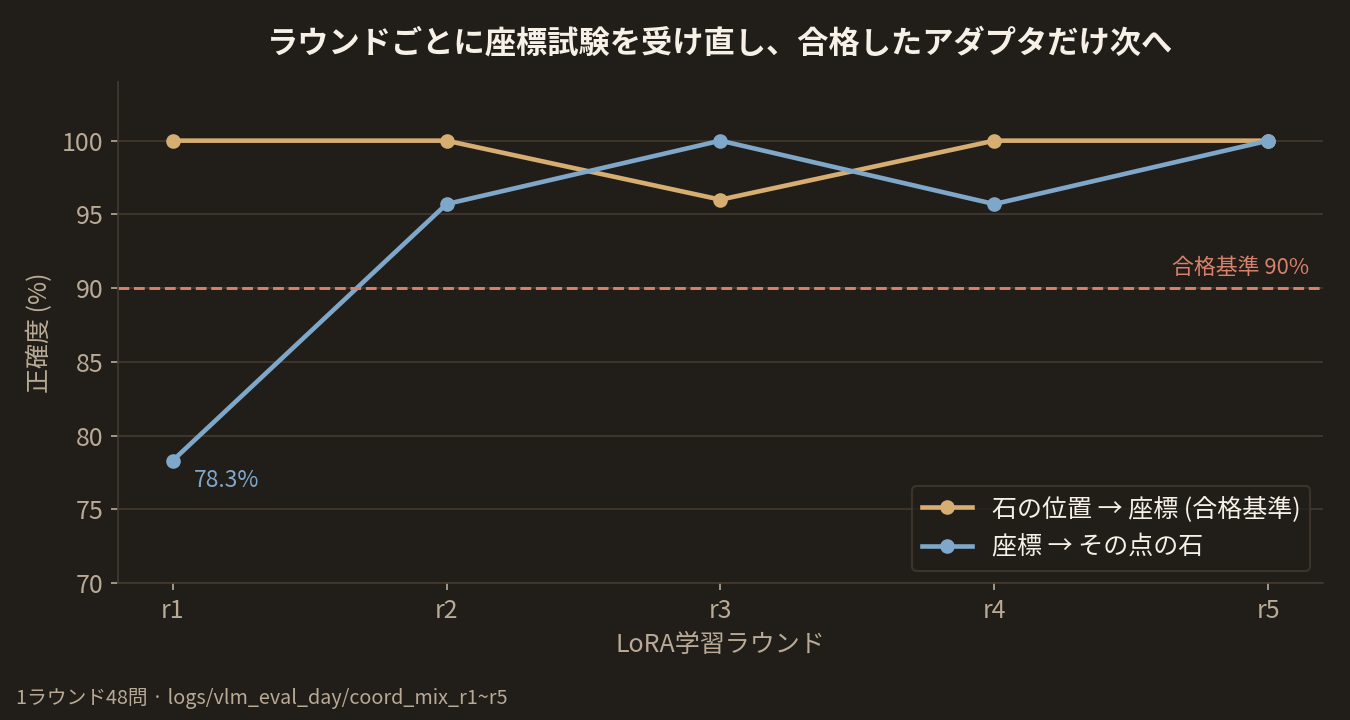
LoRA を五つのラウンドに分けて学習しながら、ラウンドごとに同じ座標テストをやり直しました。r1 は石の位置を座標で読む問題では100%でしたが、座標を与えてその場所の石を問う問題では78.3%でした。一つの項目だけを見ていたら見逃していた差です。
この段階の実際のコード
座標テストの結果を左上(TL)・右上(TR)・左下(BL)・右下(BR)の四つの区域に分けて集計するコードです。全体の正答率と一緒に区域別の正答率を残し、方向の偏りをすぐに確認できるようにしました。
vlm_server/verify_coords.py
def _quadrant(r: int, c: int) -> str:
    if r < 9.5 and c < 9.5:
        return "TL"
    if r < 9.5 and c >= 9.5:
        return "TR"
    if r >= 9.5 and c < 9.5:
        return "BL"
    return "BR"
vlm_server/verify_coords.py
def summarize(results: List[TrialResult]) -> Dict[str, Any]:
    by_kind = Counter()
    ok_kind = Counter()
    by_q = Counter()
    ok_q = Counter()
    for r in results:
        by_kind[r.kind] += 1
        by_q[r.quadrant] += 1
        if r.ok:
            ok_kind[r.kind] += 1
            ok_q[r.quadrant] += 1
    total = len(results) or 1
    return {
        "n": len(results),
        "accuracy": round(100.0 * sum(1 for r in results if r.ok) / total, 1),
        "by_kind": {
            k: {
                "n": by_kind[k],
                "ok": ok_kind[k],
                "acc": round(100.0 * ok_kind[k] / max(1, by_kind[k]), 1),
            }
            for k in sorted(by_kind)
        },
        "by_quadrant": {
            q: {
                "n": by_q[q],
                "ok": ok_q[q],
                "acc": round(100.0 * ok_q[q] / max(1, by_q[q]), 1),
            }
            for q in ("TL", "TR", "BL", "BR")
        },
        "avg_ms": round(sum(r.ms for r in results) / total, 1),
    }
使用したモデル: Qwen3-VL-8B-Instruct + LoRA アダプター(lora_mix_qwen_r5)。全ソースとモデルの説明は「8. 全ソースコードと使用したモデル」の記事で見られます。
COMMENTS · CHAPTER 05
学習より先に評価セットを固定する コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める