今 VLM が学んでいるもの
自動学習は勝った側の手だけを集めて VLM にまねさせます。ところが学習対局では白(VLM)が94%勝ち、記録には白の手もローカルAIが打ったものとして残っていました。そのためデータ12,080件のうち10,513件が白の手、つまり VLM 自身が打った手でした。1回目の記事で見たように、その学習さえ損失が NaN になって壊れました。
VLM に渡す質問にも五目並べのルールがありません。盤を見せて、空きマスの座標を二つの数字で答えるよう求めるだけです。三、四、禁じ手といった言葉は一度も出てきません。
囲碁とスライドパズルで学んだこと
囲碁では、ヒューリスティックを直して R5 と対局させているうちに、ヒューリスティックがかえって R5 を教えるようになりました。スライドパズルでは、人の解き方のルールをヒューリスティックに入れたら、一日で4,000局をすべて解きました。どちらの場合も、未来の報酬を追う学習より、欲のないルールが先に道を開きました。
五目並べでも同じ方法を試してみるつもりです。まだ試していない計画です。
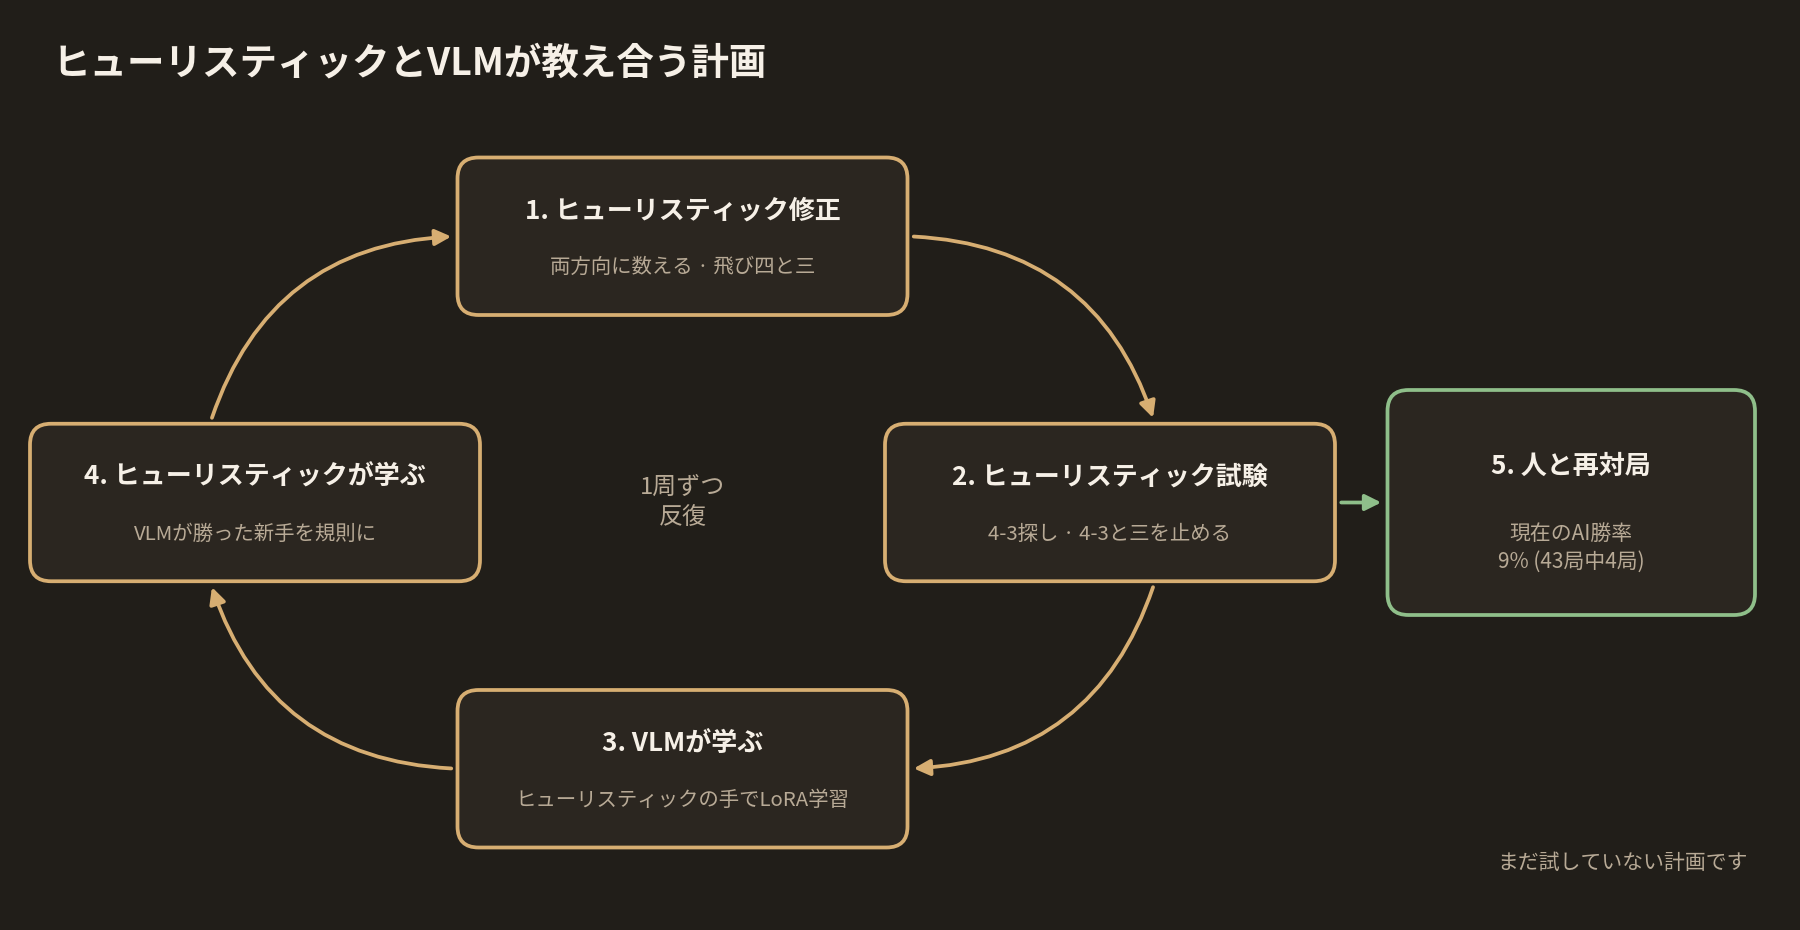
計画
- ヒューリスティックを直す: 一列を両方向に数え、飛び四(○_○○○)と飛び三も同じ形として数えます。自分の四三の位置を先に見つけておき、相手が次の手で四三や達四を作る位置は先に止めるようにします。
- ヒューリスティックのテスト: 3回目の記事のテスト(自分の四三探し、相手の四三の位置を止める、三を止める)を毎回やり直し、同じAIが黒と白を交互に持つ対局で、ルールの有利不利も改めて確認します。
- VLM がヒューリスティックを学ぶ: 直したヒューリスティックの手を正解として LoRA を学習し直します。質問には禁じ手と脅威の形を入れ、壊れた学習設定(MPS fp16)から直します。
- ヒューリスティックが再び教師になる: VLM がヒューリスティックと違う手を打って勝った手を集め、その形を再びヒューリスティックのルールに移します。囲碁で R5 とヒューリスティックが互いに学んだ方法です。
- 人ともう一度打つ: 人を相手にしたAIの勝率が、今の9%(43局中4局)からどれだけ上がるかで判断します。
この段階の実際のコード
今 VLM に送っている質問です。空きマスの座標だけを求め、五目並べのルールは入っていません。
vlm_pva_server.py
base_prompt = (
    f"{turn_line}\n"
    f"{board_txt}\n"
    f"Choose your next {you_label} move on an EMPTY cell (a '.' in the TEXT board)."
    f"{opening_rule} "
    "Trust the TEXT board coordinates over the image. "
    "Reply with EXACTLY two integers separated by a single space: \"row col\". "
    f"row and col are both in 0..{last_idx}. No other text."
)
次の記事は「5. 全ソースコードと使用したモデル」です。
COMMENTS · CHAPTER 04
VLM がヒューリスティックを学び、ヒューリスティックが再び教師になる計画 コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める