マクロ行動
MacroPlanningTetrisEnv は、一つの行動でブロック一つを最後まで置きます。行動番号は目標の列×4 + 目標の回転で、全部で40個です。環境の中で先に回転を合わせ、左右に動かしてからすぐに落とします。1つのブロックに20回以上あった決定が1回に減り、ラインを消した報酬がそのブロックを選んだ行動に直接付きます。
結果
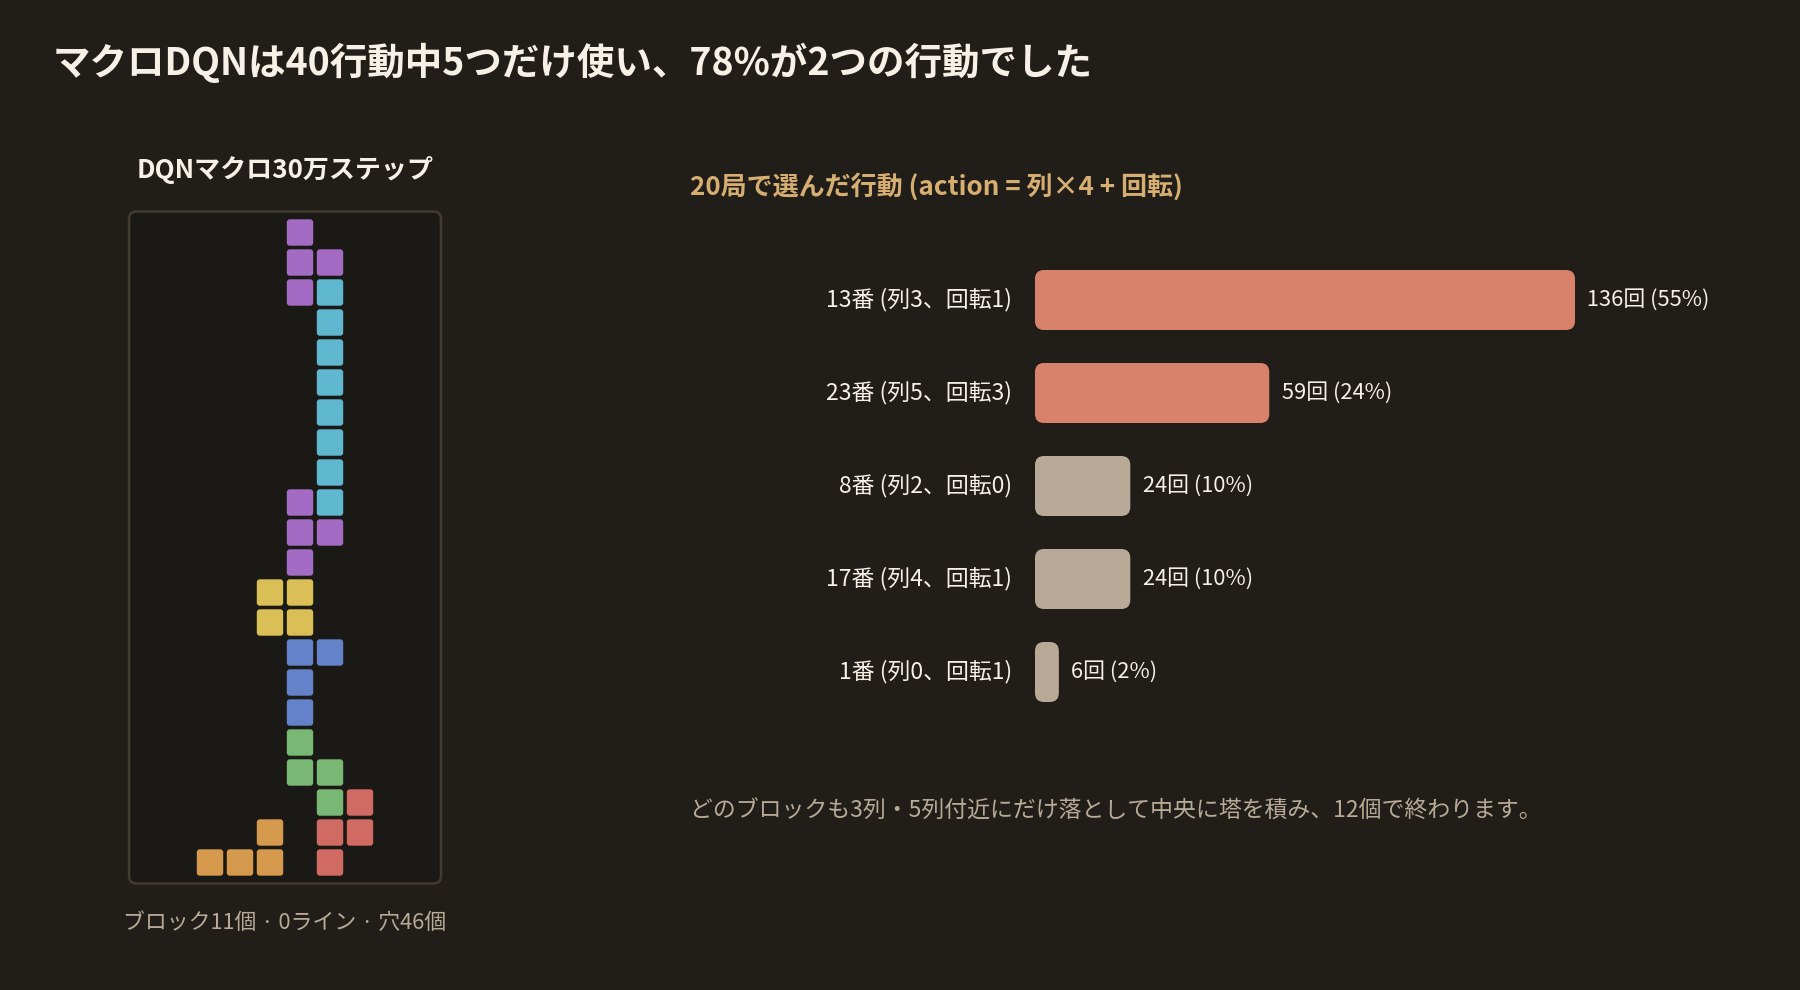
マクロ DQN(dqn.zip)は30万ステップ、ブロックにして30万個を学習しました。同じシードの20局の結果です。
- ランダムマクロ: 平均ブロック25個、0ライン
- DQN マクロ: 平均ブロック12個、0ライン
ランダムより早く終わります。20局の間に選んだ行動は5種類だけで、13番(列3、回転1)と23番(列5、回転3)が78%です。ブロックの種類に関係なく、中央の2か所に落とします。
行動の表現が一番左の列を塞いだ
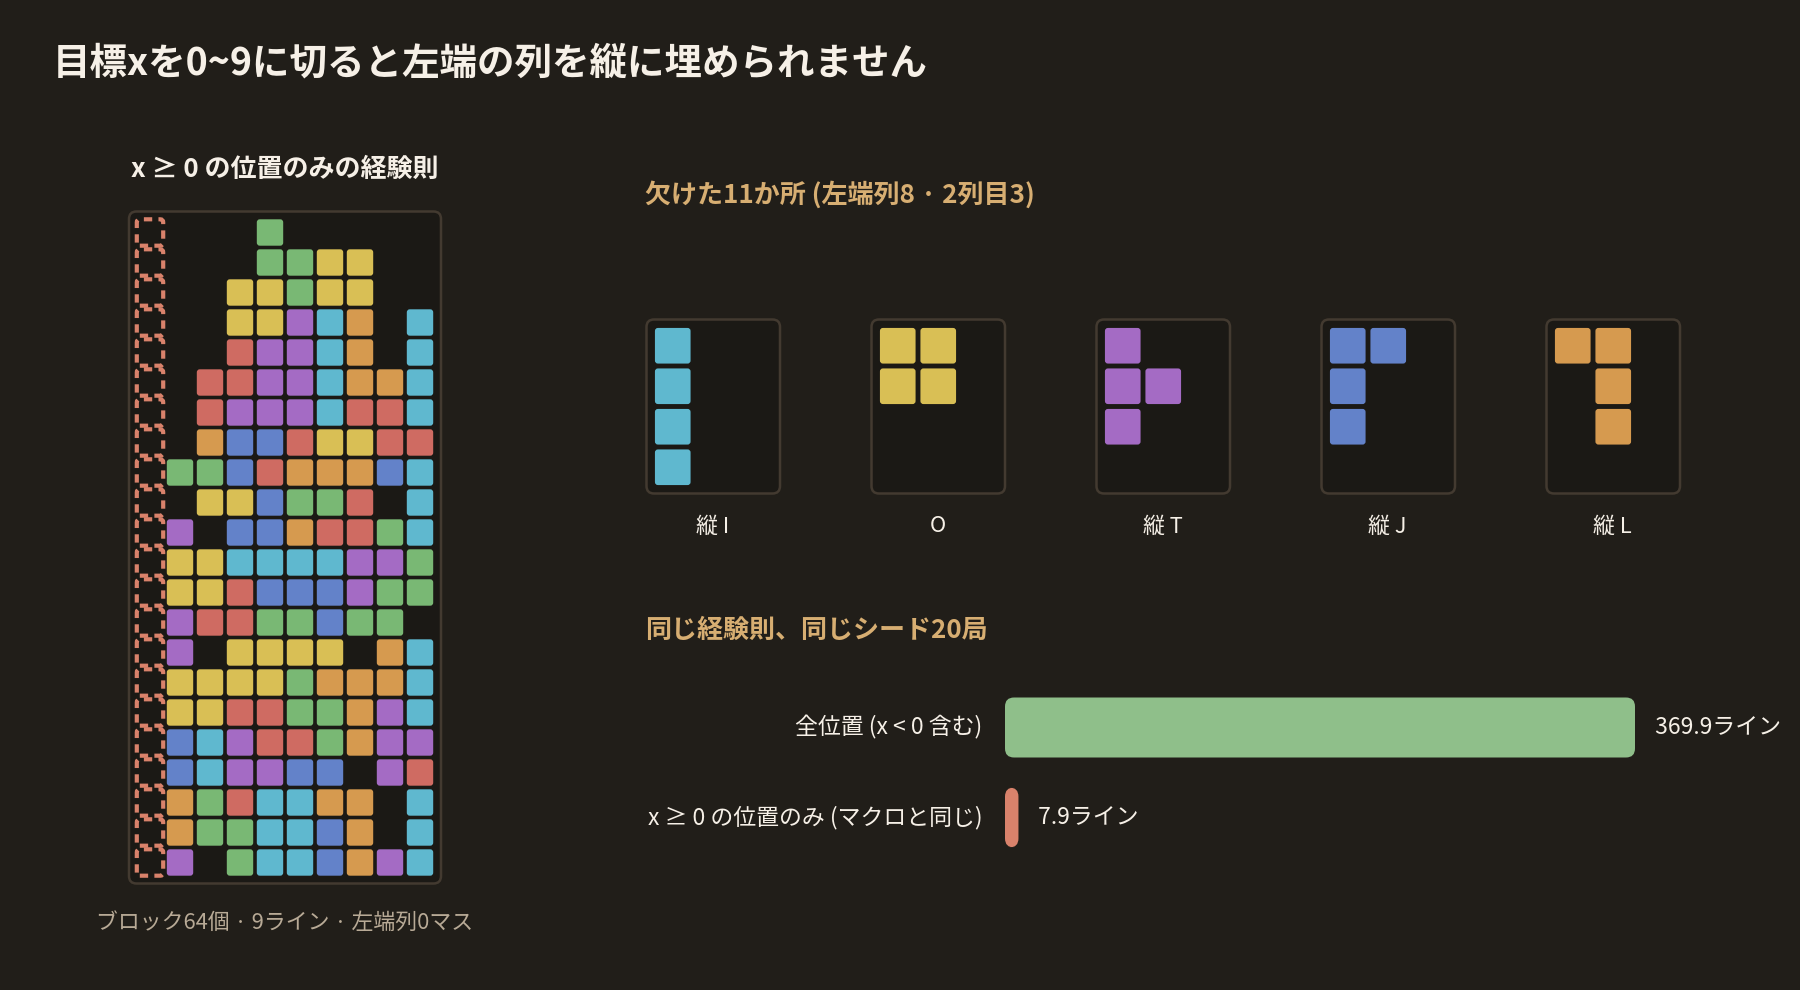
ブロックの形は 4×4 の箱の中に描かれていて、エンジンの x はこの箱の左端です。縦の I は箱の3番目のマスにあるので、一番左の列に置くには x が-2でなければなりません。マクロ行動は目標の列を0〜9に切り詰めるので、こうした場所を選べません。
7つのブロックを置ける場所は全部で162か所で、40個の行動で選べるのは151か所です。欠けている11か所は、縦の I、O、縦の T・J・L を一番左の列(8か所)と2番目の列(3か所)に置く場所です。
5回目の記事に出てくるヒューリスティックの計画器に、同じ制限をかけてみました。すべての場所を使うと20局平均で370ラインを消し、x が0以上の場所だけを使うと7.9ラインです。一番左の列が一度井戸になると埋めるブロックがないので、その列は最後まで空いたままです。
候補をルールで順位付けする MoE(moe_macro_policy.py)もこの40個の行動の上で動き、平均12.4ラインにとどまりました。MoE の最後の盤も、一番左の列がほとんど空いています。
VLM の報酬
ラインの報酬が少ない問題を VLM で埋めようとしました。LLMRewardWrapper は10ステップごとに盤を画像に描いて Qwen2.5-VL-3B に見せ、-1〜1の点数と次の行動をJSONで受け取ります。学習の報酬は、エンジンの報酬 + 0.2×点数です。残りの9ステップは直前の点数をそのまま使います。推薦された行動は記録するだけで使いません。文字の盤を読む Qwen2.5-3B(GGUF)の審判も同じ構造で入っています。
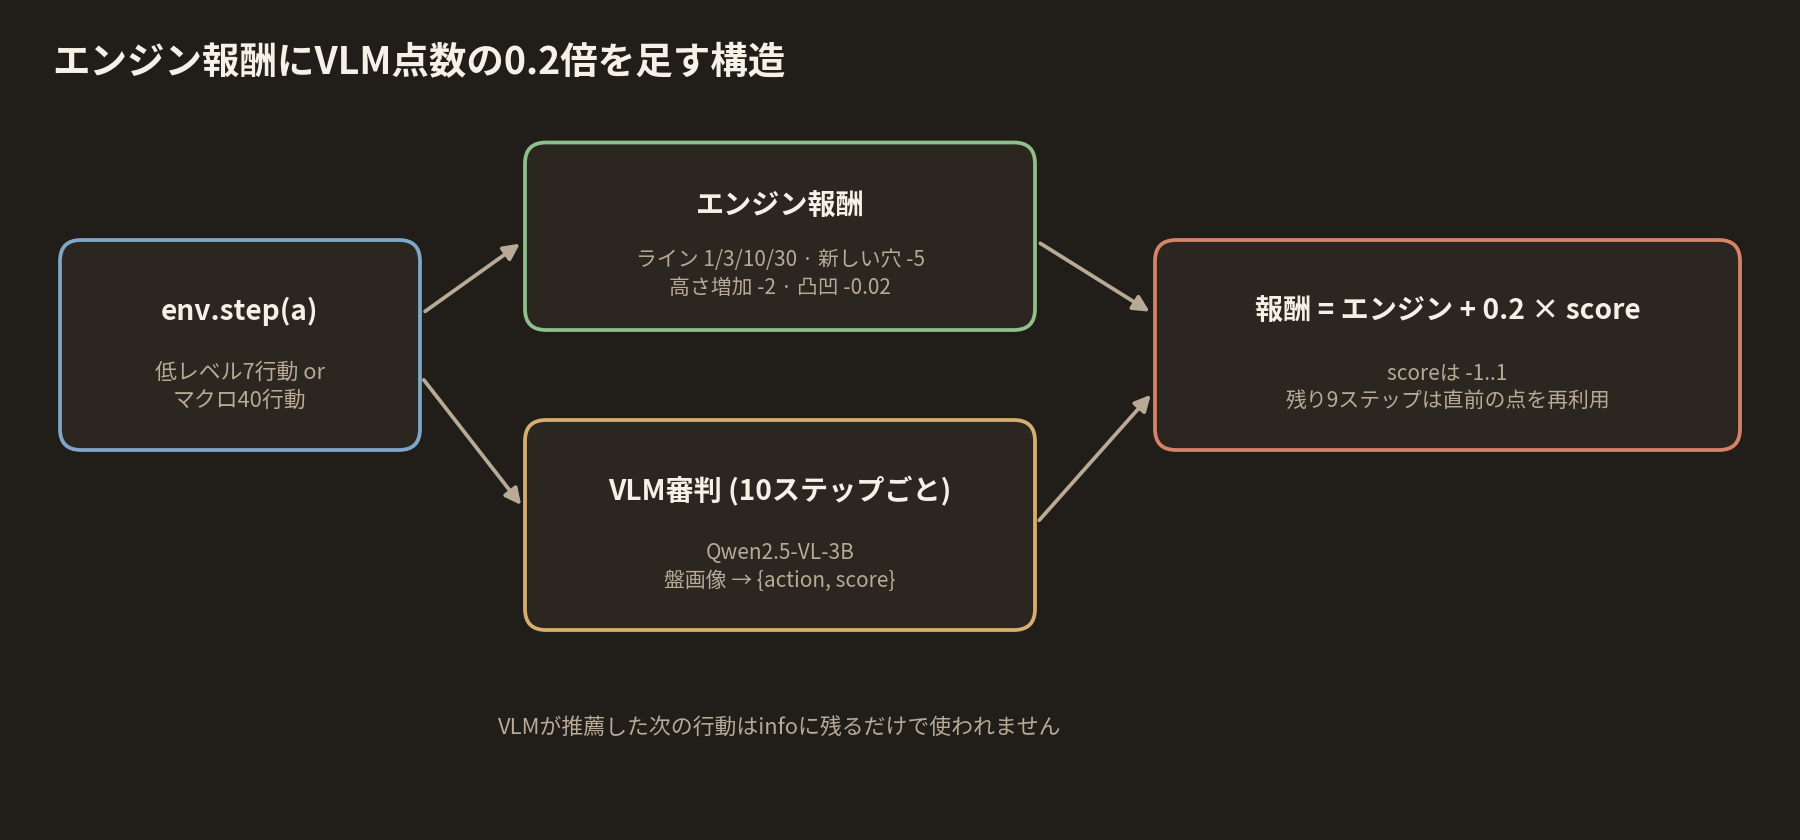
この報酬をオンにして学習した結果は残っていません。マクロ DQN は VLM の報酬コードより先に保存され、低レベルの37万ステップのモデルは、どの報酬設定で学習したのか記録がありません。
そこで審判だけを別にテストしました。ヒューリスティックで盤を途中まで進めた後、同じ盤で点数1位の場所と最下位の場所にブロックを置いた結果をそれぞれ見せました。最下位の場所は平均7.0個の穴を新たに作ります。
- 15組の平均点数: 1位の場所 -0.77、最下位の場所 -0.79
- 1位の場所に高い点数を付けた組4つ、同じ点数10、低い点数1
- 受け取った点数は-0.8か-0.7のどちらかでした
0.2倍で足しても、ほぼすべてのステップに-0.15ほどの減点が同じように付くだけで、場所が良いか悪いかは伝わりません。
この段階の実際のコード
マクロ行動一つを低レベルの行動に分解して、ブロック一つを置きます。目標の列を0〜9に切り詰める行が、一番左の列を塞いだ部分です。
macro_planning_env.py
def step(self, action: int):
    target_rot = int(action) % 4
    target_col = int(action) // 4
    if target_col < 0 or target_col >= self._w:
        target_col = int(np.clip(target_col, 0, self._w - 1))

    start_pi, _, _, _, _ = self._piece_state()
    total_reward = 0.0
    terminated = truncated = False
    info: dict[str, Any] = {}

    for _ in range(self._max_micro_steps):
        pi, ptype, px, py, prot = self._piece_state()
        if self._micro._lib._dll.tetris_game_over(self._micro._h):
            obs = self._micro._obs()
            terminated = True
            info = {
                "lines_cleared_total": int(
                    self._micro._lib._dll.tetris_lines_cleared_total(self._micro._h)
                ),
                "piece_index": int(self._micro._lib._dll.tetris_piece_index(self._micro._h)),
                "macro_steps": _ + 1,
            }
            return obs, total_reward, terminated, truncated, info

        if pi > start_pi:
            break

        if self._controller is not None:
            # RL low-level controller (Discrete(7))
            micro_a, _ = self._controller.predict(obs, deterministic=True)
            micro = int(micro_a)
        else:
            micro = next_micro_for_target(ptype, prot, px, target_rot, target_col)
        obs, r, terminated, truncated, info = self._micro.step(micro)
        total_reward += float(r)
        if terminated or truncated:
            info = dict(info)
            info["macro_steps"] = _ + 1
            return obs, total_reward, terminated, truncated, info
VLM の点数を報酬に足す部分です。
llm_reward_wrapper.py
def step(self, action: int):
    self._last_action = int(action)
    obs, reward, terminated, truncated, info = self.env.step(action)

    # LLM judge uses obs after action
    next_action, score = self.teacher.judge_and_suggest(obs, self._last_action, dict(info))
    shaped = float(reward) + float(self.cfg.alpha) * float(score)

    info = dict(info)
    info["llm_score"] = float(score)
    info["llm_next_action"] = int(next_action)
    info["reward_env"] = float(reward)
    info["reward_shaped"] = float(shaped)

    return obs, shaped, terminated, truncated, info
次の記事は「4. VLM にブロックの場所を直接選ばせる」です。
COMMENTS · CHAPTER 03
ブロックごとに1回選ぶマクロ行動と VLM の報酬 コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める