準備する資料
SGFは、碁盤の大きさ、黒白の着手、対局結果をテキストで保存する形式です。まず、出典と再利用の条件を確認した棋譜だけを集めます。ファイルの数より大事なのは、解析に失敗した棋譜、19×19でない盤、着手座標が壊れた盤を取り除くことです。
- 盤の大きさが19×19かを検査します。
- 黒と白の手順を最初から再生します。
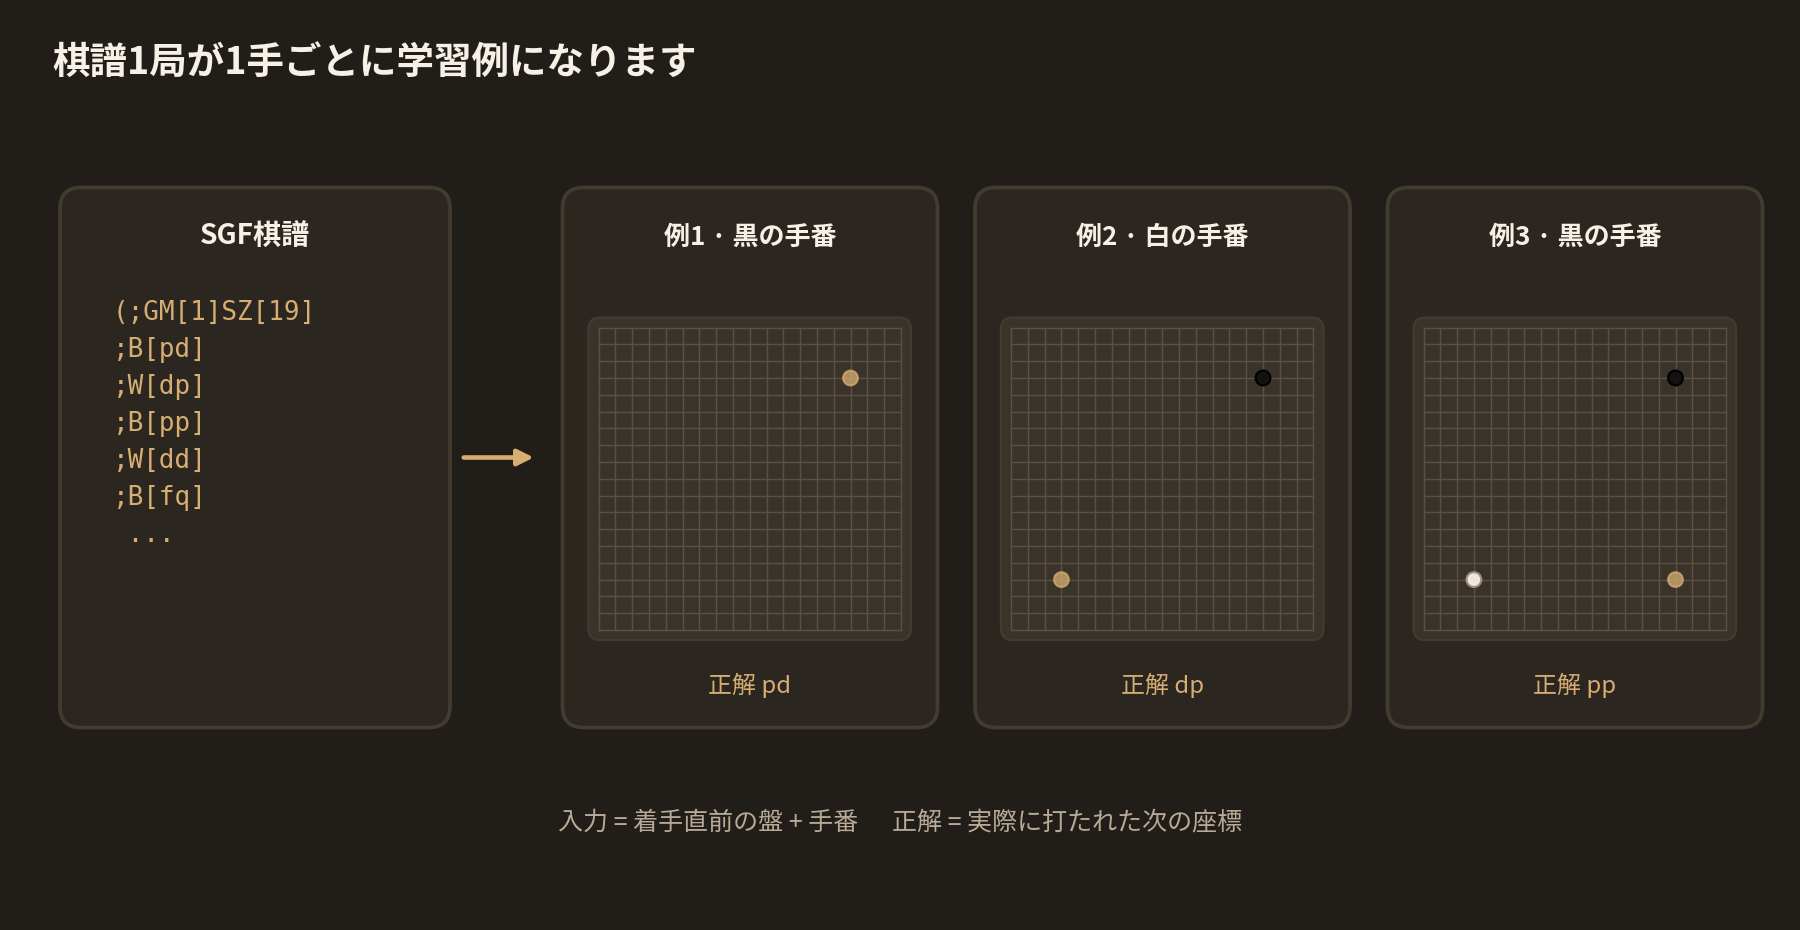
- 各手を打つ直前の盤面を入力として保存します。
- 実際に打たれた次の座標を正解として保存します。
- 対局結果と手数も一緒に残します。
ステップ1: 空の盤で手順を再生します
SGFの座標を読むときは、元のファイルの文字座標を内部の0〜18の行・列へ一度だけ変換します。その後、ルールエンジンは数字の座標だけを使うよう統一します。一手をデータとして保存したら、実際の盤にもその石を置き、取られた石を取り除いてから次の手に進みます。
この過程で合法手の検査をオンにしておくと、元の棋譜やパーサーのエラーをすぐに見つけられます。正常な棋譜が自殺手と判定されるなら、座標の向き、黒白の手番、石を取り除く順序のどれかが間違っていることが多いです。
ステップ2: 一局を複数の学習例に分けます
100手の棋譜は一つの例ではなく、最大100個の入力・正解のペアになります。最初の例は空の盤と黒の初手、二つ目の例は黒石が一つ置かれた盤と白の応手です。入力には現在の手番を必ず示さないと、同じ盤の形でどちらの色が打つのかを区別できません。
ステップ3: 重複と偏りを確認します
同じ盤面が複数のファイルで繰り返されると、学習での比重が大きくなりすぎることがあります。盤の配置、現在の手番、コウの情報をまとめてハッシュを作り、重複を減らします。勝者の手だけを残す方法は簡単ですが、敗者の手から学べる守りやミスのパターンをすべて失います。MariaGO では勝者の棋譜を優先しつつ、アタリと取りがある局面には別の目印を付けて評価できるようにしました。
確認する結果
ランダムに20個の例を選び、入力の盤に正解の手を自分で書き込んでみます。左右や上下が反転していないか、2桁の列番号で整列がずれていないかを目で確かめる必要があります。データの数が多いという統計だけでは、座標変換のエラーは見つかりません。
この段階の実際のコード
SGFの文字座標を0〜18の行・列へ一度だけ変換する関数です。19×19では tt をパスとして扱います。
vlm_server/sgf_parser.py
def _decode_point(s: str, size: int) -> Optional[Tuple[int, int]]:
    if not s:
        return None
    s = s.strip().lower()
    if not s:
        return None
    # SGF: 'tt' 는 19x19 에서 패스 관용 표기
    if size == 19 and s == "tt":
        return None
    if len(s) < 2:
        return None
    col = ord(s[0]) - ord("a")
    row = ord(s[1]) - ord("a")
    if not (0 <= col < size and 0 <= row < size):
        return None
    return (row, col)
一局を手ごとに「直前の盤面、手番、正解座標」の例に分ける関数です。winning_side_only が勝者の手の優先、tactical_bias がアタリ・取りの局面の目印に当たります。
vlm_server/dataset_baduk.py
def iter_training_samples(
    game: SgfGame,
    max_per_game: int,
    rng: random.Random,
    winning_side_only: bool = False,
    winner: Optional[int] = None,
    tactical_bias: bool = False,
    tactics_only: bool = False,
) -> Iterator[Tuple[bytes, int, Optional[Tuple[int, int]], bool]]:
    """게임 1개에서 (board_before_move, ai_side, target_move, is_tactical) 4-tuple yield."""
    if game.size != BOARD_SIZE:
        return
    sim = _GoSim(BOARD_SIZE)
    for r, c in game.setup_black:
        sim.set(r, c, 1)
    for r, c in game.setup_white:
        sim.set(r, c, 2)

    # tactics_only 든 tactical_bias 든 어느 쪽이라도 분류기를 켜야 한다.
    need_tactical_flag = tactical_bias or tactics_only

    states: List[Tuple[bytes, int, Optional[Tuple[int, int]], bool]] = []
    # (snap_before, side, point, is_tactical)
    for color, point in game.moves:
        side = 1 if color == "B" else 2
        if winning_side_only and winner is not None and side != winner:
            if point is not None:
                sim.play(point[0], point[1], side)
            continue
        snap = sim.packed()
        is_tac = _is_tactical_move(sim, side, point) if need_tactical_flag else False
        states.append((snap, side, point, is_tac))
        if point is not None:
            sim.play(point[0], point[1], side)

    if not states:
        return

    if tactics_only:
        # 전술 순간만 yield (max_per_game 무시).
        for snap, side, point, is_tac in states:
            if is_tac:
                yield (snap, side, point, True)
        return

    if max_per_game <= 0 or len(states) <= max_per_game:
        chosen_indices = list(range(len(states)))
    else:
        if tactical_bias:
            # 절반은 전술 순간 우선, 나머지는 균등.
            tactical_idx = [i for i, st in enumerate(states) if st[3]]
            half = max_per_game // 2
            if len(tactical_idx) > half:
                rng.shuffle(tactical_idx)
                tactical_pick = sorted(tactical_idx[:half])
            else:
                tactical_pick = sorted(tactical_idx)
            need = max_per_game - len(tactical_pick)
            # 나머지 균등 샘플 (tactical_pick 와 중복 피함)
            taken = set(tactical_pick)
            uniform: List[int] = []
            if need > 0:
                step = max(1.0, len(states) / need)
                k = 0
                while len(uniform) < need and k < len(states):
                    idx = int(k * step)
                    if idx >= len(states):
                        break
                    if idx not in taken:
                        uniform.append(idx)
                        taken.add(idx)
                    k += 1
            chosen_indices = sorted(set(tactical_pick + uniform))
        else:
            step = len(states) / max_per_game
            chosen_indices = sorted(set(int(i * step) for i in range(max_per_game)))

    for i in chosen_indices:
        snap, side, point, is_tac = states[i]
        yield (snap, side, point, is_tac)
使用したモデル: Qwen3-VL-8B-Instruct + LoRA アダプター(lora_mix_qwen_r5)。全ソースとモデルの説明は「8. 全ソースコードと使用したモデル」の記事で見られます。
COMMENTS · CHAPTER 02
SGF棋譜を学習データに変える コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める