最初のヒューリスティック
囲碁のヒューリスティックは、最初から中央に石を置き始め、とぐろを巻くように中央にだけ手を打っていました。ときどきAIの手に応じながら、当時のAIの異常な反応を引き出して勝つことがよくありました。知能というより、ただの石の塊に近いものでした。
R5 を相手に直す
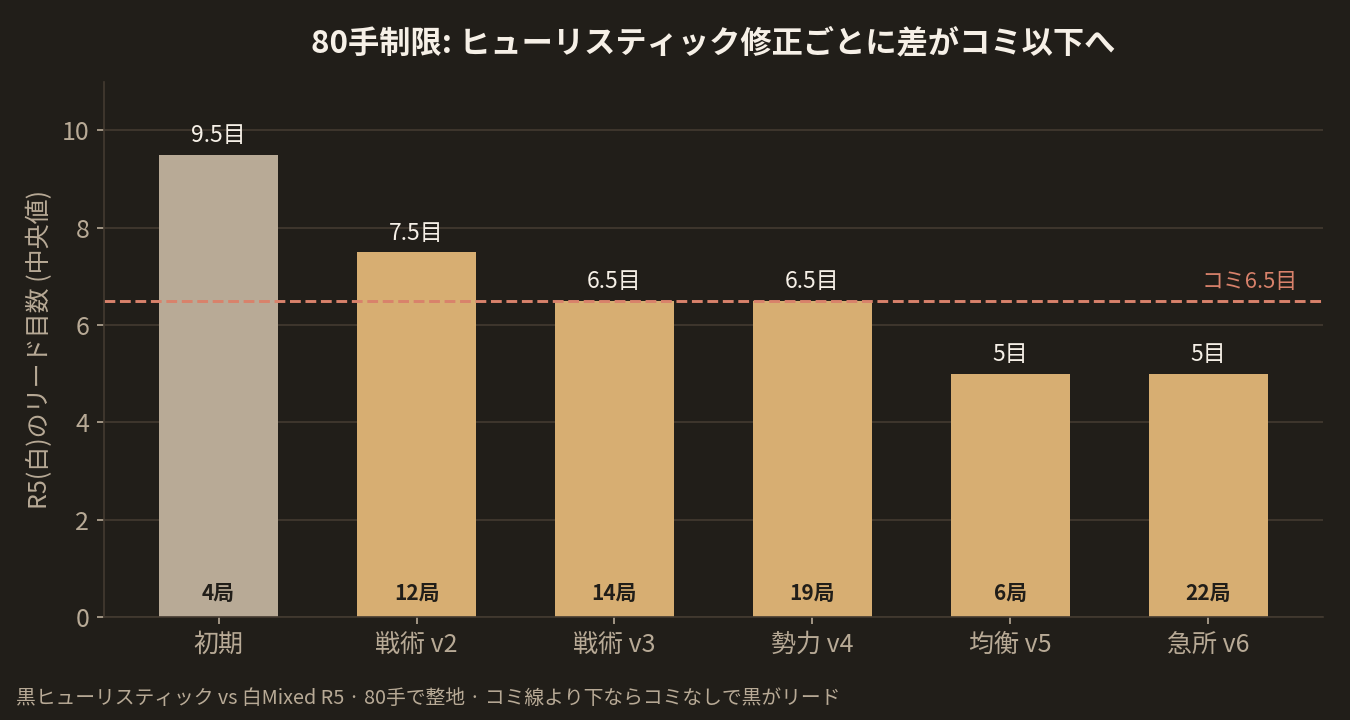
そこで、最近学習したモデルである Mixed R5 を相手にヒューリスティックを直し始めました。ヒューリスティックが黒、R5 が白を持ち、80手まで打ってから整地しました。一日で五回直しました。
- 戦術: 取れる石は取り、アタリにされた石は助け、自分からアタリに入る手は避けます。
- 布石: 序盤の70手までは隅の3・4線を先に打ち、1・2線や理由のない中央への散開は避けます。中央のとぐろはここで消えました。
- 勢力: 一間跳び、ケイマ、二間開きのように、自分の石とゆるくつながる手を優先します。
- 急所: 助けられるアタリの石があれば、ほかの手より先に助けます。
- R5 との対局で確認したミス: 虎の口に入る手、空回りするシチョウ、自分の地を埋める手、近くの両アタリを減点します。
修正後のヒューリスティックはすぐにまともになり、やがて R5 よりヒューリスティックのほうが上手に打っているように見えました。80手の制限のため白がコミで勝ちはしましたが、ほぼ互角でした。最後のバージョンは22局中21局負けましたが、R5 がリードした差の中央値は5目で、コミの6.5目より小さくなりました。22局中12局は、コミを除けばヒューリスティックがリードしていました。実際、コミがなければ R5 が負けていたはずです。
手数の制限を延ばし、互いに学ばせる
そこで手数の制限を150手に上げ、100局連続で対戦させました。記録が残った78局でヒューリスティックが47勝31敗とリードしました。
続いて、対局の内容をヒューリスティックと R5 にそのまま反映しました。片方が打った手のうち、石を取った手、アタリにされた石を助けた手、実際に取れるシチョウだけを選び、相手側に加点として渡します。PASS、自殺手、虎の口、空回りするシチョウは渡さず、勝った側の手は二倍に積みます。このように互いに学ばせた後、150手で189局打ったところ、ヒューリスティックが125勝64敗でした。
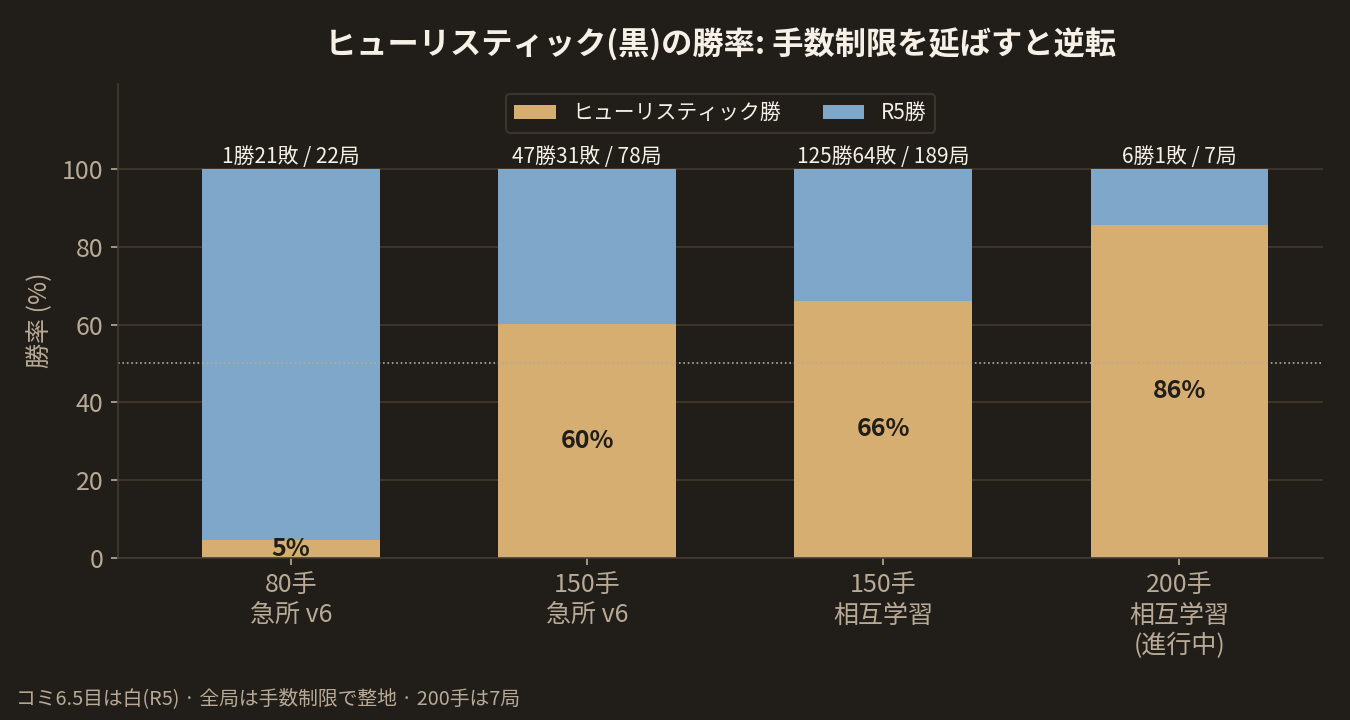
今は手数の制限を200手に上げて40局を回しています。結果はまだ分かりませんが、ヒューリスティックと R5 に驚くような変化が出始めました。これまでに終わった7局では、ヒューリスティックが6局勝ちました。
ヒューリスティックが教師になった
互いに渡した加点を数えてみると、ヒューリスティックから R5 へ渡ったほうがはるかに多くなっています。R5 はヒューリスティックから石の取りとシチョウを学び、ヒューリスティックは R5 から主にアタリにされた石を助ける手を学びました。
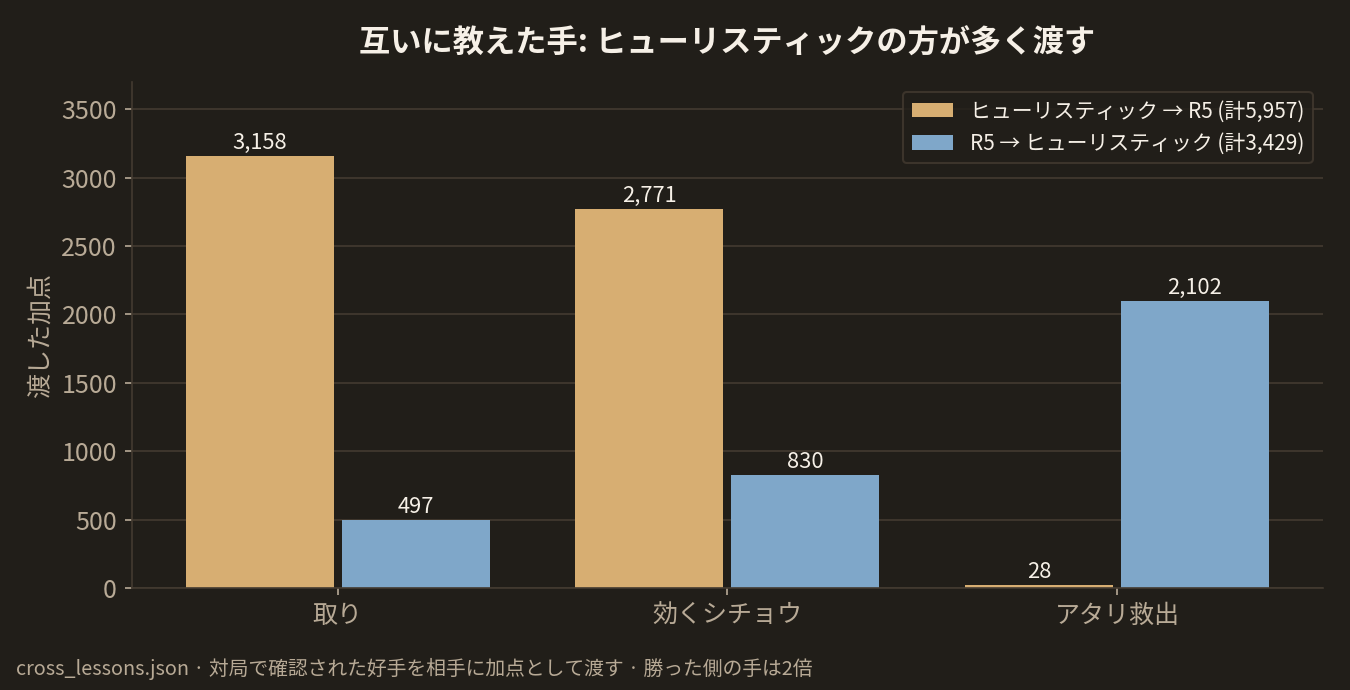
ヒューリスティックを教師にして R5 を教えているわけです。見方によっては、ルールで組んだヒューリスティックが、学習した人工知能より良い手を出しているということです。
すべての対局は、手数の制限で止めた後に地と取った石だけを数えた参考の整地です。死に石の死活は判定していません。
この段階の実際のコード
片方が打った良い手を相手側の表に積む部分です。黒(ヒューリスティック)の手は R5 へ、白(R5)の手はヒューリスティックへ渡り、勝った側の手は二倍に数えます。
vlm_server/cross_lessons.py
def absorb_move(book: dict, actor: str, tags: Iterable[str], winner: Optional[str]) -> None:
    """actor 가 둔 좋은 수를 상대 테이블에 넣는다. actor 는 black|white."""
    tags = [t for t in tags if t in ("capture", "atari_save", "working_chase")]
    if not tags:
        return
    if actor == "white":
        target = "to_heuristic"
        weight = 2 if winner == "white" else 1
    else:
        target = "to_r5"
        weight = 2 if winner == "black" else 1
    _add_tags(book, target, tags, weight)
R5 との対局で確認したミスをヒューリスティックの点数に入れる部分です。虎の口と空回りするシチョウは大きく減点し、実際に取れるシチョウには学んだ分だけ加点します。
vlm_server/cross_lessons.py
def r5_live_delta(board, r: int, c: int, who: int) -> int:
    cells = _cells(board)
    score = 0
    hogu = hogu_verdict(cells, r, c, who)
    if hogu == "hogu_entry":
        score -= 9000
    elif hogu == "hogu_fill":
        score -= 2000
    if (r, c) in _futile_points(cells, who):
        score -= 14000

    if _puts_opponent_in_atari(cells, r, c, who):
        verdict = chase_verdict(cells, r, c, who)
        if verdict is not None:
            if verdict.kind == "working_chase":
                score += 2500 + verdict.group_size * 80
                score += int(_bonus(load_book(), "to_heuristic", ("working_chase",), 35.0, 1400.0))
            elif verdict.kind == "broken_chase":
                score -= 2000

    if _own_territory_fill(cells, r, c, who):
        score -= 3500
    if _nearby_double_atari(cells, r, c, who):
        score -= 6000
    return score
使用したモデル: Qwen3-VL-8B-Instruct + LoRA アダプター(lora_mix_qwen_r5)。全ソースとモデルの説明は「8. 全ソースコードと使用したモデル」の記事で見られます。
COMMENTS · CHAPTER 07
囲碁のヒューリスティックを直す コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める