方式
llm_macro_client.py は Qt の画面につながるクライアントです。
- 受け取った盤から動いているブロックを消し、固まったブロックだけを残します。
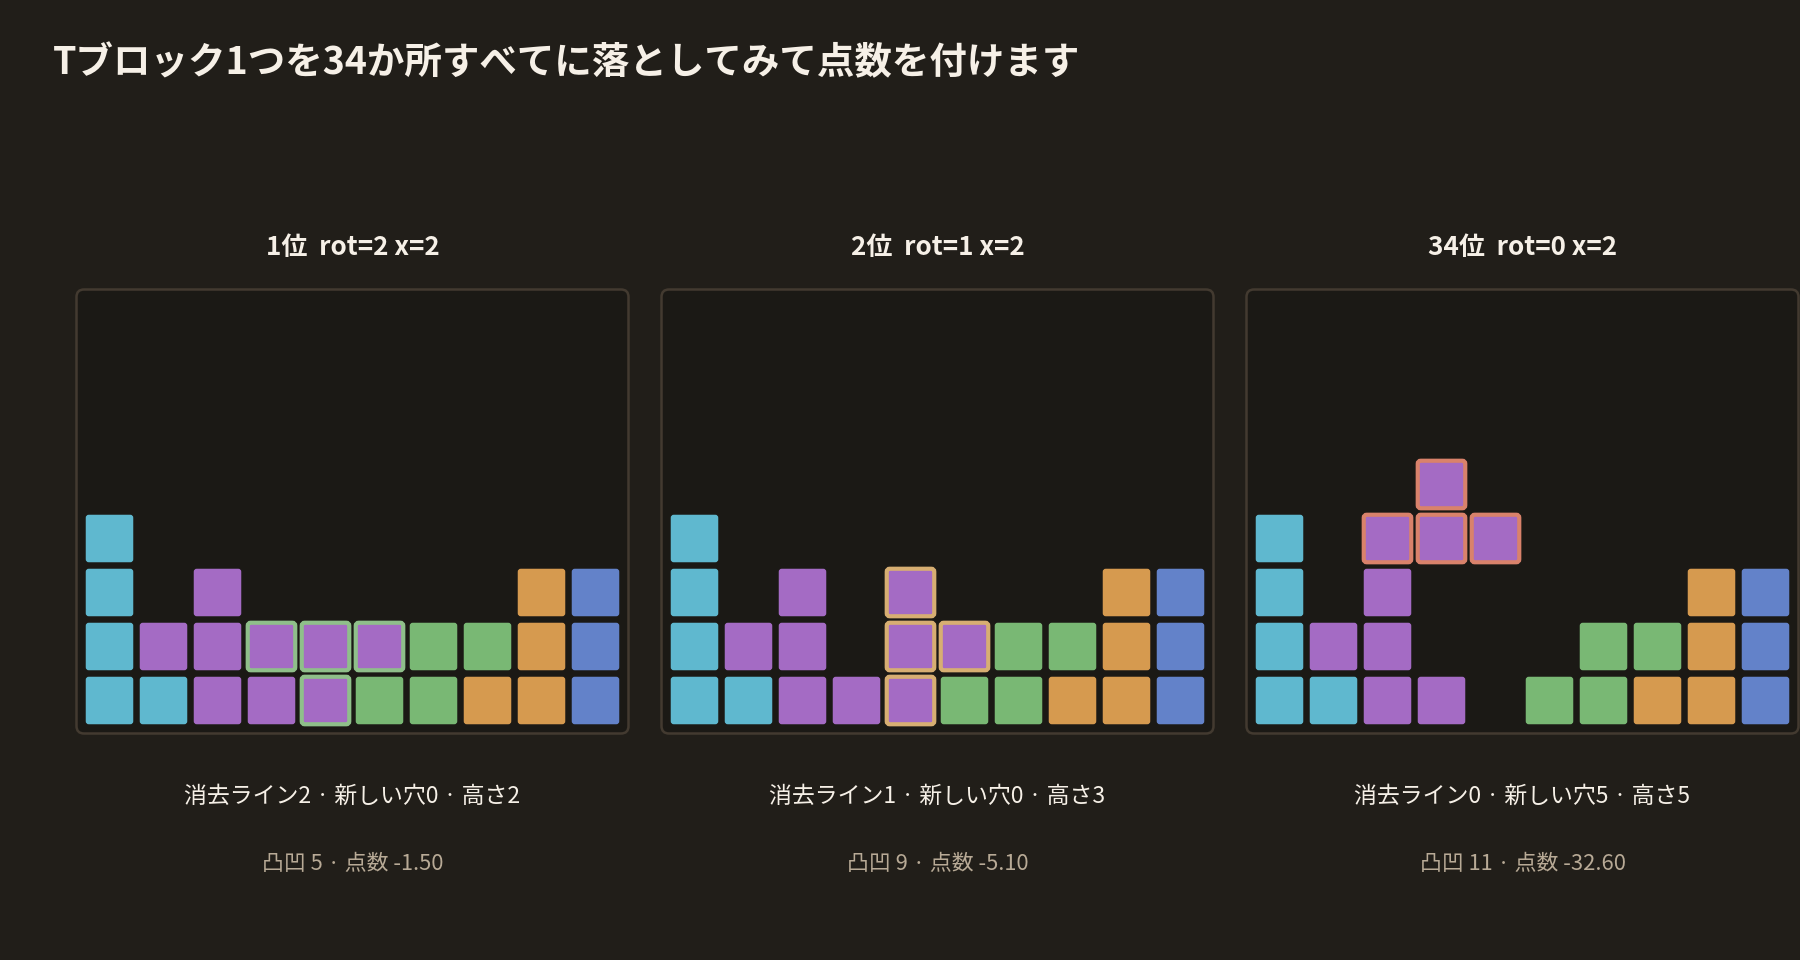
- 現在のブロックを回転ごと、x ごとに落としてみます。T ブロックなら34か所です。x が負の場所も入れます。
- 場所ごとに、消したライン、新しい穴、穴の上に積んだマス、凸凹、最高の高さ、着地の高さ、井戸を計算して点数を付けます。
- 次のブロックまでもう一度置いてみて、その最高点の0.7倍を足して順位を付け直します。
- 上位6つを文字の盤と一緒に LLM(Qwen2.5-3B GGUF)に見せ、番号だけを選ばせます。LLM が座標を作ることはできません。
- 選んだ場所に合わせて回転と移動をそろえ、すぐに落とします。
--no-llm を付けると、LLM なしで1位を使います。
ヒューリスティックだけで
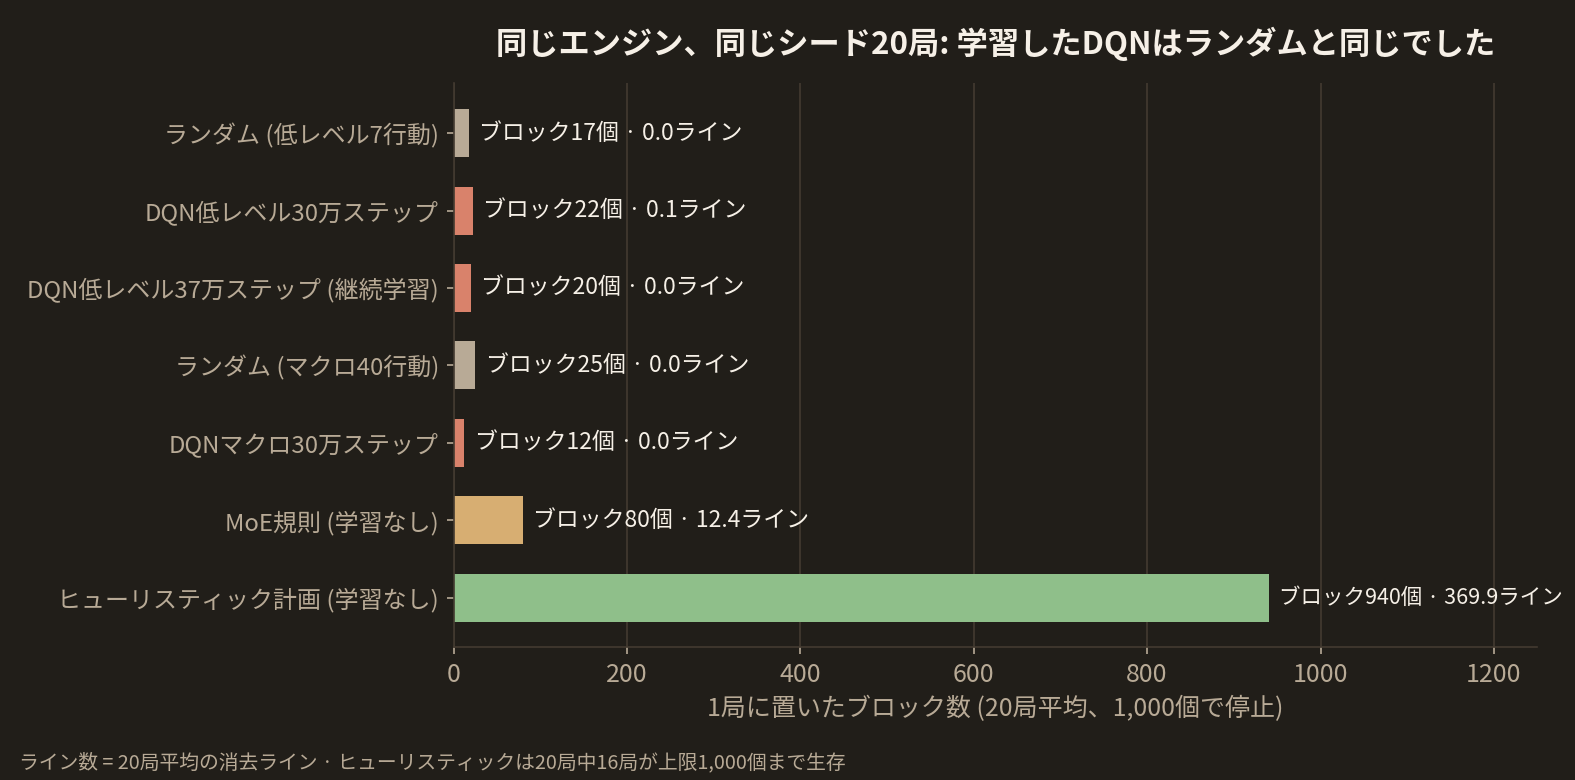
C API は次のブロックを渡さないので、このテストでは4番(もう一つ先のブロックを見る)を除き、1位だけを使いました。同じシードの20局で、ブロック1,000個で止めました。
- 平均ブロック940個、370ライン
- 20局中16局が1,000個まで生き残りました。残りの4局は375、736、811、863個で終わりました。
- 1,000個まで進んだ16局のうち12局は、最後の盤の高さが6マス以下です。
学習なしで点数式一つだけで、DQN(0ライン)と MoE(12ライン)を大きく上回ります。
LLM が選ぶと
LLM をつないで、シード0でブロック150個まで1局回しました。五目並べの学習と GPU を共有しているため、短く終えました。
- 150回中147回(98%)1位を選びました。2位が2回、3位が1回です。
- 55ライン、穴0個、高さ7マスで終わりました。同じ条件でヒューリスティックの1位だけを使うと58ラインです。
- 1回選ぶのに平均1.7秒かかりました。ヒューリスティックだけなら、20局、ブロック1万8千個あまりを14秒で打ちます。
プロンプトが「[0]が条件を満たすなら0を選べ」と言い、候補もすでに点数順なので、LLM はほぼヒューリスティックに従います。今の構造では、LLM は盤を良くすることはできず、遅くするだけです。
まとめ
- 低レベル DQN: ラインの報酬をほとんど見られないので、ランダムと同じです。
- マクロ DQN: 行動の表現が一番左の列を塞ぎ、中央の2か所だけを繰り返します。
- VLM の報酬と VLM の直接選択: 盤を見分けられず、中央に積みます。
- 候補の計算と点数: 学習なしで1,000個を超えます。LLM は1位を確認する程度です。
次は、マクロ行動を実際に置ける162か所に変え、ヒューリスティックの計画器が打った盤を手本に DQN を学習し直してみるつもりです。
この段階の実際のコード
場所一つの点数です。
llm_macro_client.py
on_hole_w = 3.0 * max(0.2, 1.0 - max_h_global / 16.0)

score = (
    + 1.0 * cleared
    - 4.0 * new_holes
    - on_hole_w * cells_above_hole
    - 0.36 * holes_after
    - 1.00 * max_h            # 0.5 → 1.0 (높이 누적 강하게 회피)
    - 0.30 * bump_eff         # 0.18 → 0.30 (양쪽 우물 패턴 회피)
    - 0.70 * landing_height   # 0.5 → 0.7 (깊게 박기 우선)
    - 0.40 * other_well_sum
    + 0.30 * well_bonus       # 0.5 → 0.3 (테트리스 욕심을 줄임)
)
現在のブロックを置ける場所すべてに落としてみます。
llm_macro_client.py
def enumerate_candidates(board: np.ndarray, ptype: int) -> list[dict]:
    if ptype == 0:
        return []
    heights_before = column_heights(board)
    hole_cols_before = column_hole_count(board, heights_before)
    holes_before = sum(hole_cols_before)

    nrot = _PIECE_NROT[ptype]
    w = board.shape[1]
    cands = []
    for rot in range(nrot):
        cells = PIECE_CELLS[ptype][rot]
        min_dx = min(dx for dx, _ in cells)
        max_dx = max(dx for dx, _ in cells)
        x_lo = -min_dx
        x_hi = w - 1 - max_dx
        for x in range(x_lo, x_hi + 1):
            r = evaluate_placement(
                board,
                ptype,
                rot,
                x,
                heights_before=heights_before,
                hole_cols_before=hole_cols_before,
                holes_before=holes_before,
            )
            if r is not None:
                cands.append(r)
    cands.sort(key=lambda r: r["score"], reverse=True)
    return cands
LLM に渡す選択のルールです。
llm_macro_client.py
"Selection priorities (STRICT, in order):\n"
"  1) on_hole == 0  (NEVER stack on a column that already contains buried holes)\n"
"  2) new_holes == 0 (do not create new holes)\n"
"  3) cleared >= 1 (clear lines if possible)\n"
"  4) higher 'look' (1-step lookahead) wins ties\n"
"  5) lower max_h, then lower bump, then lower land_h.\n"
"If [0] already satisfies (1)+(2), just pick 0.\n"
f'Reply EXACTLY as: {{"choice": <integer 0..{len(candidates) - 1}>}}'
次の記事は「6. 全ソースコードと使用したモデル」です。
COMMENTS · CHAPTER 05
場所はコードが計算し、LLM は選ぶだけ コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める