まだ始めていない
オセロには学習コードも学習データもありません。以下は計画です。
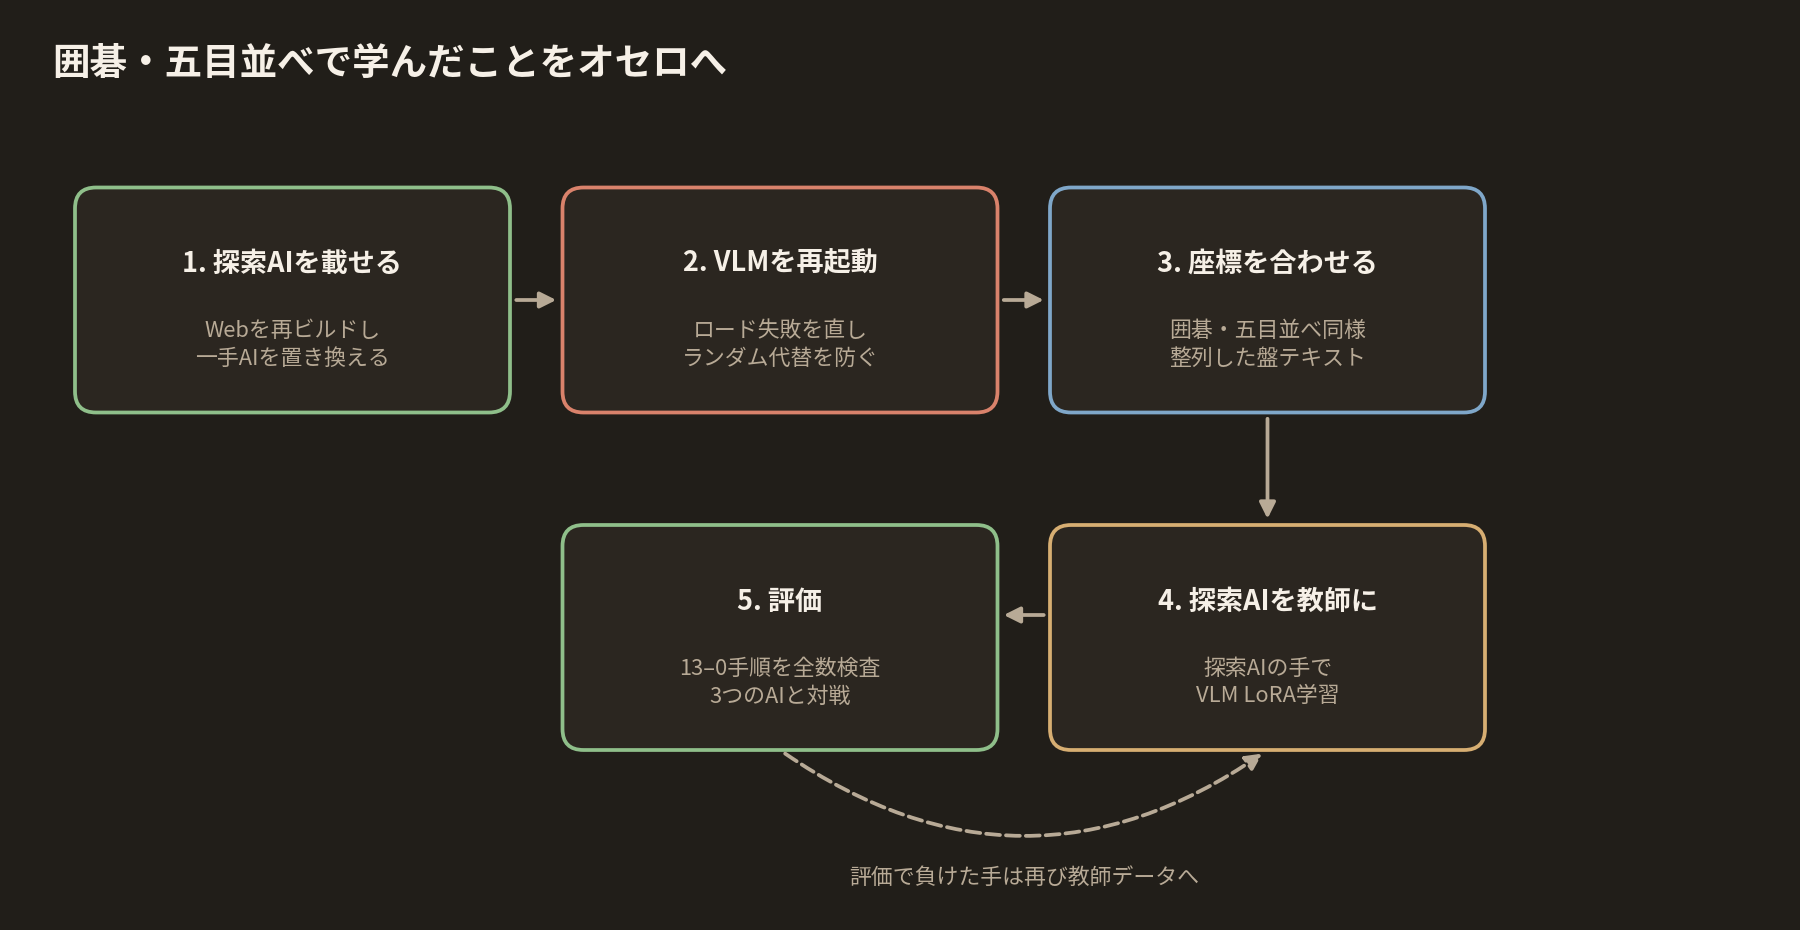
1. 探索AIを公開する
Webをビルドし直せば、2回目の記事の探索AIが公開されます。1回目の記事の13–0の手順はもう通用しません。
2. VLM を再び起動する
読み込みの問題を直すか、囲碁のサーバーで使っている Qwen3-VL-8B に替えます。モデルを読み込めなければサーバーが起動しないようにし、ランダムに切り替えた手は記録に残して画面にも表示します。
3. 座標を合わせる
囲碁では、モデルごとに座標の書き方が違うと分かってから、座標合わせの学習を長く続けました。五目並べにも同じ学習を適用しています。学習前のテストでは、盤のテキストの列を正しく整列させるだけで、すでに石がある場所を選ぶ割合が40%から21%に減りました。
オセロは 8×8 で、プロンプトに合法手のリストがあるので座標の負担は小さいです。それでも同じテストから始めます。
4. 探索AIを教師に
囲碁では、ヒューリスティックを直した後、そのヒューリスティックを教師にしてモデルを学習させました。オセロでは探索AIが教師です。探索AIが選んだ手を正解として VLM の LoRA を学習させます。
正解が毎手の探索で決まるので、五目並べの自動学習のように勝った側の手だけを集めてデータが偏ることはありません。
5. 評価
- 1回目の記事のように、黒の手を11手目まですべて展開して全滅の手順があるかを数えます。
- ランダム、一手AI、探索AIと100局ずつ打ちます。
- 人と打った対局には相手の種類を記録します。今の対局記録にはその欄がありません。
評価で負けた対局の手は、再び教師データとして入れます。
この段階の実際のコード
今 VLM に渡しているプロンプトです。合法手のリストを一緒に渡し、1行のJSONで答えさせます。
vlm_server/server.py
SYSTEM_PROMPT = (
    "당신은 8×8 오델로(Reversi)의 강한 플레이어입니다. "
    "보드 이미지와 텍스트 격자를 보고 다음 단 한 수를 고르세요. "
    "텍스트 격자가 이미지와 다르면 텍스트를 우선하세요. "
    "좌표는 0-indexed 정수 (row, col) 이며 각각 0..7 입니다. "
    "(0,0)은 좌상단 A1, 열 A–H = col 0–7, 행 1–8 = row 0–7. "
    "X=흑, O=백, .=빈칸. 반드시 합법수만 고르세요. "
    "합법수는 상대 돌을 하나 이상 끼워 뒤집는 빈 칸입니다. "
    "응답은 설명 없이 JSON 한 줄만 출력하세요."
)

# ...

def build_prompt(
    board: bytes,
    ai_side: int,
    legal: list[tuple[int, int]],
    forbidden: Optional[list[tuple[int, int]]] = None,
) -> str:
    side = "흑(X)" if ai_side == 1 else "백(O)"
    n_b, n_w = rules.counts(board)
    forbid_note = ""
    if forbidden:
        banned = ", ".join(f"({r},{c})" for r, c in forbidden[:16])
        forbid_note = f"\n금지 좌표(고르지 마세요): {banned}\n"
    return (
        f"당신의 차례: {side}. 흑 {n_b} · 백 {n_w}.\n"
        "보드 (X=흑, O=백, .=빈, 행=row 0=위, 열=col 0=왼쪽):\n"
        f"{rules.board_text(board)}\n\n"
        f"합법수: {rules.format_moves(legal)}\n"
        f"{forbid_note}"
        '다음 수를 JSON 한 줄로만 답하세요. 예: {"row": 2, "col": 3} '
        '합법수가 없으면 {"pass": true} 만 출력.'
    )
次の記事は「5. 全ソースコードと使用したモデル」です。
COMMENTS · CHAPTER 04
囲碁・五目並べで学んだことをオセロに移す計画 コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める