次の段階はオールインを削除することではなく、正当な場面と不当な場面を学習・評価で区別することだ。まず固定のtight/exploitativeヒューリスティック相手を置く。早いオールインには弱手をフォールドし、強度とポットオッズが合えばコール、序盤は小さくベットする。ただし強いハンドや妥当なSPRなら終盤の正当なオールインも行う。
既存コードには次のガードがある。
src/model.cpp
const bool earlyShove = learned == ActType::AllIn &&
    (observation.street < 4 || strength < prior_.allInAbove);
危険行動を検知し別選択へ誘導するcontainmentであり、表面上の事故を抑えるには役立つ。しかし内部の価値推定や信用割当は直さない。ガード有効時の結果だけで学習方針が改善したとは言えない。
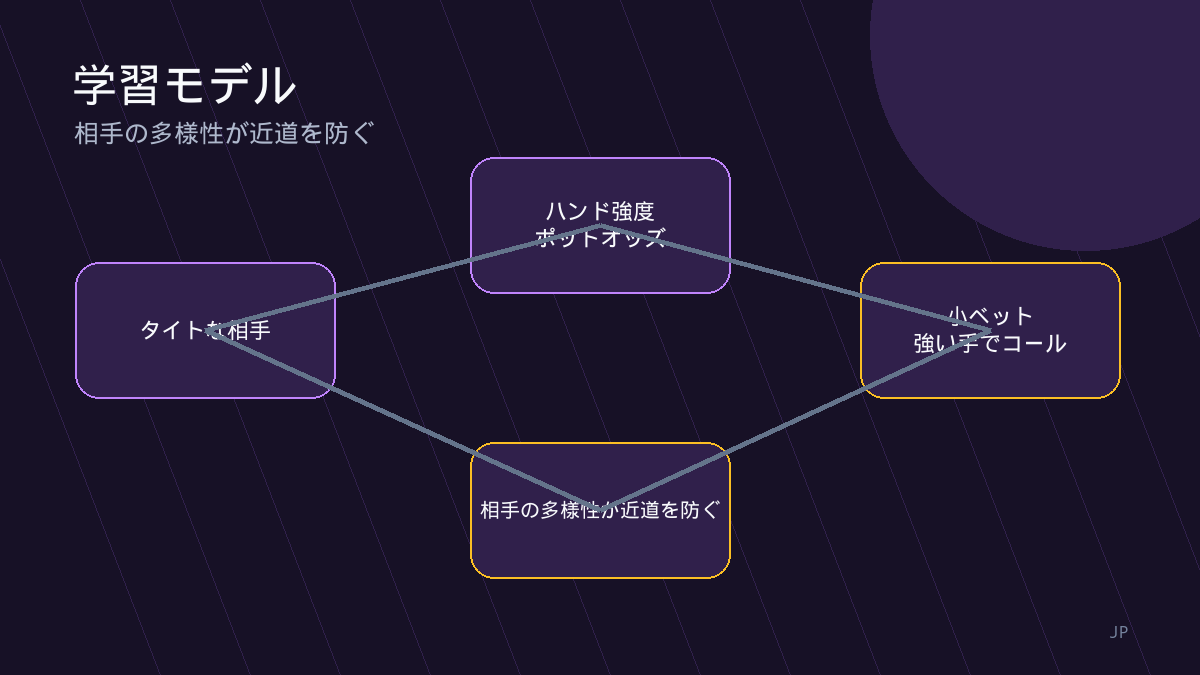
学習相手は一人に限定しない。tight、balanced、looseのヒューリスティックと過去モデルのスナップショットを混ぜ、座席と対戦をランダム化する。固定の攻略相手は回帰テストに残す。特定相手を暗記した方針と、多様なスタイルで耐える方針を区別できる。
報酬はクリップした勝敗ではなく、スタック成長率または対数収益を中心にする。破産には独立したペナルティを置き、根拠なく序盤に全スタックをさらすリスクにも緩やかな罰を与える。強い終盤オールインは罰しない。行動・ストリート別advantageや中間価値で信用を細かく配る。
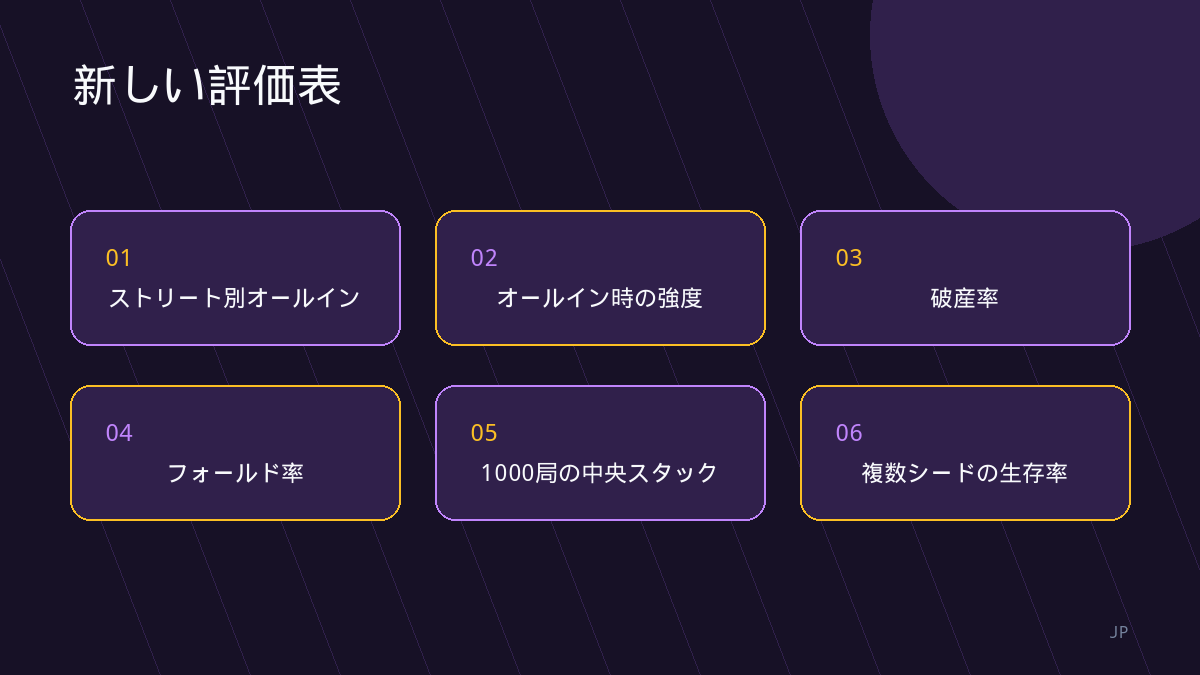
複数のランダムシードで最低1,000ハンドを評価し、ストリート別オールイン率、実行時の平均強度、破産・フォールド率、1,000ハンドの中央値スタックを記録する。平均だけでは稀な破産を隠すため、分布と不確実性も残す。
成功はオールインをゼロにすることではない。弱い序盤オールインが減り、妥当な終盤オールインは残り、相手構成が変わっても中央値スタックと生存性が改善することだ。ガードを外しても改善が残って初めて、方針自体が良くなったと言える。
COMMENTS · CHAPTER 03
オールインを塞ぐのではなく検証する実験設計 コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める