自分で打って学ぶ
順番の暗記をやめて、モデルに自分で盤を打たせました。モデルが手を出すとサーバーが正解と照らし合わせ、間違っていればオラクル(正解を知っているコード)が正しい手を代わりに打ちます。こうして溜まった記録で、3局ごとに LoRA を続けて学習させました。
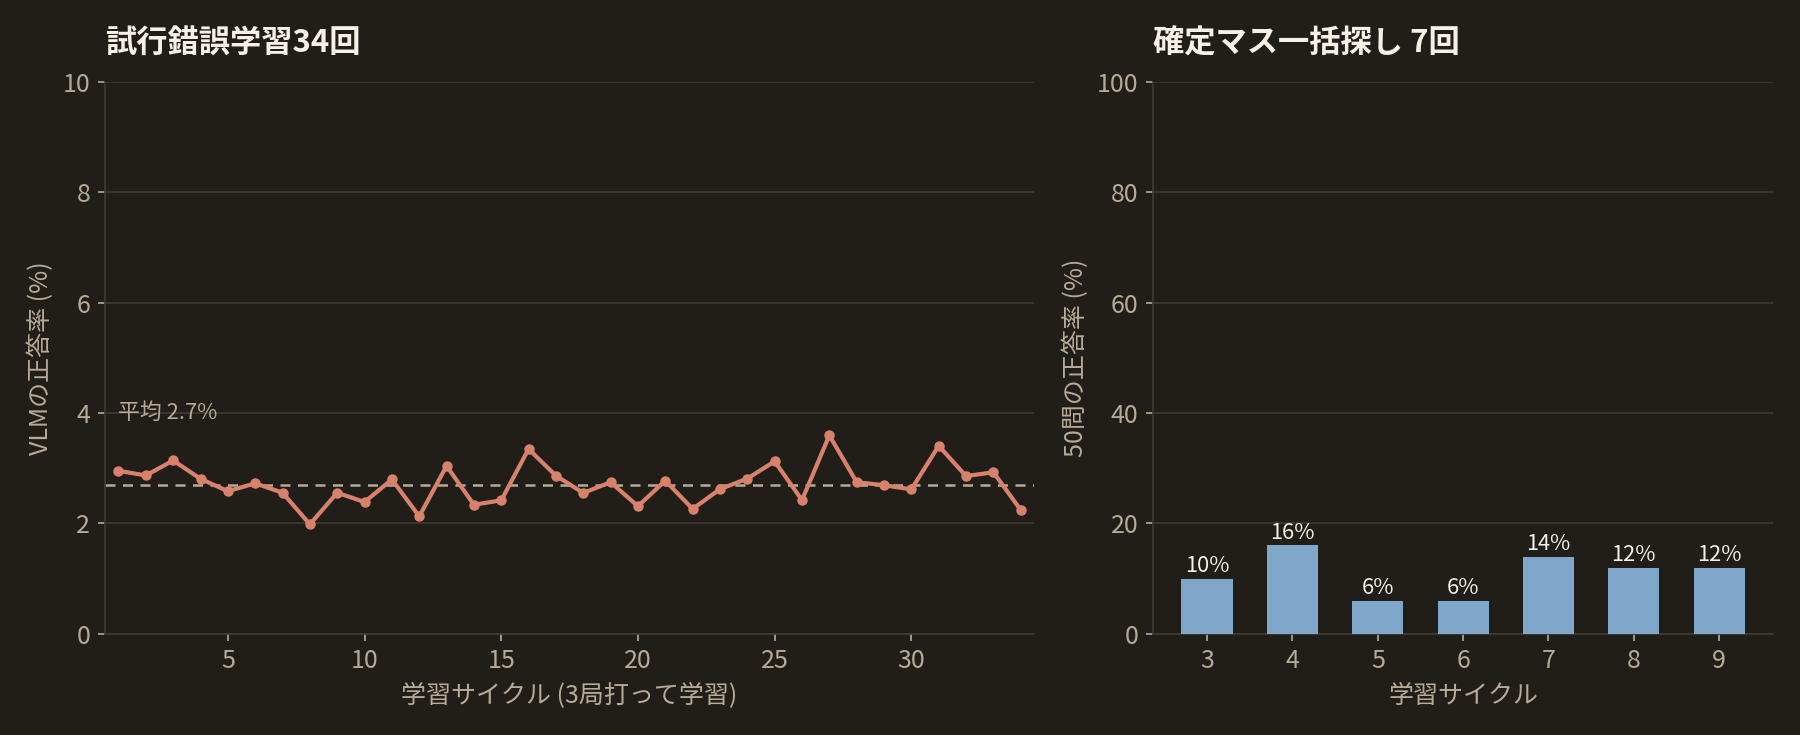
3日間で34サイクルを回しました。モデルが出した手が正解だった割合はサイクルごとに2.0〜3.6%で、全体では62,842回中1,695回(2.7%)でした。学習を重ねても上がりませんでした。
確実なマスを一度に見つける
次は、盤全体から100%確実なマスを一つ直接選ばせました(lora_cell)。間違えた問題を集めて入れ直しながら7サイクル回しましたが、テスト50問の正答率は6〜16%でした。実際の盤で15手打たせると0〜33%でした。
数字とマスを分けて、やさしいほうから教えるカリキュラムも試しました。数字当ては34%から26%に下がり、マス当ては0%から動きませんでした。
オラクルが教えたもの
このころ、人が数独を解く方法を solve.md に別に書きました。その文書に、失敗の理由をこう書きました。
確率が20%未満の値をオラクルは知っていて、その値を VLM に学習させるので、学習された結果に違いがなく、だから VLM には、なぜ正確にこれが正解になるのかという規則性がまったくないように見える。
オラクルはいつも正解を知っています。そのマスが今の盤から推論で決まるマスかどうかは気にしません。盤の中に根拠が見つからない正解が混じっているので、モデルが学ぶべき規則がありませんでした。1回目の記事の正解表と同じ問題でした。
この段階の実際のコード
3局打って学習するループの1サイクルです。盤を打ち、溜まった記録から学習データを取り出し、LoRA を続けて学習します。
vlm_play_train_loop.py
results, play_accuracy = run_games(
    session,
    games=args.games_per_cycle,
    difficulty=args.difficulty,
    max_steps=args.max_steps,
    verbose=args.verbose,
    save_images=None,
    game_id_start=state.game_id_next,
    accuracy=play_accuracy,
    human=args.human,
)
state.game_id_next += args.games_per_cycle
print_summary(results, play_accuracy)
print(f"\n사이클 {cycle} 시도정답률(리젝 포함): {play_accuracy.fmt()}")

# ...

total_lines = count_replay_lines(replay_path)
cycle_jsonl = cycle_sft_dir / f"cycle_{cycle:04d}.jsonl"
kept, new_total, by_outcome = export_trainable(
    replay_path,
    cycle_jsonl,
    since_line=state.replay_line_offset,
)

# ...

t0 = time.monotonic()
exit_code = run_training(
    dataset_jsonl=cycle_jsonl,
    base_model=args.base_model,
    adapter_dir=adapter_in,
    output_dir=args.output_dir,
    device=args.device,
    epochs=args.train_epochs,
    batch_size=args.batch_size,
    grad_accum=args.grad_accum,
)
次の記事は「3. 人の解き方をルールに移す」です。
COMMENTS · CHAPTER 02
試行錯誤では学べなかった コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める