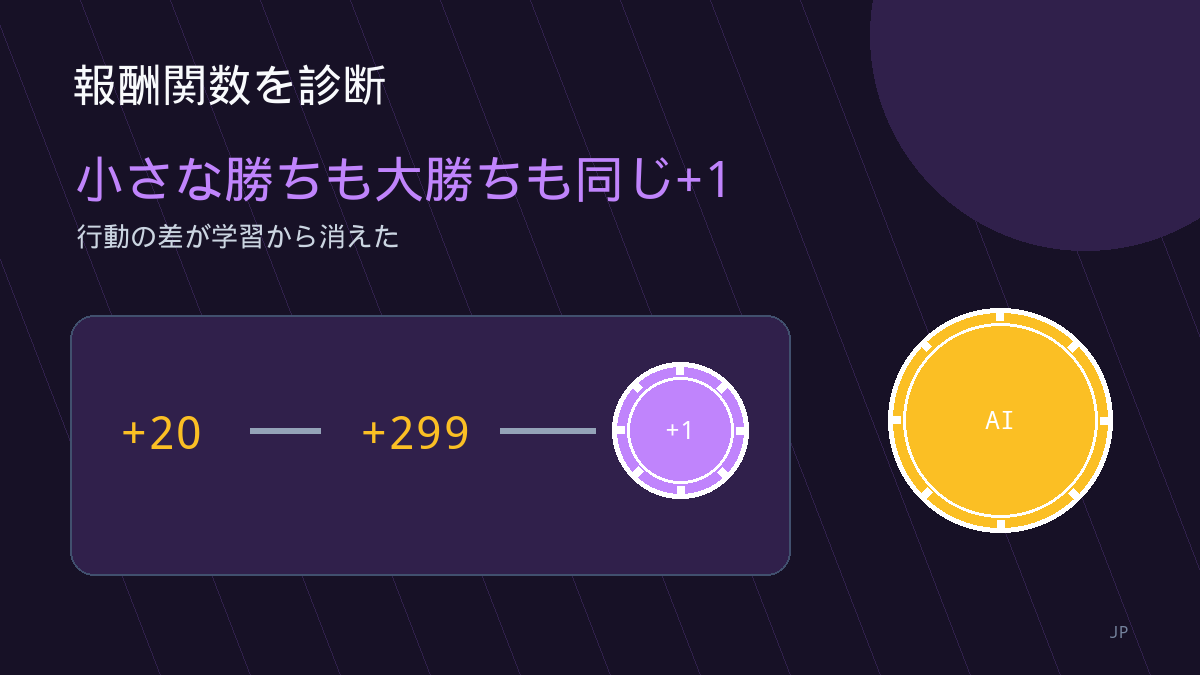
コード上の最初の手掛かりは `finishHand` にある。チップ差を20で割り、-1から+1にクリップしている。
src/model.cpp
const float reward = std::clamp(
    static_cast<float>(chipDelta) / 20.f,
    -1.f,
    1.f
);
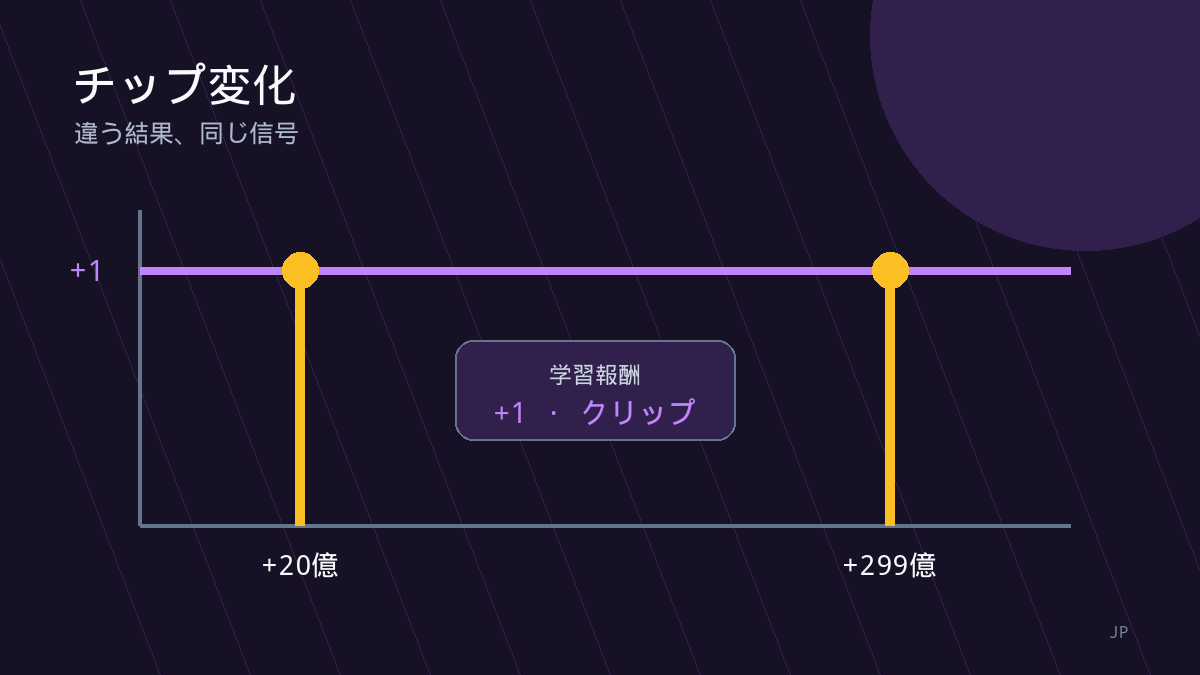
この式では+20の利益も+299の利益も+1になる。-20を超える損失側も同様に平らになる。小さな勝利と大きな勝利の順序情報が消え、効率的なスタック成長より「正の終点へ早く着く」ことが学びやすくなる。
次は信用割当である。同じ終了値がエピソード内の全行動へ与えられる。
src/model.cpp
constexpr float kRate = 0.05f;
for (const Step& step : episode_) {
  for (int i = 0; i < kFeatures; ++i) {
    float& weight = weights_[static_cast<size_t>(step.action * kFeatures + i)];
    weight = std::clamp(weight + kRate * reward * step.features[i], -2.f, 2.f);
  }
}
episode_.clear();
save();
フォールド、チェック、コール、レイズが結果へどう寄与したかを区別しない。オールインでハンドが早く終われば軌跡は短く、同じ+1が少数の判断だけを繰り返し強化し得る。単独原因の証明ではないが、反復しやすい短経路に構造的な利点を与える。
スナップショットも整合する。cheolsuのオールイン合計は+0.818、チェック-1.854、コール-5.013で、オールインのスタック特徴は+0.226。youngheeのオールインはゼロ付近だが、チェックとコールが約-3.657、-3.722なので相対的に魅力がある。一方minsuはオールインではなく `bbing` に傾く。
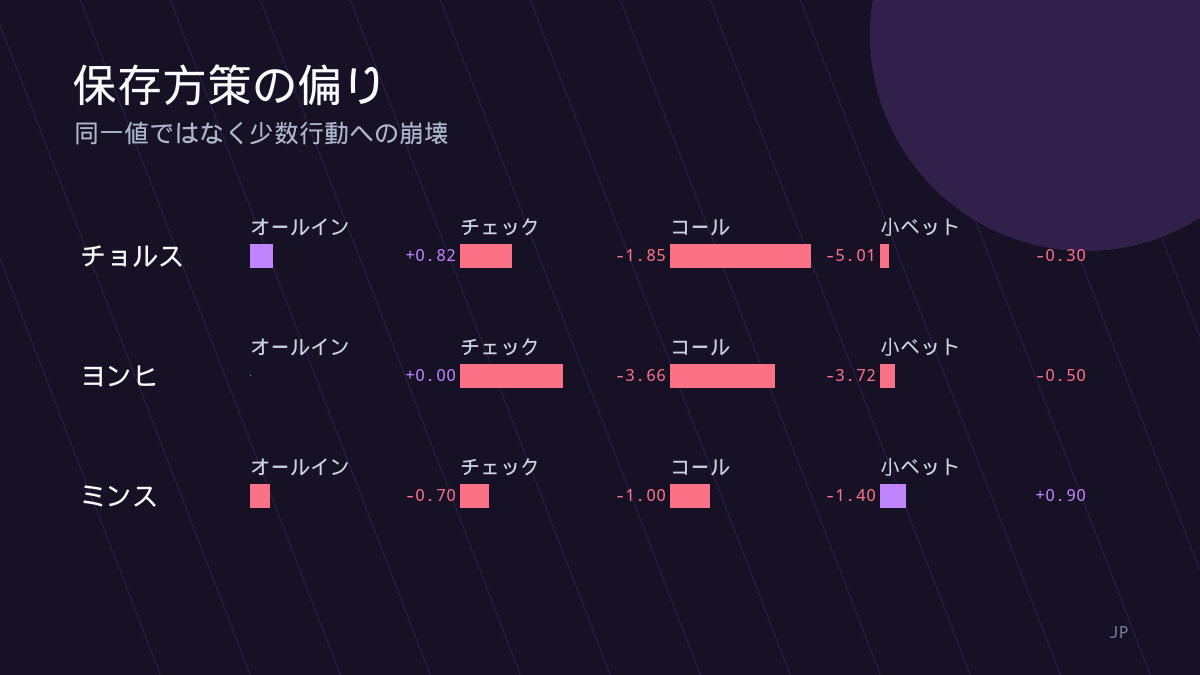
従って全員を「同じオールインAI」と呼ぶのは不正確だ。共通点は少数行動へのpolicy collapseであり、選ばれた行動と重みは異なる。係数一つで方針全体も決まらず、状態特徴、行動ロジット、探索が共同で選択を作る。
これは限定的な診断である。クリッピング、全行動への同一報酬、短い軌跡は観測と整合する有力な仕組みだが、因果確認には各要素を変えた統制実験で行動分布と長期収益を比べる必要がある。
COMMENTS · CHAPTER 02
短い報酬の近道が生んだ政策崩壊をコードで診断する コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める