最初に失敗した理由
初期のモデルは盤の右下の座標をあまりにも頻繁に答えました。棋譜不足のように見えましたが、実際の原因は入力形式でした。学習データには数字付きの整列した盤を使い、実際のサーバーには空白の間隔が異なる盤を送っていました。特に列番号が2桁に変わるところから、石の位置を一路ずつ読み違えていました。
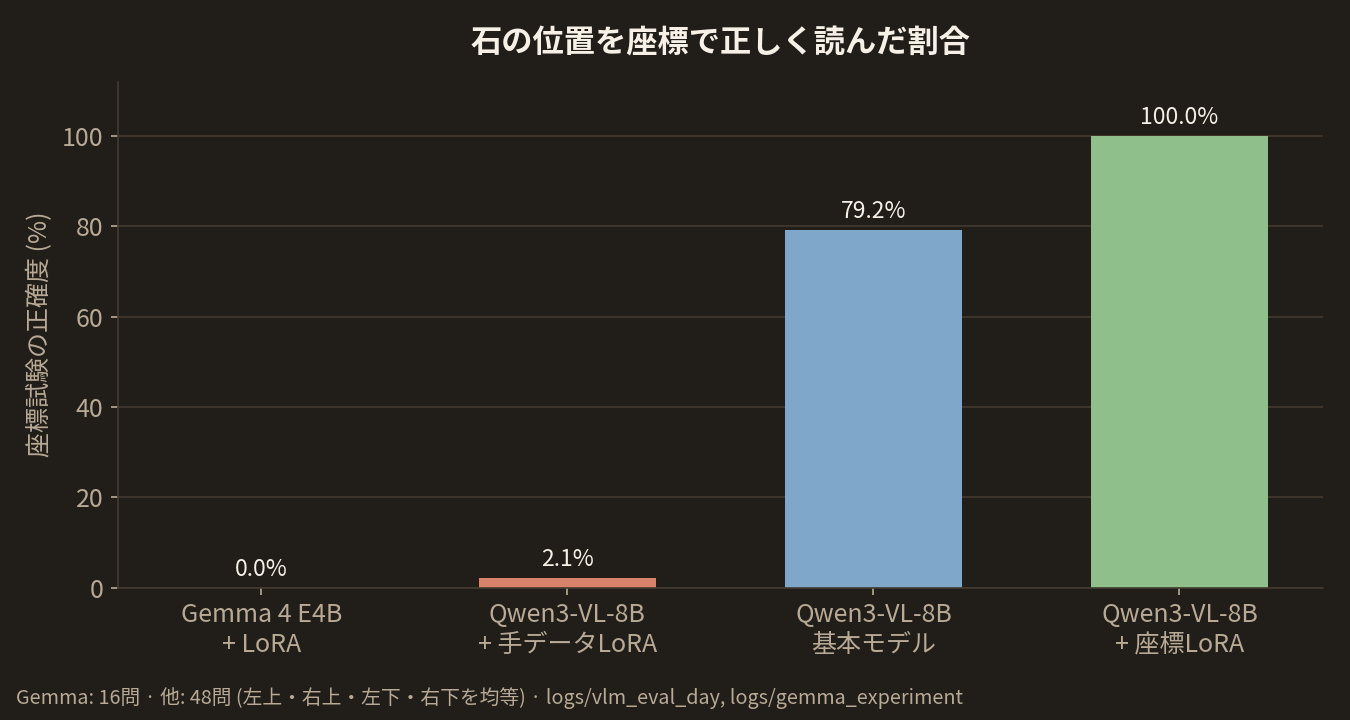
Gemma 4 E4B に LoRA を付けた最初のモデルは、座標テスト16問のうち一問も正解できませんでした。Qwen3-VL-8B に替えた後も、手のデータ400個だけで短く学習したアダプターは2.1%まで落ちました。そこで座標専用のアダプターを先に作り、その上で手を学習しました。
ステップ1: 座標の幅を固定します
行と列は 0、1、2 ではなく 00、01、02 のように2桁で表します。空点、黒石、白石もそれぞれ1文字に固定し、区切りの空白の数を変えません。学習データを作る関数と実際の対局リクエストを作る関数が別々でも、最終的な文字列生成器は一つを共有するのが安全です。
- 列の見出しを00から18まで出力します。
- 各行の前にも00から18まで番号を付けます。
- 空点・黒・白の記号の幅をそろえます。
- 現在の手番と禁止座標は盤の下の決まった位置に書きます。
ステップ2: 先に座標テストを通過させます
棋力の学習の前に、ランダムな一点に石を置いて座標を答えさせます。中央だけをテストせず、左上、右上、左下、右下の四つの区域で同じ数の問題を作ります。全体の正答率が高くても右下だけが低ければ、実際の対局で方向の偏りが生じます。
基本の Qwen3-VL-8B も、右下の正答率が66.7%と四つの区域の中で最も低くなりました。
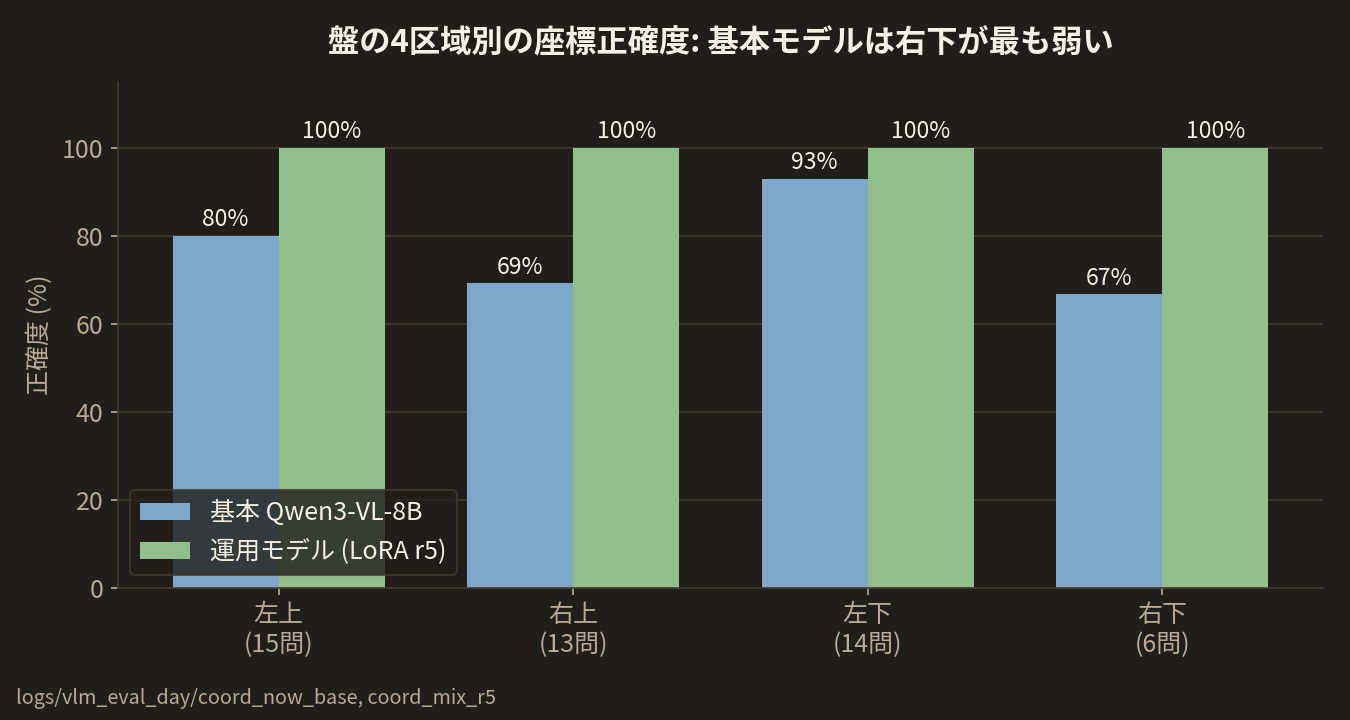
座標テストは、モデルを新たに学習したりプロンプトを変えたりするたびに再実行します。正答率と一緒に、間違えた答えの方向も保存します。一路右に繰り返し間違えるのか、行と列を入れ替えるのかによって、入力の整列と出力のパーサーを別々に点検できます。
ステップ3: 出力形式を絞ります
モデルが長い説明を答えると、座標パーサーが不安定になります。正常な出力は一つの座標または PASS に限ります。説明が付いていても最初の座標だけをこっそり使う方法は誤った手を隠しかねないので、形式エラーとして記録し、決まった回数だけ再要求します。
座標の正確さが確保される前は、棋譜をさらに入れても読み違える癖が強まるだけかもしれません。
この段階の実際のコード
列の見出し、行番号、石の記号をすべて2文字幅にそろえた盤文字列の生成器です。学習データの生成と実際の手の推薦サーバーがこの関数を共用し、入力形式がずれないようにしました。
vlm_server/dataset_baduk.py
def board_text_aligned(cells: bytes, size: int = BOARD_SIZE) -> str:
    """v3 권장: 열·행·셀이 모두 두 글자 토큰으로 정렬.

    셀 기호는 **왼쪽 정렬** (``X `` / ``. ``). 오른쪽 정렬(`` X``)은
    모델이 열을 한 칸 왼쪽(col-1)으로 읽는 오차를 유발했다.
    """
    col_header = "   " + " ".join(f"{c:02d}" for c in range(size))
    lines: List[str] = [col_header]
    for r in range(size):
        cells_s: List[str] = []
        for c in range(size):
            v = cells[r * size + c]
            ch = "." if v == 0 else ("X" if v == 1 else "O")
            cells_s.append(f"{ch:<2}")
        lines.append(f"{r:02d} " + " ".join(cells_s))
    return "\n".join(lines)
モデルの正解出力は、座標一つまたはパスだけを含む1行のJSONに限ります。
vlm_server/dataset_baduk.py
def assistant_text(point: Optional[Tuple[int, int]]) -> str:
    if point is None:
        return '{"pass": true}'
    r, c = point
    return f'{{"row": {r}, "col": {c}}}'
使用したモデル: Qwen3-VL-8B-Instruct + LoRA アダプター(lora_mix_qwen_r5)。全ソースとモデルの説明は「8. 全ソースコードと使用したモデル」の記事で見られます。
COMMENTS · CHAPTER 03
19×19の盤をAIが読める入力にする コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める