学習の設定
- アルゴリズム: stable-baselines3 の DQN。学習率 1e-4、リプレイバッファ10万、バッチ32、4ステップごとに学習、ターゲットネットワークは1万ステップごとに更新します。
- 探索: 最初の20%の間にランダムの割合を1から0.02に下げます。
- ポリシーネットワーク: 観測値が0〜7なので、SB3 は画像と見なさず MlpPolicy を選びます。盤の220マスを1列に広げて入れます。
報酬
ブロックが固まるたびに計算します。
- ラインを消すと1ライン1点、2ライン3点、3ライン10点、4ライン30点
- 低い場所に置くほど少し加点(着地の高さ×0.1)
- 新しくできた穴1つにつき-5
- 盤の高さが上がった行ごとに-2
- 凸凹(隣り合う列の高さの差の合計)×0.02と盤の高さ×0.03を引きます
結果
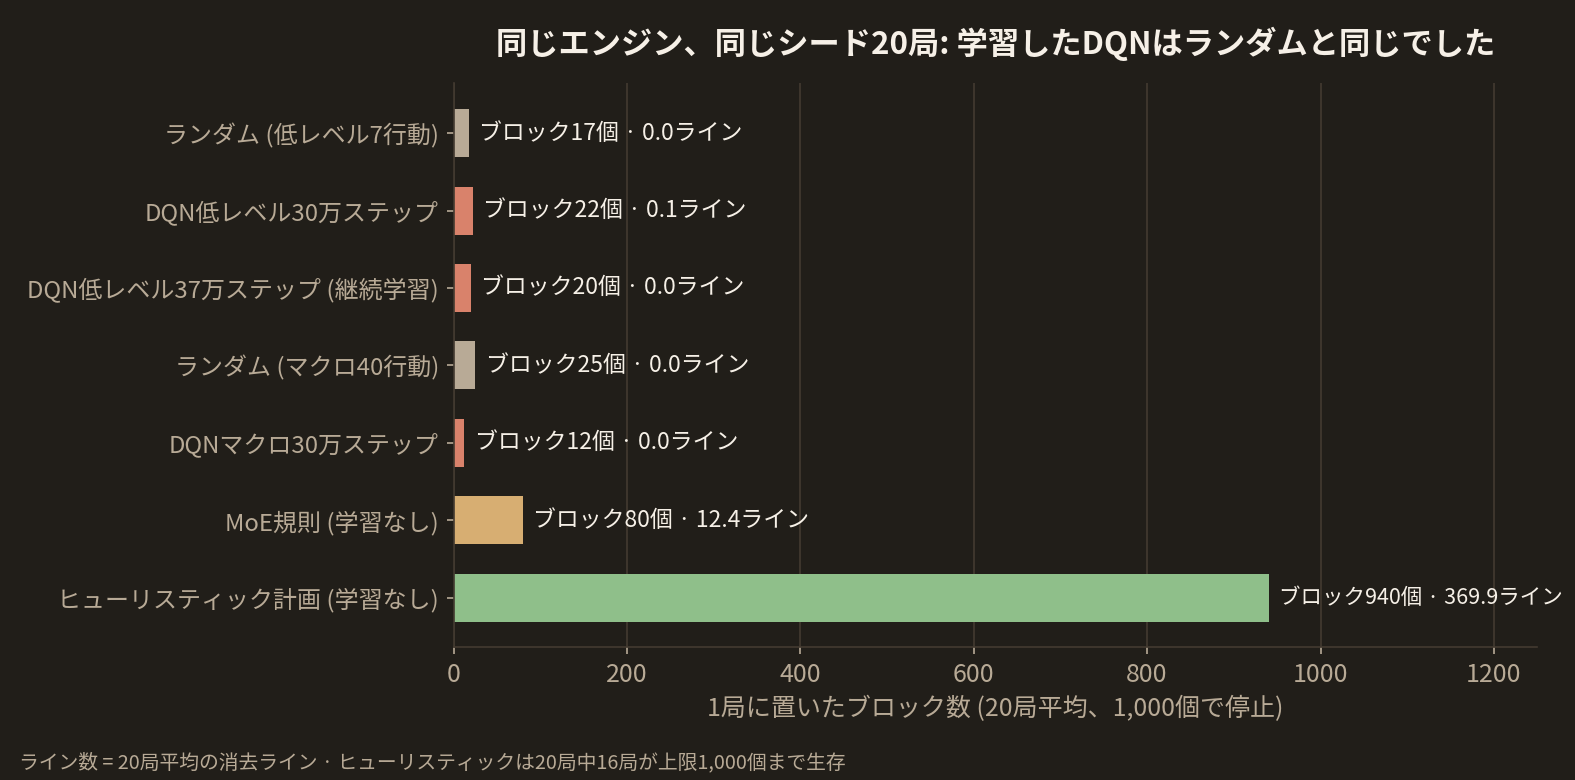
残っている低レベルのモデルは二つです。30万ステップのモデル(live_latest.zip.bak)と、それを続けて学習した37万ステップのモデル(live_latest.zip)です。続きの学習は62万ステップを目標に始めましたが、37万で止まりました。
同じエンジンでシード0〜19の20局ずつ回しました。モデルは毎回、値が最も高い行動を選びました。
- ランダム7行動: 平均ブロック17個、0ライン
- DQN 30万ステップ: 平均ブロック22個、20局合計2ライン
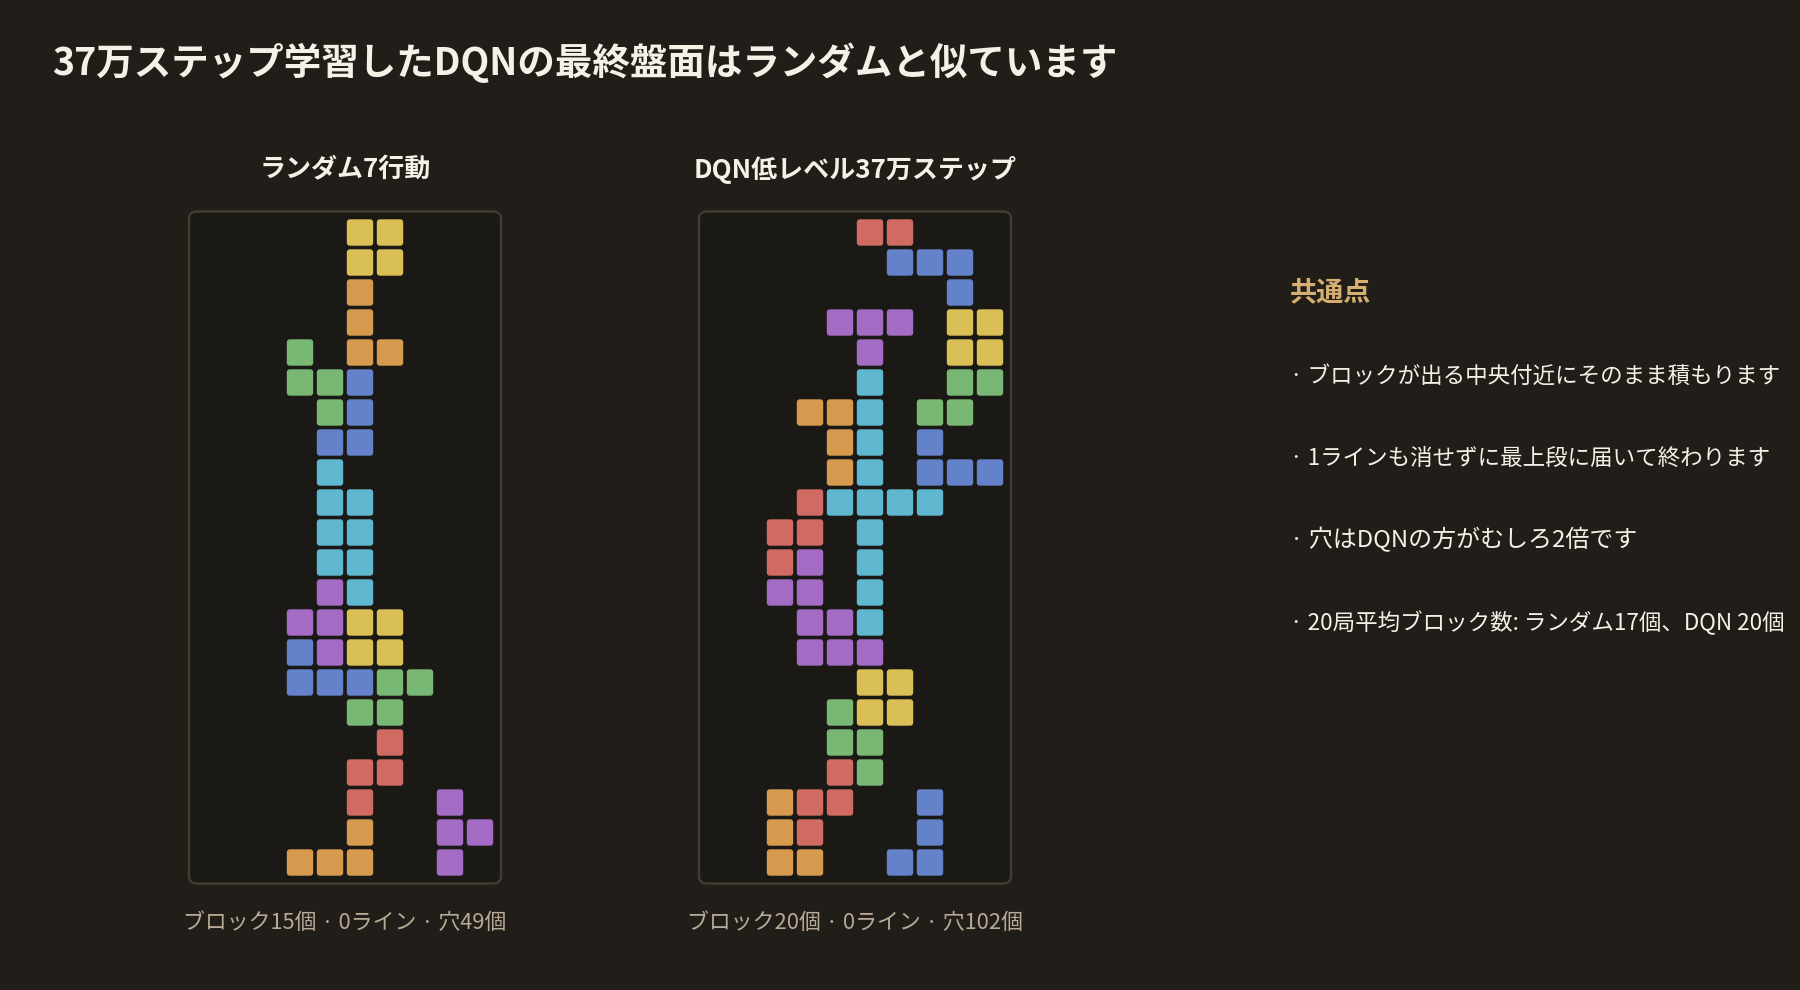
- DQN 37万ステップ: 平均ブロック20個、0ライン
なぜ学べなかったのか
- ラインの報酬を見る機会がほとんどありません。ランダムに押すと20局の間に1ラインも消せません。1ラインを消すにはブロックをいくつも組み合わせて置く必要がありますが、探索中にそうしたことはまれです。学習に入ってくる信号は、ほぼ穴と高さの減点だけです。
- 1つのブロックに20回以上の行動がかかります。場所が良かったかどうかは固まった瞬間にしか分からず、その前の移動と回転のどれが良かったのかを分けるのは難しいです。
- 盤を広げた220個の数字を小さな MLP が見ます。ブロックの形や位置関係を読み取りにくく、次のブロックも知りません。
そこで、行動をブロックごとに1回に減らし、VLM に報酬を手伝わせました。
この段階の実際のコード
ブロックが固まるときにエンジンが計算する報酬です。
tetris/src/tetris_engine.cpp
// Line clear reward (non-linear scaling)
double line_r = 0.0;
switch (cleared) {
    case 1: line_r = cfg_.line_reward_1; break;
    case 2: line_r = cfg_.line_reward_2; break;
    case 3: line_r = cfg_.line_reward_3; break;
    case 4: line_r = cfg_.line_reward_4; break;
    default: break;
}

// Height reward: lower placement = higher reward
double height_r = cfg_.height_reward_scale * landing_y;

const int holes_after = count_holes();
const int new_holes = holes_after - holes_before;
double hole_penalty = 0.0;
if (new_holes > 0) {
    hole_penalty = cfg_.hole_penalty_scale * static_cast<double>(new_holes);
}

// Stack height penalty: penalize increases of the board height (after line clears)
double height_penalty = 0.0;
if (cfg_.stack_height_penalty_scale > 0.0) {
    const int height_after = stack_height();
    const int dh = height_after - height_before;
    if (dh > 0) {
        height_penalty = cfg_.stack_height_penalty_scale * static_cast<double>(dh);
    }
}

// Surface shaping penalties (post line-clear)
double bump_penalty = 0.0;
if (cfg_.bumpiness_penalty_scale > 0.0) {
    bump_penalty = cfg_.bumpiness_penalty_scale * static_cast<double>(bumpiness());
}
double max_height_penalty = 0.0;
if (cfg_.max_height_penalty_scale > 0.0) {
    max_height_penalty = cfg_.max_height_penalty_scale * static_cast<double>(stack_height());
}

last_reward_ += line_r + height_r - hole_penalty - height_penalty - bump_penalty - max_height_penalty;
報酬の大きさと DQN の設定です。
config/rl_config.py
    # ── 보상/패널티 스케일 (C++ 엔진으로 전달) ───────────────────────────────
    # 한쪽으로 몰빵되는 탑쌓기를 억제하려면 아래 2개를 켜는 게 효과적
    stack_height_penalty_scale: float = 2.0   # 스택 높이 "증가분" 패널티 (권장 0.5~5.0)
    # bumpiness는 값 범위가 커서(최대 수백) 스케일을 너무 크게 주면 보상이 붕괴합니다.
    bumpiness_penalty_scale: float = 0.02     # 인접 열 높이 차이 합 패널티 (권장 0.005~0.05)
    max_height_penalty_scale: float = 0.03    # 절대 스택 높이 패널티 (권장 0.0~0.1)


@dataclass(frozen=True)
class DQNConfig:
    timesteps: int = 300_000
    learning_rate: float = 1e-4
    buffer_size: int = 100_000
    batch_size: int = 32
    train_freq: int = 4
    target_update_interval: int = 10_000
    exploration_fraction: float = 0.2
    exploration_final_eps: float = 0.02
次の記事は「3. ブロックごとに1回選ぶマクロ行動と VLM の報酬」です。
COMMENTS · CHAPTER 02
DQN を37万ステップ、消したラインは0本 コメント 0
まだコメントはありません。気になった点や補足があれば残してください。
コメントを登録するには、Googleで始めてニックネームとメールアドレスを登録してください。
Googleで始める