什么才算“变好了”
训练损失下降,并不代表实际对局变好了。围棋AI必须能读懂坐标、下出合法着法、在激战中不停一手,也不会不必要地填掉自己的眼。在更换模型之前,必须在同一套评估集上测量这些项目。
第1步:拆分评估项目
坐标测试衡量的是能否准确读取棋子位置。规则测试统计模型下出非法着法的比例。对局测试与固定的对手交换黑白对弈,并记录提子、停一手的时机和结束原因。如果把不同的失败合并成一个胜率,就无法知道该修正什么。
- 四个象限的坐标准确率
- 首次回答和重新请求时的非法着法比例
- 第80手之前过早停一手的次数
- 反复选择同一列、同一角的方向偏差
- 交换黑白后对局的提子和最终结果
第2步:保存基准模型的结果
不要只运行新模型,要把当前线上模型的结果以相同的JSON格式保存下来。必须一并写下评估数据版本、模型名称、提示词和规则引擎的提交,日后才能复现这些数字。如果存在随机性,还要固定种子和生成设置。
第3步:标明短对局的局限
在第80手中断后的临时数子,对于快速回归检查很有用,但不能解读为正式胜率或段级位。因为死活判定和收官还没有完成。短评估只看非法着法、过早停一手和明显的战术损失,棋力比较则要收集足够多的完整对局另行判断。
第4步:把失败案例连接到下一批数据
评估中反复出现的失败,要把盘面状态、模型的原始回复和拒绝理由捆绑在一起保存。坐标错误归入输入测试,征子的无效逃跑归入战术样本,过早停一手归入进行中盘面的样本。不要把所有失败一股脑儿地放进训练,而要把能用规则代码可靠阻止的问题和模型必须学习的问题区分开。
好的评估表不是用来夸奖模型的分数,而是告诉你下一步该修哪里的地图。
实际记录
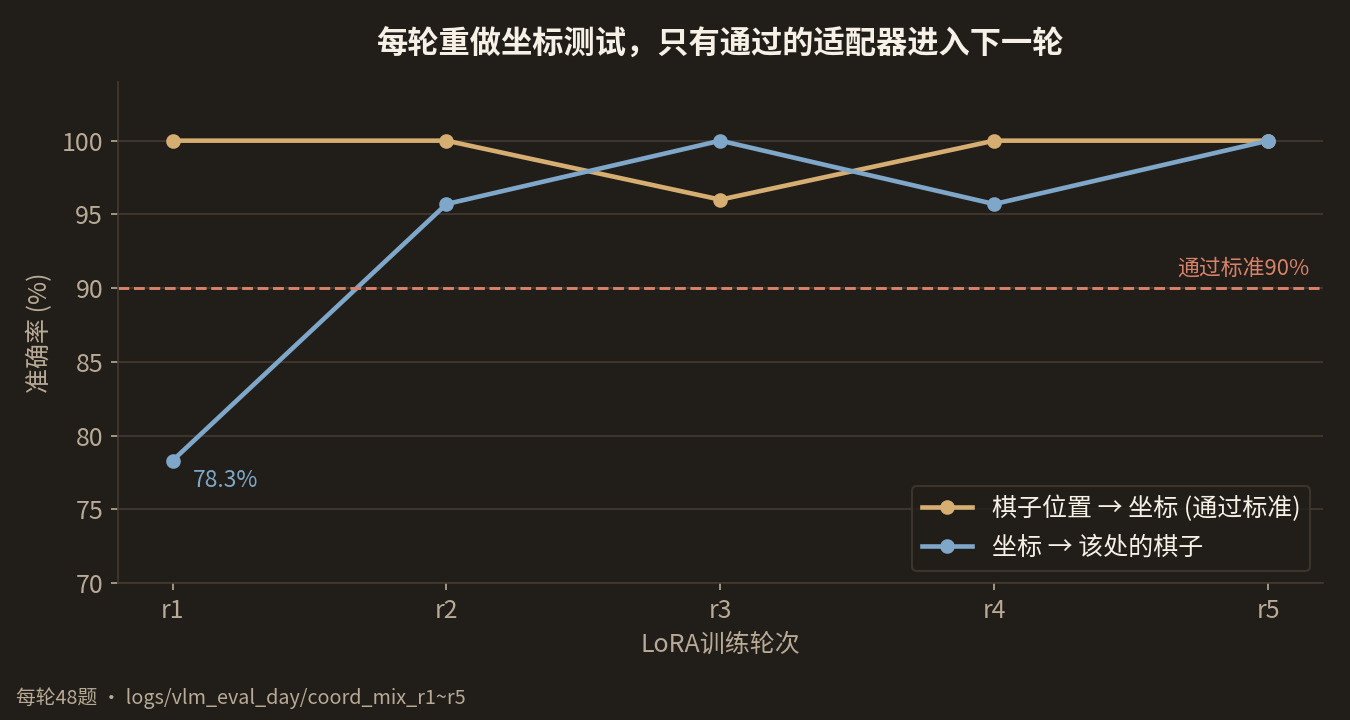
把LoRA分五轮训练时,每一轮都重新做了同样的坐标测试。r1在把棋子位置读成坐标的题目上是100%,但在给出坐标、询问该位置是什么棋子的题目上只有78.3%。如果只看一个项目,就会错过这个差异。
这一步的实际代码
这段代码把坐标测试结果分成左上(TL)、右上(TR)、左下(BL)、右下(BR)四个区域进行统计。除了整体准确率,还保留各区域的准确率,以便立即确认方向偏差。
vlm_server/verify_coords.py
def _quadrant(r: int, c: int) -> str:
    if r < 9.5 and c < 9.5:
        return "TL"
    if r < 9.5 and c >= 9.5:
        return "TR"
    if r >= 9.5 and c < 9.5:
        return "BL"
    return "BR"
vlm_server/verify_coords.py
def summarize(results: List[TrialResult]) -> Dict[str, Any]:
    by_kind = Counter()
    ok_kind = Counter()
    by_q = Counter()
    ok_q = Counter()
    for r in results:
        by_kind[r.kind] += 1
        by_q[r.quadrant] += 1
        if r.ok:
            ok_kind[r.kind] += 1
            ok_q[r.quadrant] += 1
    total = len(results) or 1
    return {
        "n": len(results),
        "accuracy": round(100.0 * sum(1 for r in results if r.ok) / total, 1),
        "by_kind": {
            k: {
                "n": by_kind[k],
                "ok": ok_kind[k],
                "acc": round(100.0 * ok_kind[k] / max(1, by_kind[k]), 1),
            }
            for k in sorted(by_kind)
        },
        "by_quadrant": {
            q: {
                "n": by_q[q],
                "ok": ok_q[q],
                "acc": round(100.0 * ok_q[q] / max(1, by_q[q]), 1),
            }
            for q in ("TL", "TR", "BL", "BR")
        },
        "avg_ms": round(sum(r.ms for r in results) / total, 1),
    }
使用的模型:Qwen3-VL-8B-Instruct + LoRA适配器(lora_mix_qwen_r5)。完整源代码和模型说明可以在“8. 完整源代码与使用的模型”一文中查看。
COMMENTS · CHAPTER 05
在训练之前先固定评估集 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始