最初的启发式
围棋启发式一开始就在中央落子,然后像盘蛇一样只在中央下棋。它常常在应对AI着法的过程中,引出当时AI的异常反应而获胜。与其说是智能,不如说更接近一团棋子。
以R5为对手进行修正
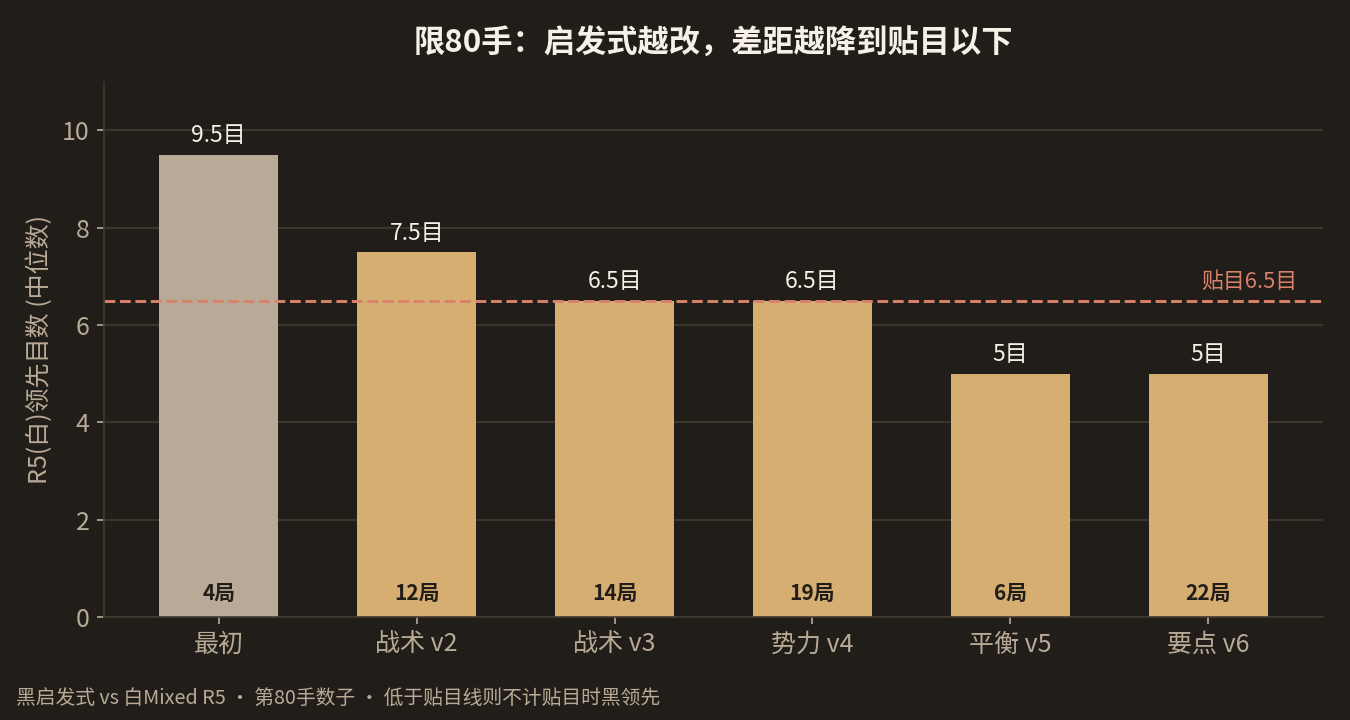
于是我们开始以最近训练的模型Mixed R5为对手来修正启发式。启发式执黑,R5执白,下到第80手后进行数子。一天之内修正了五次。
- 战术:能提的子就提,被叫吃的子要救活,避免自己走进叫吃的着法。
- 布局:在前70手内,先下角上的三、四线,避免一、二线和无理由地在中央分散落子。中央盘蛇的下法就是在这一步消失的。
- 势力:优先下与己方棋子松散相连的着法,比如单关跳、小飞、拆二。
- 要点:如果有能救活的被叫吃的棋子,就先于其他着法救活它。
- 在与R5的对局中确认的失误:对走进虎口的着法、无效的征子、填自己的目以及附近的双叫吃进行扣分。
修正之后,启发式很快就步入正轨,现在看起来启发式甚至比R5下得更好。由于有80手的限制,白棋虽然靠贴目赢了,但几乎是势均力敌。最后一个版本在22局中输了21局,但R5领先差距的中位数是5目,小于6.5目的贴目。22局中有12局在不算贴目的情况下是启发式领先。实际上如果没有贴目,R5就输了。
增加手数限制并让双方互相学习
于是我们把手数限制提高到150手,让双方连续对战100局。在留下记录的78局中,启发式以47胜31负领先。
接着,我们把对局内容直接反映到启发式和R5中。只从一方下出的着法中挑选提子的着法、救活被叫吃棋子的着法以及真正能吃掉的征子,作为加分传给对方。PASS、自杀、虎口和无效的征子不传递,获胜一方的着法则加倍累积。这样让双方互相学习之后,以150手下了189局,启发式是125胜64负。
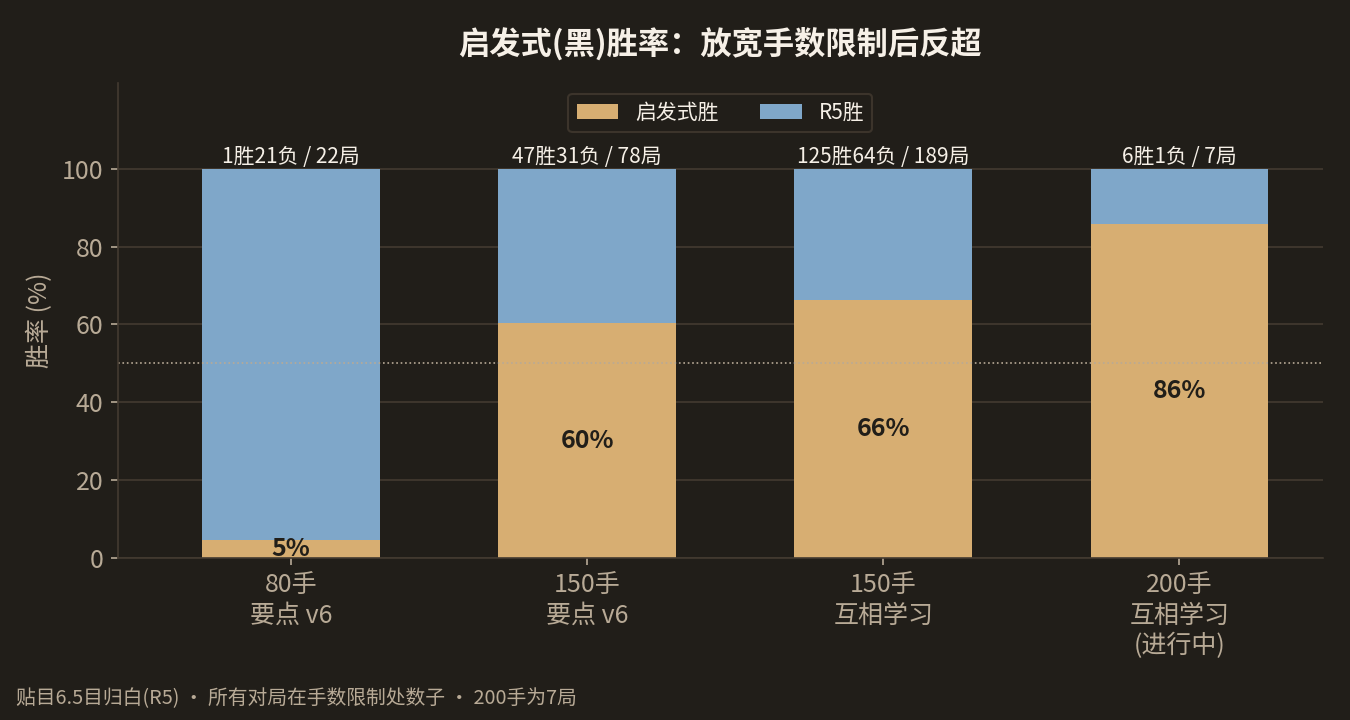
现在正在把手数限制提高到200手,进行40局对弈。结果还不得而知,但启发式和R5都开始出现令人惊讶的变化。在目前已经结束的7局中,启发式赢了6局。
启发式成了老师
统计双方互相传递的加分,从启发式传给R5的要多得多。R5主要从启发式那里学到了提子和征子,而启发式主要从R5那里学到了救活被叫吃棋子的着法。
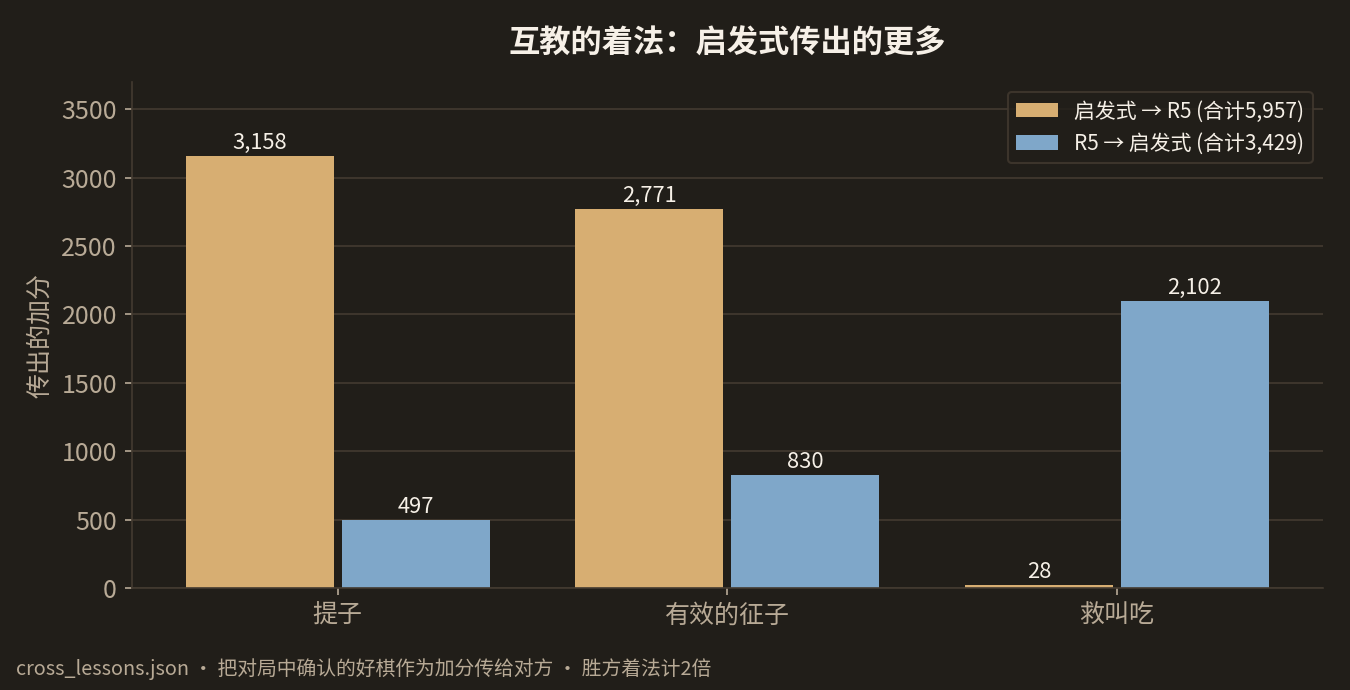
这相当于以启发式为老师来教R5。从某种意义上说,用规则编写的启发式正在下出比经过训练的人工智能更好的着法。
所有对局都是在手数限制处停止后只计算目数和提子的参考数子。没有判定死子的死活。
这一步的实际代码
这是把一方下出的好着法累积到对方表中的部分。黑棋(启发式)的着法传给R5,白棋(R5)的着法传给启发式,获胜一方的着法按两倍计算。
vlm_server/cross_lessons.py
def absorb_move(book: dict, actor: str, tags: Iterable[str], winner: Optional[str]) -> None:
    """actor 가 둔 좋은 수를 상대 테이블에 넣는다. actor 는 black|white."""
    tags = [t for t in tags if t in ("capture", "atari_save", "working_chase")]
    if not tags:
        return
    if actor == "white":
        target = "to_heuristic"
        weight = 2 if winner == "white" else 1
    else:
        target = "to_r5"
        weight = 2 if winner == "black" else 1
    _add_tags(book, target, tags, weight)
这是把在R5对局中确认的失误加入启发式分数的部分。虎口和无效的征子大幅扣分,真正能吃掉的征子则按学到的程度给予加分。
vlm_server/cross_lessons.py
def r5_live_delta(board, r: int, c: int, who: int) -> int:
    cells = _cells(board)
    score = 0
    hogu = hogu_verdict(cells, r, c, who)
    if hogu == "hogu_entry":
        score -= 9000
    elif hogu == "hogu_fill":
        score -= 2000
    if (r, c) in _futile_points(cells, who):
        score -= 14000

    if _puts_opponent_in_atari(cells, r, c, who):
        verdict = chase_verdict(cells, r, c, who)
        if verdict is not None:
            if verdict.kind == "working_chase":
                score += 2500 + verdict.group_size * 80
                score += int(_bonus(load_book(), "to_heuristic", ("working_chase",), 35.0, 1400.0))
            elif verdict.kind == "broken_chase":
                score -= 2000

    if _own_territory_fill(cells, r, c, who):
        score -= 3500
    if _nearby_double_atari(cells, r, c, who):
        score -= 6000
    return score
使用的模型:Qwen3-VL-8B-Instruct + LoRA适配器(lora_mix_qwen_r5)。完整源代码和模型说明可以在“8. 完整源代码与使用的模型”一文中查看。
COMMENTS · CHAPTER 07
修正围棋启发式 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始