最初失败的原因
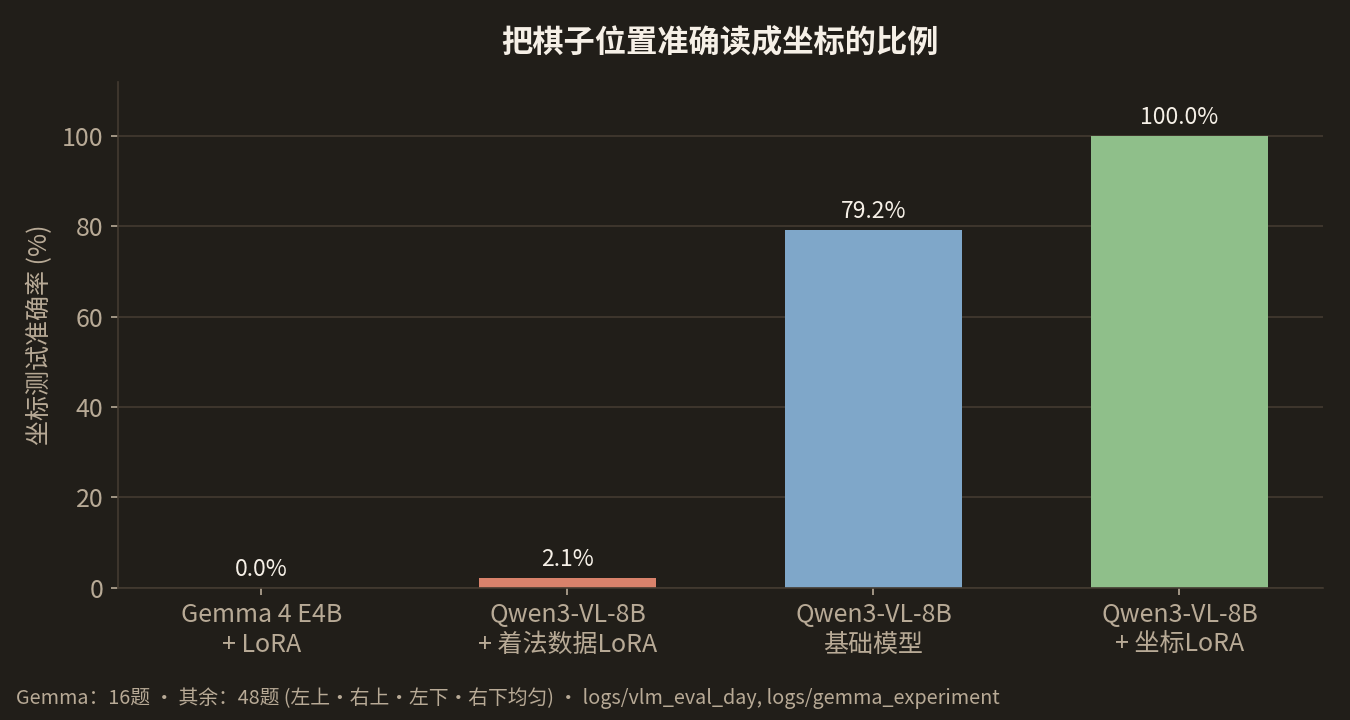
早期模型过于频繁地回答棋盘右下方的坐标。看起来像是棋谱不足,但真正的原因是输入格式。训练数据使用的是带数字编号、排列整齐的棋盘,而实际服务器发送的却是空格间距不同的棋盘。尤其是从列号变成两位数的地方开始,模型读取棋子位置时会错开一格。
在Gemma 4 E4B上加了LoRA的第一个模型,在16道坐标测试题中一道都没答对。换成Qwen3-VL-8B之后,只用400条着法数据短时间训练的适配器也跌到了2.1%。所以我们先做了一个坐标专用适配器,再在它上面训练着法。
第1步:固定坐标宽度
行和列不写成0、1、2,而是写成00、01、02这样的两位数。空点、黑子和白子也各自固定为一个字符,分隔用的空格数量也不改变。即使生成训练数据的函数和生成实际对局请求的函数是分开的,让它们共用同一个最终字符串生成器也更安全。
- 输出从00到18的列标题。
- 在每一行前面也加上从00到18的编号。
- 让空点、黑、白符号的宽度相同。
- 当前轮次和禁止坐标写在棋盘下方的固定位置。
第2步:先通过坐标测试
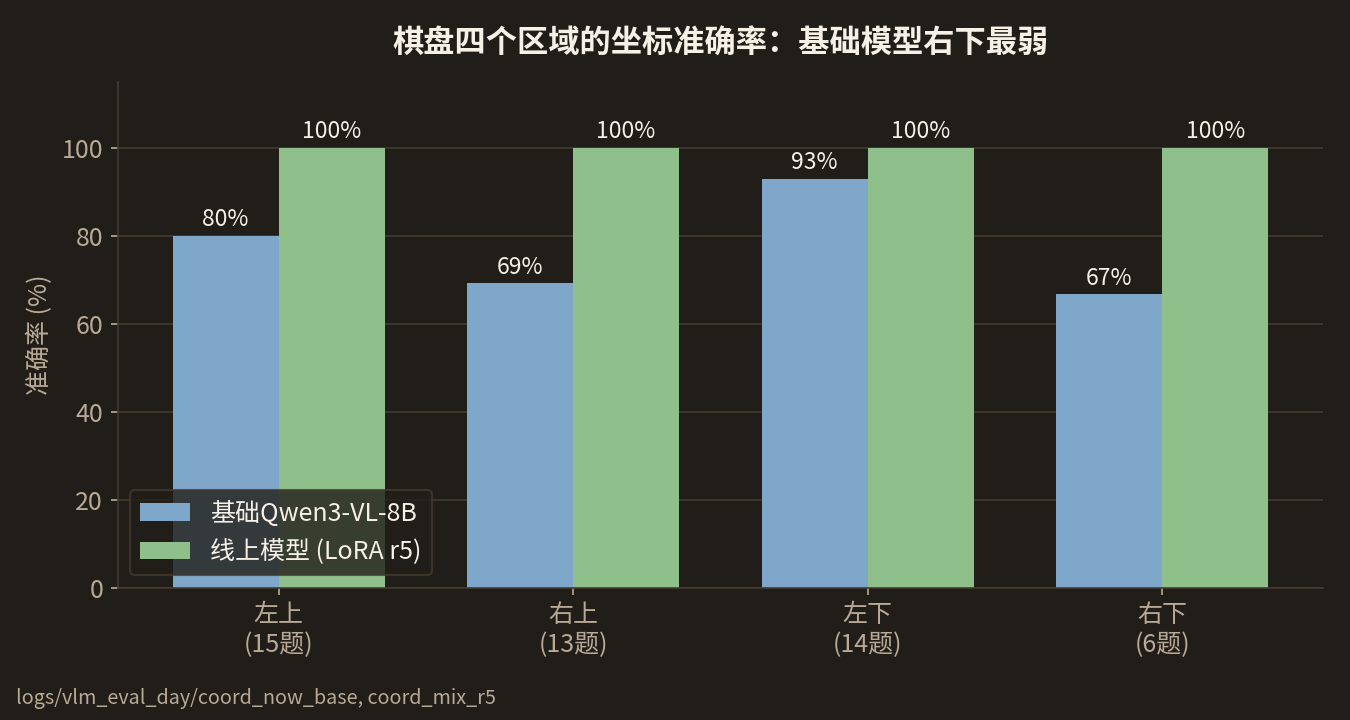
在训练棋力之前,先在任意一点放一颗棋子,让模型回答它的坐标。不要只测试中央,要在左上、右上、左下、右下四个区域出数量相同的题。即使整体准确率很高,如果只有右下方偏低,实际对局中就会出现方向偏差。
就连基础的Qwen3-VL-8B,右下方的准确率也只有66.7%,是四个区域中最低的。
每次重新训练模型或修改提示词时,都要重新运行坐标测试。除了正确率,还要保存答错时的方向。根据是反复向右偏一格,还是把行和列弄反,可以分别检查输入对齐和输出解析器。
第3步:收窄输出格式
模型如果回答长篇解释,坐标解析器就会变得不稳定。正常输出限制为一个坐标或PASS。即使附带了解释也悄悄只取第一个坐标的做法,可能会掩盖错误的着法,所以要记录为格式错误,并只重新请求规定的次数。
在确保坐标准确率之前,即使投入更多棋谱,也可能只会强化读错的习惯。
这一步的实际代码
这是一个把列标题、行号和棋子符号全部对齐为两个字符宽度的棋盘字符串生成器。训练数据生成和实际的着法推荐服务器共同使用这个函数,从而保证输入格式不会出现偏差。
vlm_server/dataset_baduk.py
def board_text_aligned(cells: bytes, size: int = BOARD_SIZE) -> str:
    """v3 권장: 열·행·셀이 모두 두 글자 토큰으로 정렬.

    셀 기호는 **왼쪽 정렬** (``X `` / ``. ``). 오른쪽 정렬(`` X``)은
    모델이 열을 한 칸 왼쪽(col-1)으로 읽는 오차를 유발했다.
    """
    col_header = "   " + " ".join(f"{c:02d}" for c in range(size))
    lines: List[str] = [col_header]
    for r in range(size):
        cells_s: List[str] = []
        for c in range(size):
            v = cells[r * size + c]
            ch = "." if v == 0 else ("X" if v == 1 else "O")
            cells_s.append(f"{ch:<2}")
        lines.append(f"{r:02d} " + " ".join(cells_s))
    return "\n".join(lines)
模型的正确输出被限制为只包含一个坐标或停一手的一行JSON。
vlm_server/dataset_baduk.py
def assistant_text(point: Optional[Tuple[int, int]]) -> str:
    if point is None:
        return '{"pass": true}'
    r, c = point
    return f'{{"row": {r}, "col": {c}}}'
使用的模型:Qwen3-VL-8B-Instruct + LoRA适配器(lora_mix_qwen_r5)。完整源代码和模型说明可以在“8. 完整源代码与使用的模型”一文中查看。
COMMENTS · CHAPTER 03
把19×19棋盘变成AI能读懂的输入 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始