本文的目的
公开俄罗斯方块 AI 使用的源代码。只有在展开文件时才会加载代码。
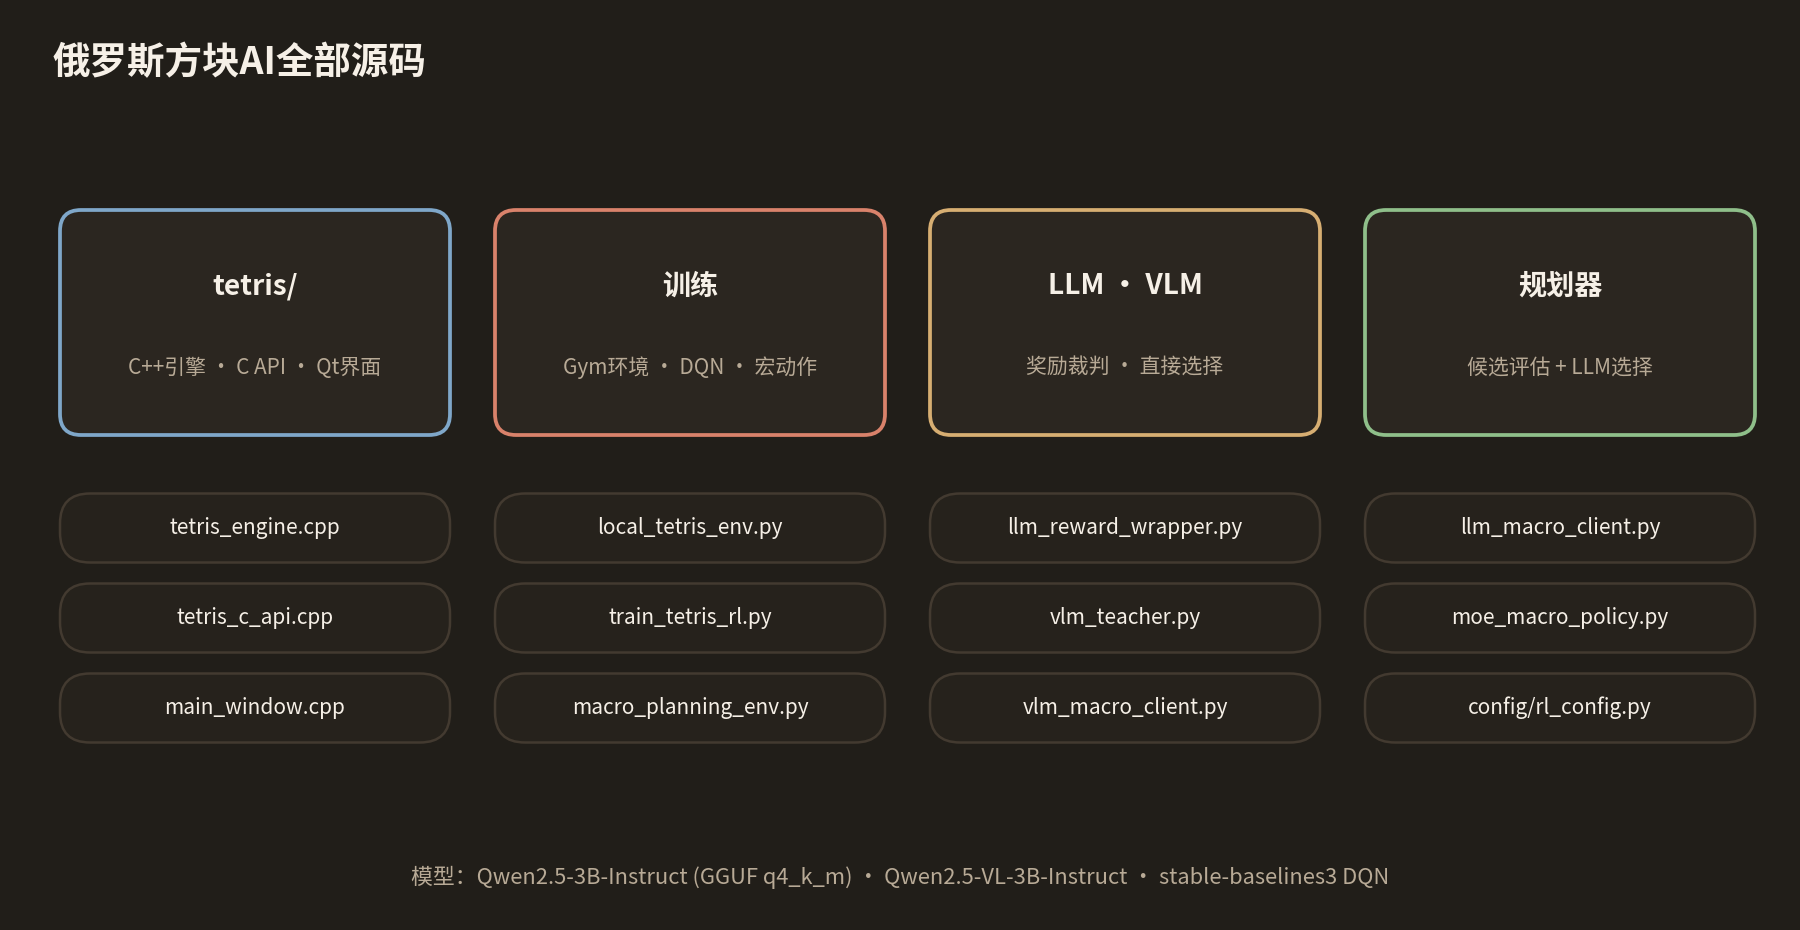
使用的模型
- stable-baselines3 DQN:低层 7 动作模型(30 万步、37 万步)和宏 40 动作模型(30 万步)。没有附上模型文件。
- Qwen2.5-3B-Instruct GGUF q4_k_m(llama-cpp-python):文字棋盘裁判、选择候选编号
- Qwen2.5-VL-3B-Instruct(transformers):图像棋盘裁判、直接选择位置
文件夹结构
- tetris:C++ 引擎(tetris_engine)、C API(tetris_c_api)、Qt6 画面与 TCP 服务器(main_window、tetris_widget)、CMake
- local_tetris_env.py:用 ctypes 封装引擎的 gymnasium 环境
- simple_tetris_env.py:没有构建引擎时使用的纯 Python 环境。观测和动作格式不同,模型不能互换使用。
- macro_planning_env.py:每个方块只选一次的 40 动作环境
- train_tetris_rl.py:无画面的 DQN 训练
- train_qt_live.py:一边训练一边在 Qt 画面上显示当前模型。也有用人下的棋局来训练的模式。
- qt_rl_client.py:把训练好的模型连接到 Qt 画面上
- llm_teacher.py、vlm_teacher.py、llm_reward_wrapper.py:LLM 与 VLM 奖励裁判
- vlm_macro_client.py:由 VLM 直接选择位置的客户端
- llm_macro_client.py:候选计算与 LLM 选择编号
- moe_macro_policy.py:混合四条规则的候选选择
- config/rl_config.py:训练设置
构建产物、虚拟环境、模型权重和训练好的模型文件均已排除。
完整源代码
25 个文件 · 4,969 行 — 展开文件夹后点击文件即可加载代码。
项目根目录
llm_macro_client.py
正在加载代码…
llm_reward_wrapper.py
正在加载代码…
llm_teacher.py
正在加载代码…
local_tetris_env.py
正在加载代码…
macro_planning_env.py
正在加载代码…
moe_macro_policy.py
正在加载代码…
project.md
正在加载代码…
qt_rl_client.py
正在加载代码…
requirements.txt
正在加载代码…
simple_tetris_env.py
正在加载代码…
train_qt_live.py
正在加载代码…
train_tetris_rl.py
正在加载代码…
vlm_macro_client.py
正在加载代码…
vlm_teacher.py
正在加载代码…
config/
config/__init__.py
正在加载代码…
config/rl_config.py
正在加载代码…
tetris/
tetris/CMakeLists.txt
正在加载代码…
tetris/src/main_window.cpp
正在加载代码…
tetris/src/main_window.h
正在加载代码…
tetris/src/main.cpp
正在加载代码…
tetris/src/tetris_c_api.cpp
正在加载代码…
tetris/src/tetris_engine.cpp
正在加载代码…
tetris/src/tetris_engine.h
正在加载代码…
tetris/src/tetris_widget.cpp
正在加载代码…
tetris/src/tetris_widget.h
正在加载代码…
COMMENTS · CHAPTER 06
完整源代码与使用的模型 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始