自己下着学
我们放弃了背顺序,让模型自己下盘面。模型给出一手后,服务器会与正确答案核对,如果错了,就由神谕(oracle,知道正确答案的代码)代替它下出正确的一手。用这样积累下来的记录,每3局接着训练一次LoRA。
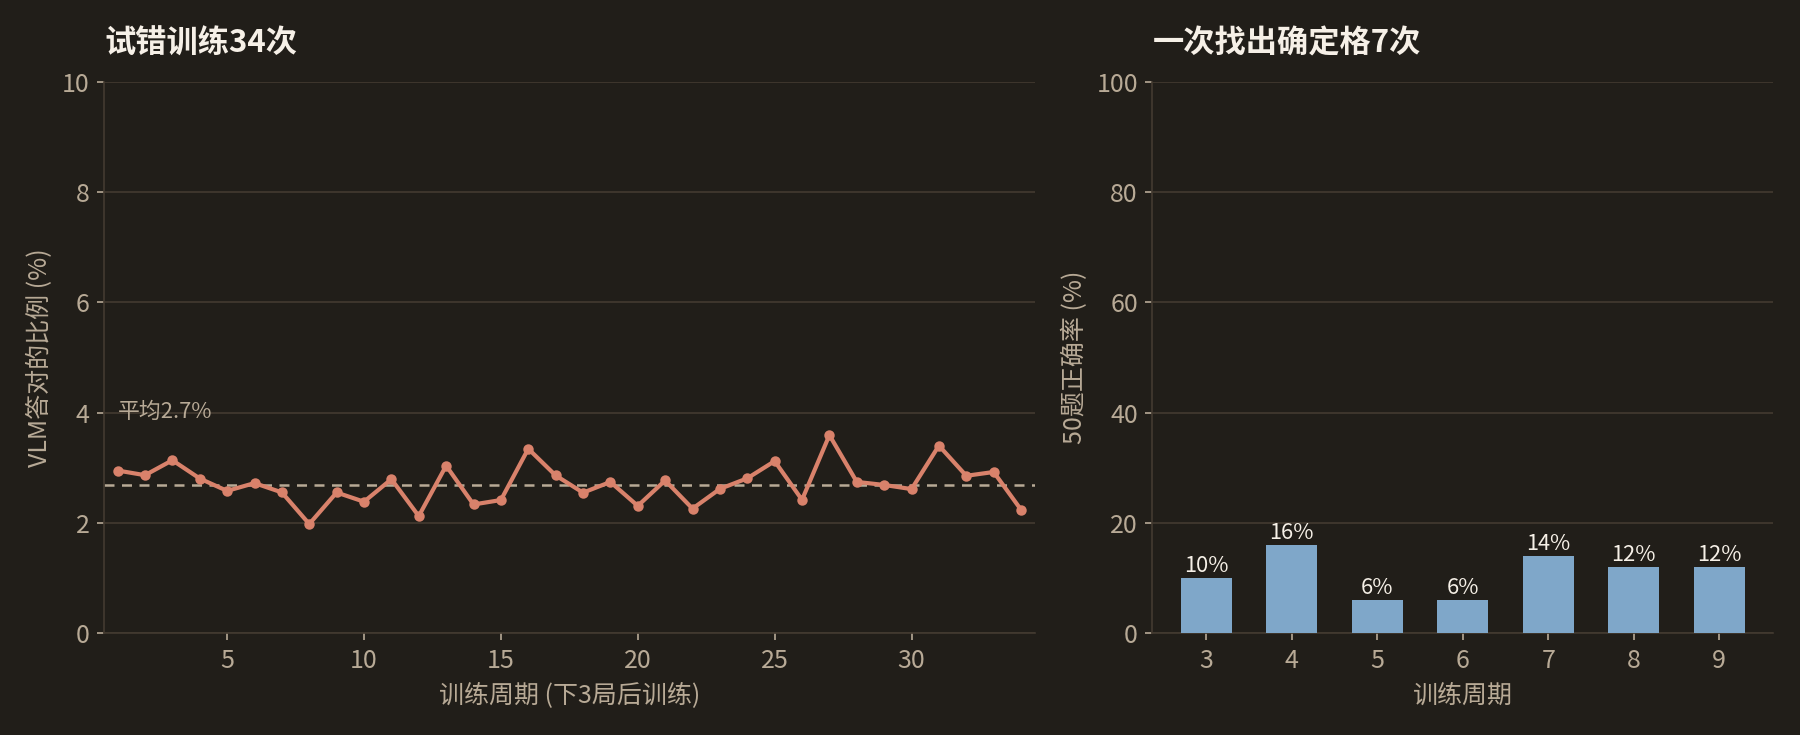
三天里跑了34个周期。模型给出的着法中正确的比例,每个周期在2.0~3.6%之间,整体是62,842次中的1,695次(2.7%)。无论怎么反复训练都没有提高。
一次找出确定的格子
接下来,我们让模型直接从整个盘面中选出一个100%确定的格子(lora_cell)。把答错的题收集起来重新放进去,跑了7个周期,但50道测试题的正确率只有6~16%。让它在实际盘面上下15手,结果是0~33%。
我们还尝试了把数字和格子分开、从简单的部分开始教的课程学习。猜数字从34%降到了26%,猜格子则一直停在0%不动。
神谕教了什么
大约在这个时候,我把人解数独的方法另外写进了solve.md。在那份文档里,我这样写下了失败的原因。
概率不到20%的值神谕是知道的,并且把这个值训练给vlm,所以训练出来的结果之间没有差别,因此vlm看起来完全没有“为什么这个正确答案会是这样”的规律性。
神谕总是知道正确答案。它不关心那个格子在当前盘面上能否通过推理确定。混入了在盘面上找不到依据的正确答案,模型也就没有可以学习的规则。这和第1篇中的答案表是同一个问题。
这一步的实际代码
这是下3局再训练的循环中的一个周期。下完盘面,从积累的记录中提取训练数据,然后接着训练LoRA。
vlm_play_train_loop.py
results, play_accuracy = run_games(
    session,
    games=args.games_per_cycle,
    difficulty=args.difficulty,
    max_steps=args.max_steps,
    verbose=args.verbose,
    save_images=None,
    game_id_start=state.game_id_next,
    accuracy=play_accuracy,
    human=args.human,
)
state.game_id_next += args.games_per_cycle
print_summary(results, play_accuracy)
print(f"\n사이클 {cycle} 시도정답률(리젝 포함): {play_accuracy.fmt()}")

# ...

total_lines = count_replay_lines(replay_path)
cycle_jsonl = cycle_sft_dir / f"cycle_{cycle:04d}.jsonl"
kept, new_total, by_outcome = export_trainable(
    replay_path,
    cycle_jsonl,
    since_line=state.replay_line_offset,
)

# ...

t0 = time.monotonic()
exit_code = run_training(
    dataset_jsonl=cycle_jsonl,
    base_model=args.base_model,
    adapter_dir=adapter_in,
    output_dir=args.output_dir,
    device=args.device,
    epochs=args.train_epochs,
    batch_size=args.batch_size,
    grad_accum=args.grad_accum,
)
下一篇是“3. 把人的解法变成规则”。
COMMENTS · CHAPTER 02
靠试错学不会 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始