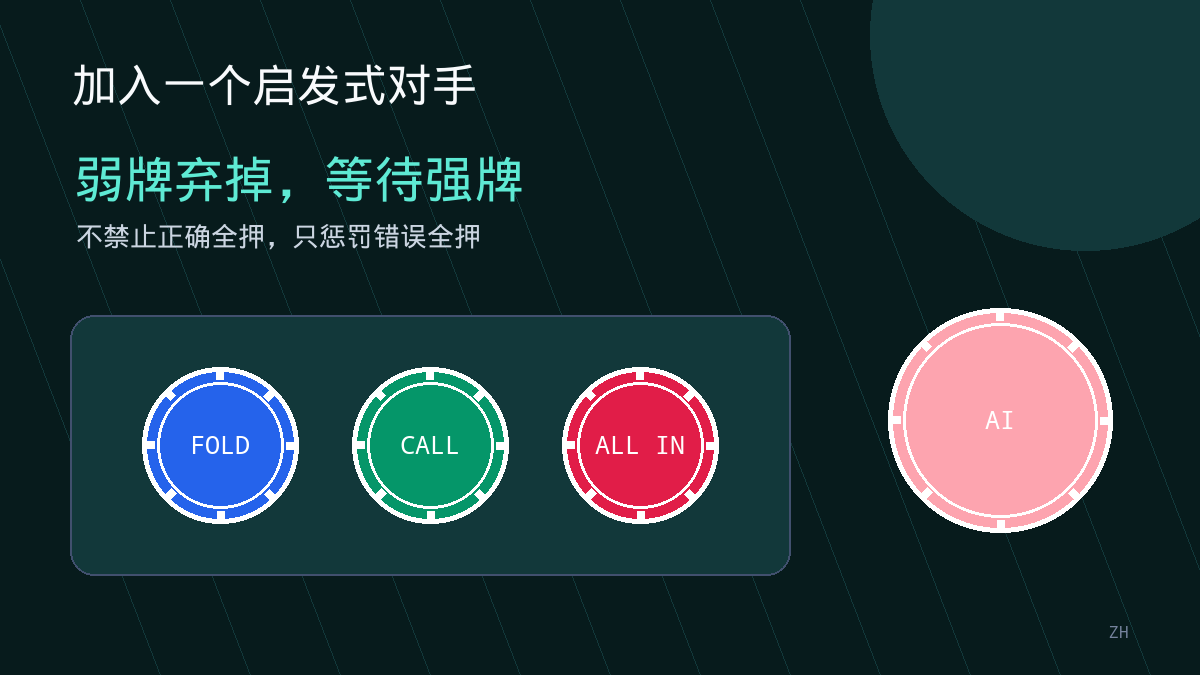
下一步不是删除全押按钮,而是让训练与评估区分合理和不合理的全押。先固定一个 tight/exploitative 启发式对手:面对早期全押时弃掉弱牌;牌力和底池赔率支持时跟注;前期采用小额下注;在后期强牌或合理 SPR 下仍进行正当全押。
现有代码已有一道保护条件:
src/model.cpp
const bool earlyShove = learned == ActType::AllIn &&
    (observation.street < 4 || strength < prior_.allInAbove);
它能检测风险动作并改走其他选择,是降低显性故障的 containment(围堵)措施,却不会修复模型内部价值估计或信用分配。只观察保护开启后的结果,不能证明学习策略已改善。
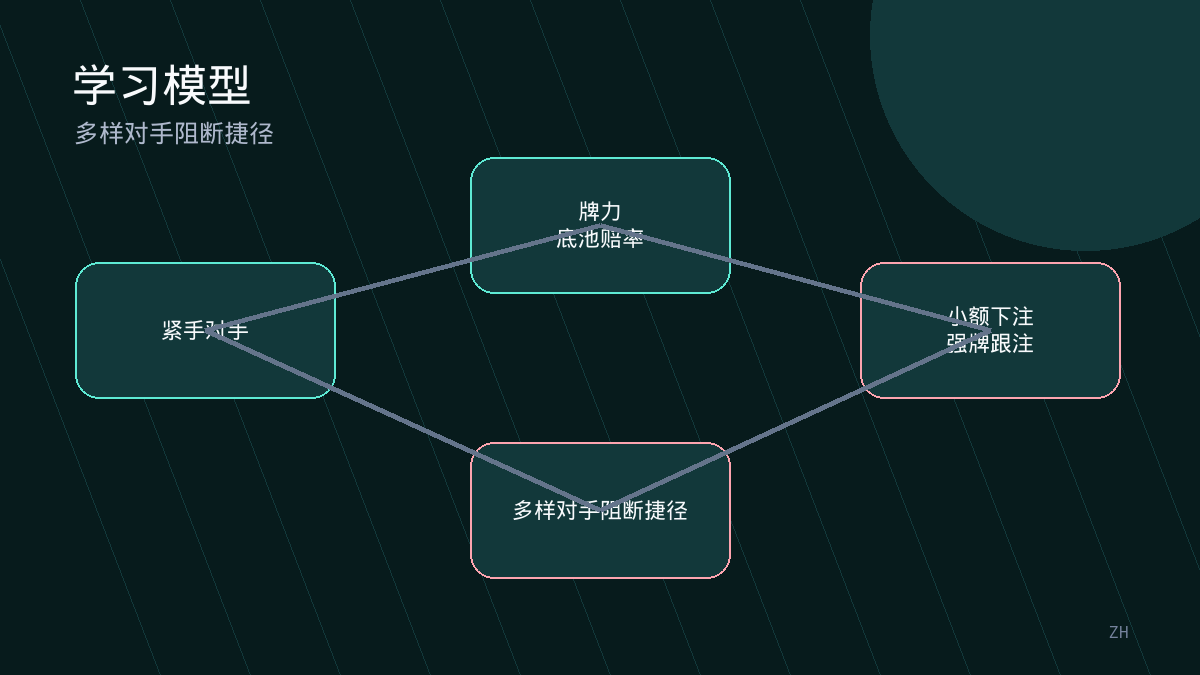
训练对手也不应只有一个。把 tight、balanced、loose 启发式和历史模型快照组成种群,随机安排座位和对局;固定剥削型对手保留作回归测试。这样能区分“记住一个对手”和“适应多种风格”的策略。
奖励应围绕筹码增长或对数收益,而不是截断后的单一胜负。破产设置独立惩罚;没有充分依据便在前期暴露全部筹码时,施加渐进风险惩罚,但不要惩罚强牌的正当后期全押。使用动作或街次级 advantage 与中间价值估计,比把终局奖励复制到所有步骤更能准确分配信用。
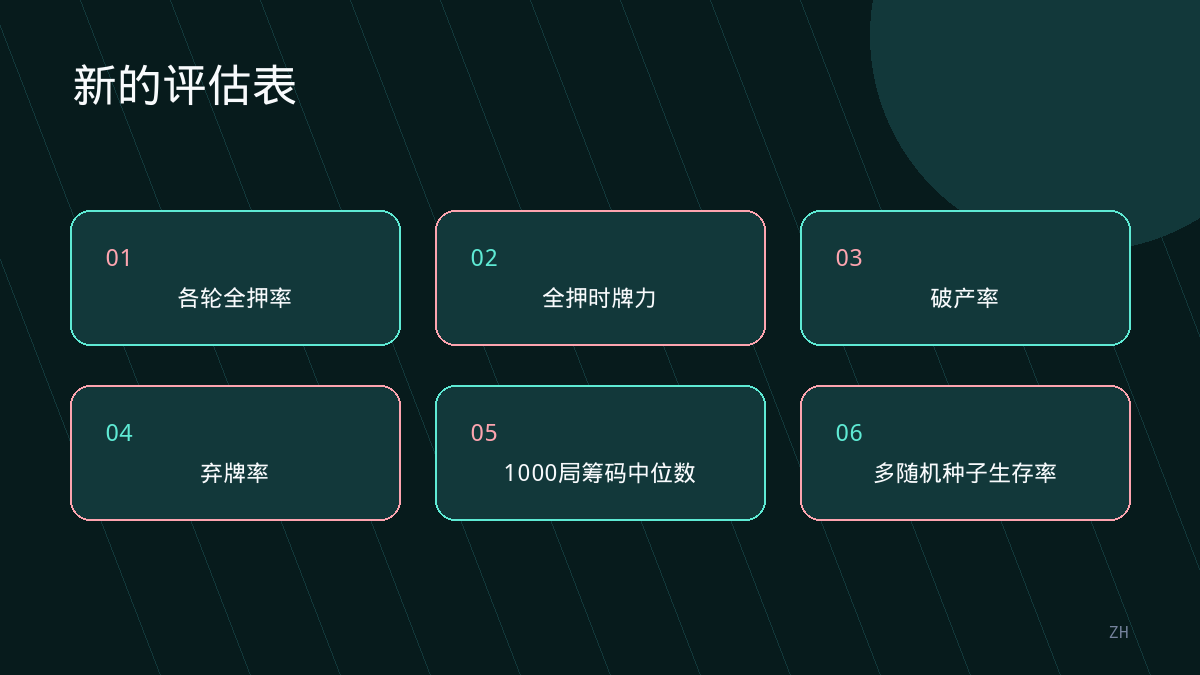
在多个随机种子上至少评估1,000手。记录各街全押率、全押时平均牌力、破产率和弃牌率,以及1,000手期间的筹码中位数。均值可能掩盖少见破产,因此还要保留分布和不确定区间。
成功不等于全押率归零。弱牌早期全押应下降,合理后期全押应保留;对手组合变化时,筹码中位数和生存性仍应改善。只有移除围堵后效果仍存在,才能说学习策略本身真正进步。
COMMENTS · CHAPTER 03
不要只拦截全押,而要检验全押 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始