现在VLM在学什么
自动训练只收集获胜一方的着法,让VLM去模仿。可是在训练对局中白棋(VLM)赢了94%,而记录里白棋的着法也被留存为本地AI下的。所以12,080条数据中有10,513条是白棋的位置,也就是VLM自己下的着法。正如在第1篇中看到的,就连这样的训练也因为损失变成NaN而失败了。
发给VLM的提问中也没有五子棋规则。只是给它看棋盘,让它只回答空格的两个坐标。三、四、禁手这样的词一次也没有出现过。
从围棋和滑块拼图中学到的东西
在围棋中,我们修正启发式并让它与R5对弈,结果反倒是启发式教起了R5。在滑块拼图中,把人解题的规则加入启发式后,它一天之内就解开了全部4,000局。两次都是没有贪欲的规则,比追逐未来奖励的学习先打开了道路。
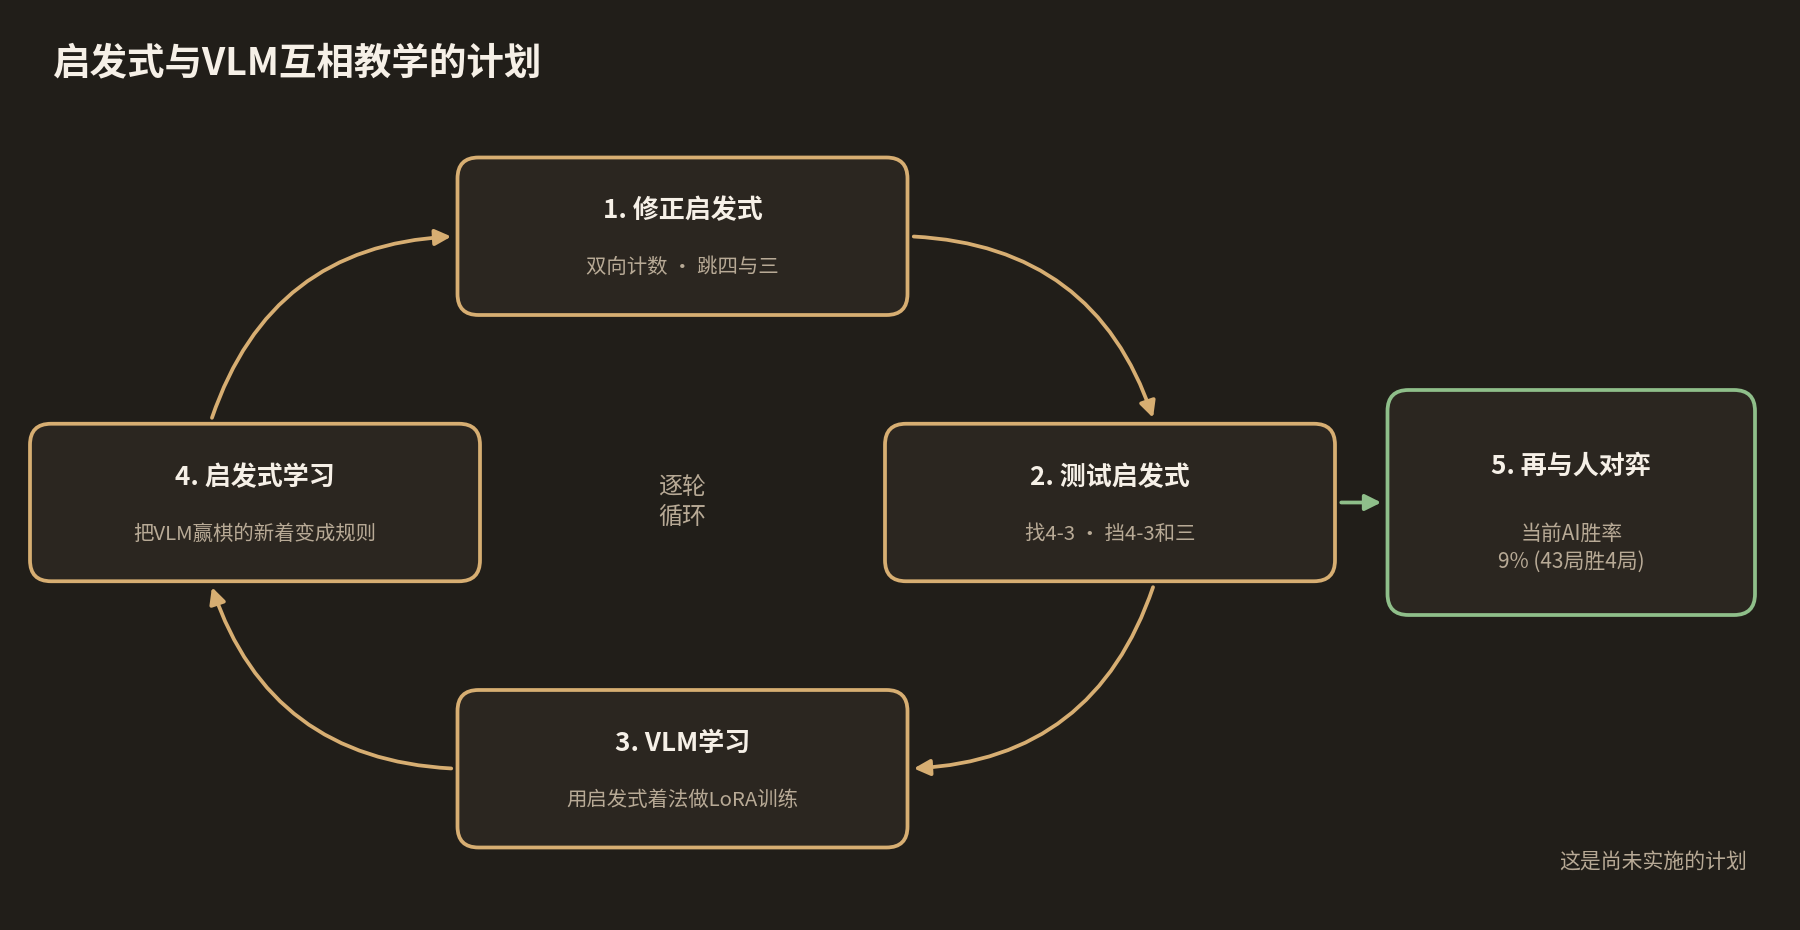
我们打算在五子棋上也尝试同样的方法。这是一个还没有实施过的计划。
计划
- 修正启发式:对一条线从两个方向计数,把跳四(○_○○○)和跳三也当作同样的棋形来计数。先找好自己的四三点,并提前挡住对方下一手能形成四三或活四的位置。
- 测试启发式:每次都重新运行第3篇中的测试(找到自己的四三、挡住对方的四三点、挡三),并通过同一个AI轮流执黑执白的对局,重新检查规则对哪一方有利。
- 让VLM学习启发式:以修正后启发式的着法为正确答案,重新进行LoRA训练。在提问中加入禁手和威胁棋形,并先修复坏掉的训练设置(MPS fp16)。
- 让启发式重新成为老师:收集VLM下得与启发式不同却获胜的着法,再把那些棋形转化为启发式的规则。这就是在围棋中R5和启发式互相学习的方式。
- 再与人对弈:根据AI对人的胜率比现在的9%(43局中4局)提高了多少来判断。
这一步的实际代码
这是现在发给VLM的提问。它只要求空格坐标,不包含五子棋规则。
vlm_pva_server.py
base_prompt = (
    f"{turn_line}\n"
    f"{board_txt}\n"
    f"Choose your next {you_label} move on an EMPTY cell (a '.' in the TEXT board)."
    f"{opening_rule} "
    "Trust the TEXT board coordinates over the image. "
    "Reply with EXACTLY two integers separated by a single space: \"row col\". "
    f"row and col are both in 0..{last_idx}. No other text."
)
下一篇是“5. 完整源代码与使用的模型”。
COMMENTS · CHAPTER 04
让VLM学习启发式、再让启发式重新成为老师的计划 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始