还没有开始
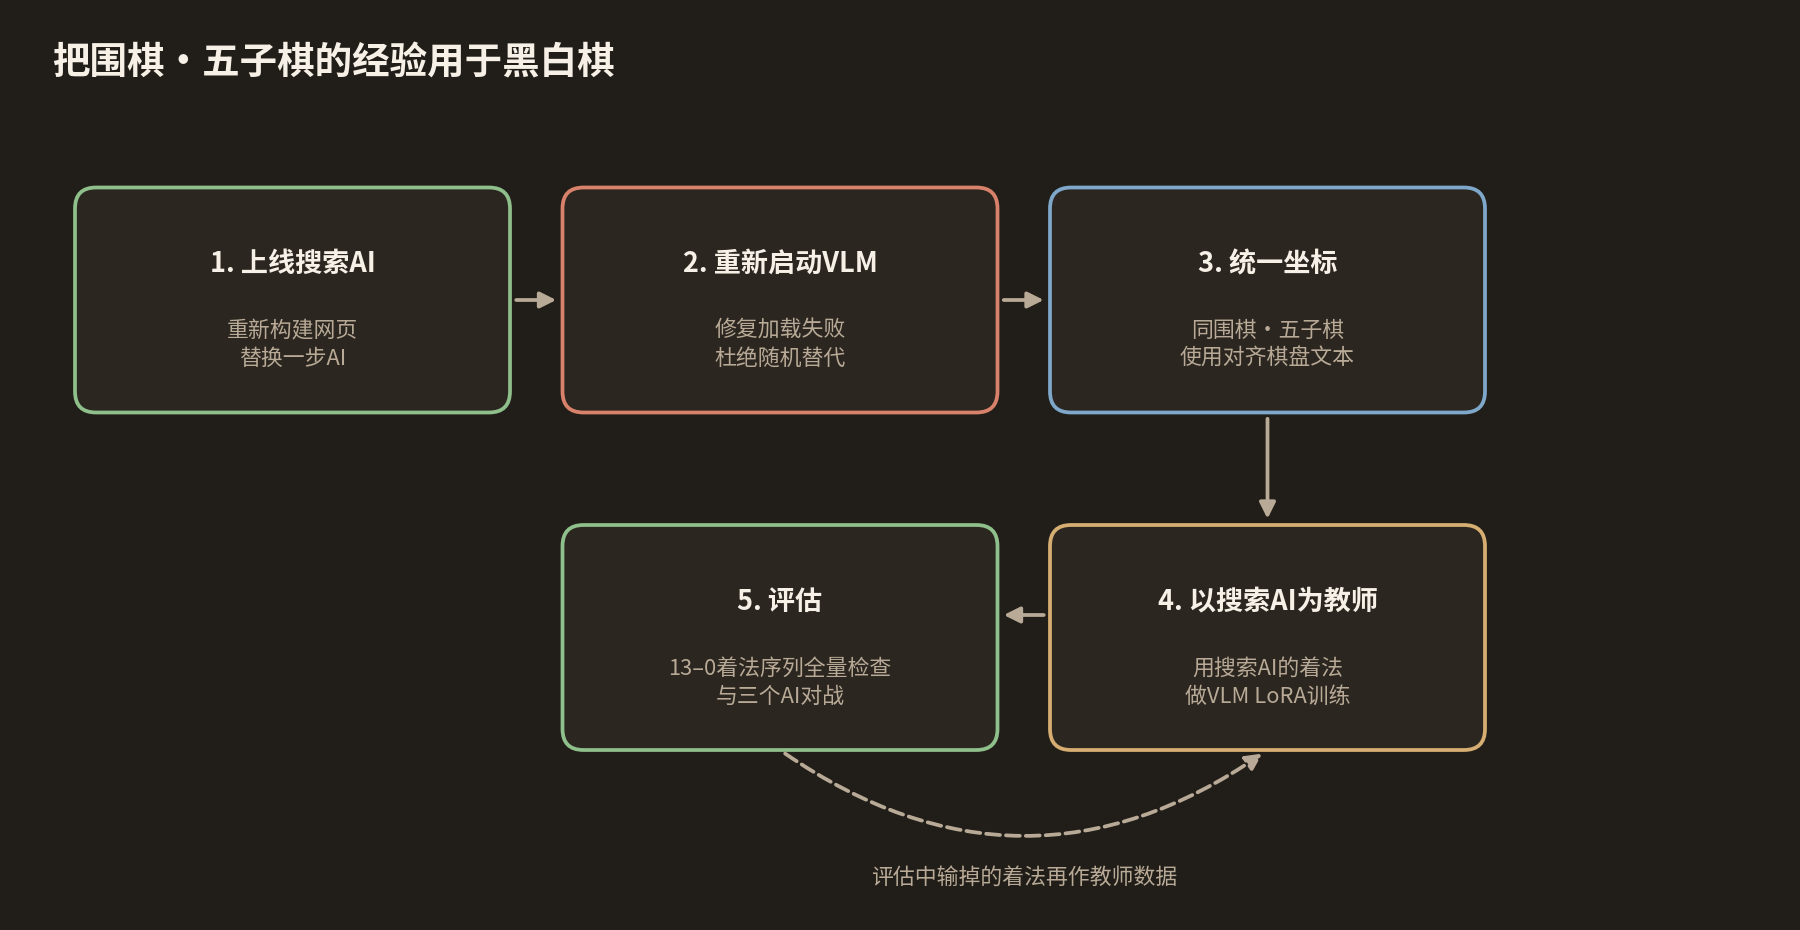
黑白棋既没有训练代码,也没有训练数据。以下是计划。
1. 上线搜索 AI
重新构建网页,第 2 篇的搜索 AI 就会上线。第 1 篇的 13–0 着法顺序将不再奏效。
2. 重新启动 VLM
要么修好加载问题,要么换成围棋服务器使用的 Qwen3-VL-8B。加载不了模型时让服务器不启动,换成随机的着法要留在记录中,也要显示在画面上。
3. 对齐坐标
在围棋中,知道每个模型对坐标的写法都不一样之后,我们花了很长时间做坐标对齐训练。五子棋也在应用同样的训练。在训练前的测试中,仅仅把盘面文本的列对齐,选择已有棋子位置的比例就从 40% 降到了 21%。
黑白棋是 8×8,提示词中又有合法着法列表,所以坐标方面的负担较小。即便如此,也还是先从同样的测试开始。
4. 以搜索 AI 为教师
在围棋中,我们修好启发式之后,以该启发式为教师训练了模型。在黑白棋中,搜索 AI 就是教师。以搜索 AI 选出的着法为正确答案来训练 VLM LoRA。
由于每一步的正确答案都由搜索决定,不会像五子棋的自动训练那样,因为只收集赢的一方的着法而导致数据偏向一边。
5. 评估
- 像第 1 篇那样,把黑方的着法全部展开到第 11 步,统计是否存在全灭的着法顺序。
- 与随机、只看一步的 AI、搜索 AI 各下 100 局。
- 在与人对局的棋局中记录对手类型。目前的对局记录中没有这一栏。
评估中输掉的棋局的着法再作为教师数据放回去。
这一阶段的实际代码
这是目前给 VLM 的提示词。一并给出合法着法列表,并让它用一行 JSON 回答。
vlm_server/server.py
SYSTEM_PROMPT = (
    "당신은 8×8 오델로(Reversi)의 강한 플레이어입니다. "
    "보드 이미지와 텍스트 격자를 보고 다음 단 한 수를 고르세요. "
    "텍스트 격자가 이미지와 다르면 텍스트를 우선하세요. "
    "좌표는 0-indexed 정수 (row, col) 이며 각각 0..7 입니다. "
    "(0,0)은 좌상단 A1, 열 A–H = col 0–7, 행 1–8 = row 0–7. "
    "X=흑, O=백, .=빈칸. 반드시 합법수만 고르세요. "
    "합법수는 상대 돌을 하나 이상 끼워 뒤집는 빈 칸입니다. "
    "응답은 설명 없이 JSON 한 줄만 출력하세요."
)

# ...

def build_prompt(
    board: bytes,
    ai_side: int,
    legal: list[tuple[int, int]],
    forbidden: Optional[list[tuple[int, int]]] = None,
) -> str:
    side = "흑(X)" if ai_side == 1 else "백(O)"
    n_b, n_w = rules.counts(board)
    forbid_note = ""
    if forbidden:
        banned = ", ".join(f"({r},{c})" for r, c in forbidden[:16])
        forbid_note = f"\n금지 좌표(고르지 마세요): {banned}\n"
    return (
        f"당신의 차례: {side}. 흑 {n_b} · 백 {n_w}.\n"
        "보드 (X=흑, O=백, .=빈, 행=row 0=위, 열=col 0=왼쪽):\n"
        f"{rules.board_text(board)}\n\n"
        f"합법수: {rules.format_moves(legal)}\n"
        f"{forbid_note}"
        '다음 수를 JSON 한 줄로만 답하세요. 예: {"row": 2, "col": 3} '
        '합법수가 없으면 {"pass": true} 만 출력.'
    )
下一篇是“5. 完整源代码与使用的模型”。
COMMENTS · CHAPTER 04
把从围棋、五子棋中学到的东西移植到黑白棋的计划 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始