训练设置
- 算法:stable-baselines3 DQN。学习率 1e-4,回放缓冲区 10 万,批大小 32,每 4 步训练一次,目标网络每 1 万步更新一次。
- 探索:在最初 20% 的时间里,把随机比例从 1 降到 0.02。
- 策略网络:由于观测值是 0~7,SB3 不把它当作图像,而是选择 MlpPolicy。棋盘的 220 格被展平成一行输入。
奖励
每次方块固定时计算。
- 消行:1 行 1 分,2 行 3 分,3 行 10 分,4 行 30 分
- 放得越低,加得越多一点(落地高度×0.1)
- 每新产生一个空洞 -5
- 堆叠高度每上升一格 -2
- 减去凹凸度(相邻列高度差之和)×0.02 和堆叠高度×0.03
结果
留下来的低层模型有两个:30 万步的模型(live_latest.zip.bak),以及在它基础上继续训练的 37 万步模型(live_latest.zip)。继续训练原本以 62 万步为目标,却在 37 万步时停了下来。
我们在同一个引擎上用种子 0~19 各跑了 20 局。模型每次都选择价值最高的动作。
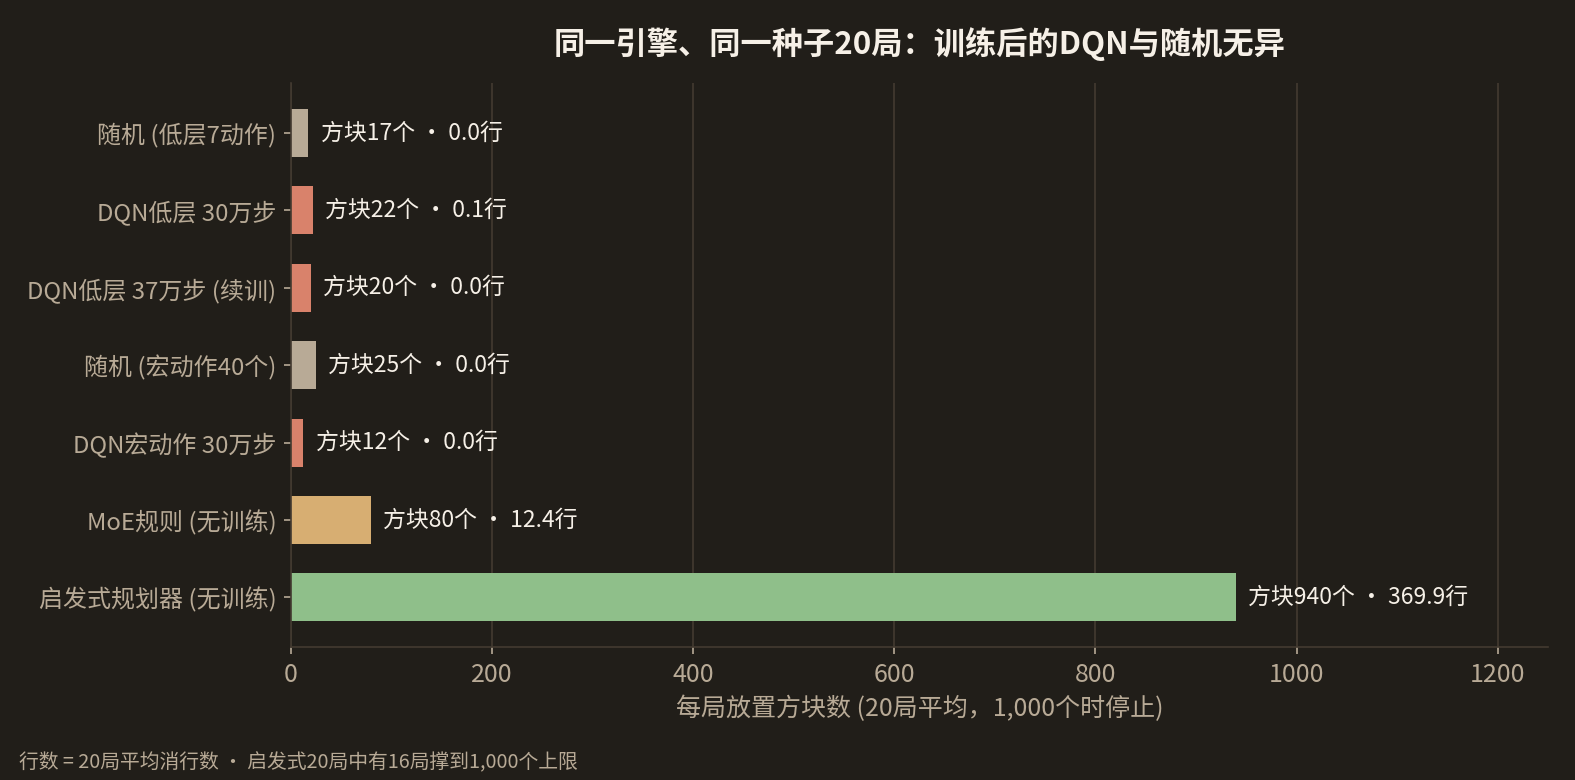
- 随机 7 个动作:平均 17 个方块,0 行
- DQN 30 万步:平均 22 个方块,20 局共 2 行
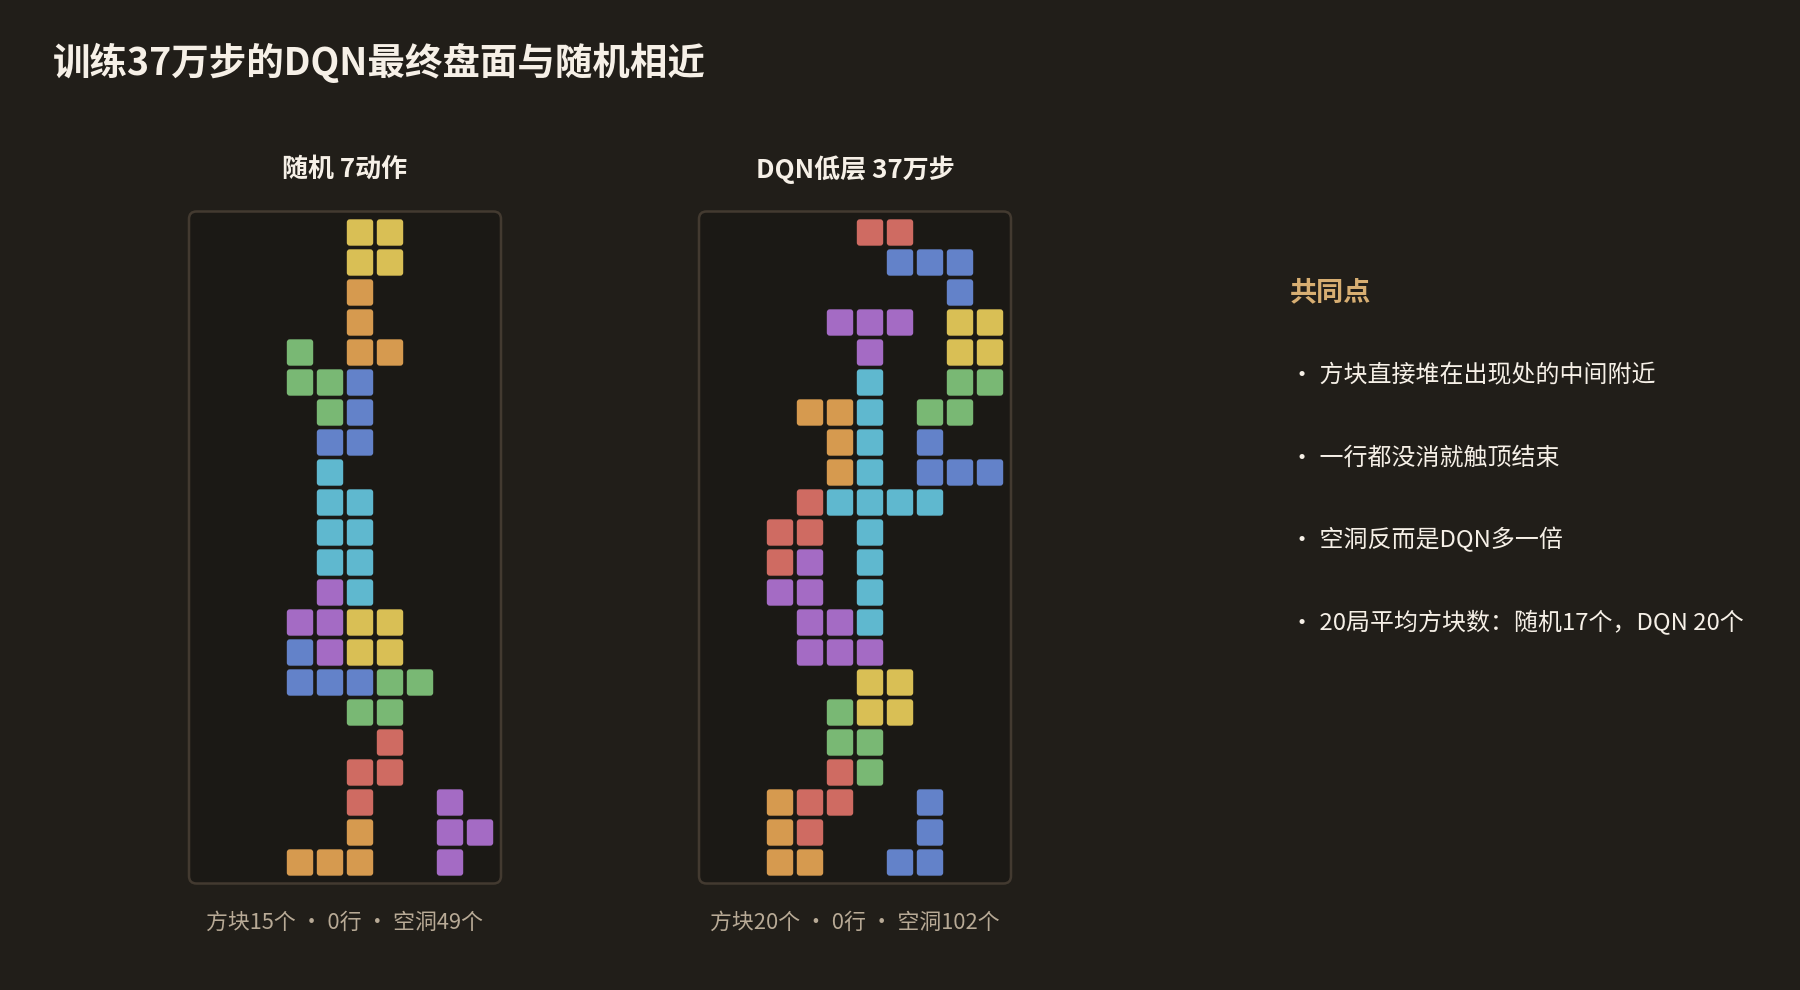
- DQN 37 万步:平均 20 个方块,0 行
为什么没学会
- 几乎见不到消行奖励。随机乱按的话,20 局下来一行都消不掉。要消一行,得把好几个方块拼好,而这在探索过程中很少发生。进入训练的信号几乎只有空洞和高度的惩罚。
- 一个方块要用 20 多个动作。位置好不好要到方块固定的瞬间才知道,很难分清之前的移动和旋转中哪一个做得好。
- 由一个小型 MLP 来看展平后的 220 个数字。它很难读懂方块形状和位置关系,也不知道下一个方块是什么。
所以我们把动作减少到每个方块一次,并让 VLM 来辅助奖励。
这一阶段的实际代码
这是方块固定时引擎计算的奖励。
tetris/src/tetris_engine.cpp
// Line clear reward (non-linear scaling)
double line_r = 0.0;
switch (cleared) {
    case 1: line_r = cfg_.line_reward_1; break;
    case 2: line_r = cfg_.line_reward_2; break;
    case 3: line_r = cfg_.line_reward_3; break;
    case 4: line_r = cfg_.line_reward_4; break;
    default: break;
}

// Height reward: lower placement = higher reward
double height_r = cfg_.height_reward_scale * landing_y;

const int holes_after = count_holes();
const int new_holes = holes_after - holes_before;
double hole_penalty = 0.0;
if (new_holes > 0) {
    hole_penalty = cfg_.hole_penalty_scale * static_cast<double>(new_holes);
}

// Stack height penalty: penalize increases of the board height (after line clears)
double height_penalty = 0.0;
if (cfg_.stack_height_penalty_scale > 0.0) {
    const int height_after = stack_height();
    const int dh = height_after - height_before;
    if (dh > 0) {
        height_penalty = cfg_.stack_height_penalty_scale * static_cast<double>(dh);
    }
}

// Surface shaping penalties (post line-clear)
double bump_penalty = 0.0;
if (cfg_.bumpiness_penalty_scale > 0.0) {
    bump_penalty = cfg_.bumpiness_penalty_scale * static_cast<double>(bumpiness());
}
double max_height_penalty = 0.0;
if (cfg_.max_height_penalty_scale > 0.0) {
    max_height_penalty = cfg_.max_height_penalty_scale * static_cast<double>(stack_height());
}

last_reward_ += line_r + height_r - hole_penalty - height_penalty - bump_penalty - max_height_penalty;
这是奖励大小和 DQN 设置。
config/rl_config.py
    # ── 보상/패널티 스케일 (C++ 엔진으로 전달) ───────────────────────────────
    # 한쪽으로 몰빵되는 탑쌓기를 억제하려면 아래 2개를 켜는 게 효과적
    stack_height_penalty_scale: float = 2.0   # 스택 높이 "증가분" 패널티 (권장 0.5~5.0)
    # bumpiness는 값 범위가 커서(최대 수백) 스케일을 너무 크게 주면 보상이 붕괴합니다.
    bumpiness_penalty_scale: float = 0.02     # 인접 열 높이 차이 합 패널티 (권장 0.005~0.05)
    max_height_penalty_scale: float = 0.03    # 절대 스택 높이 패널티 (권장 0.0~0.1)


@dataclass(frozen=True)
class DQNConfig:
    timesteps: int = 300_000
    learning_rate: float = 1e-4
    buffer_size: int = 100_000
    batch_size: int = 32
    train_freq: int = 4
    target_update_interval: int = 10_000
    exploration_fraction: float = 0.2
    exploration_final_eps: float = 0.02
下一篇是“3. 每个方块只选一次的宏动作与 VLM 奖励”。
COMMENTS · CHAPTER 02
DQN 训练 37 万步,消除行数为 0 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始