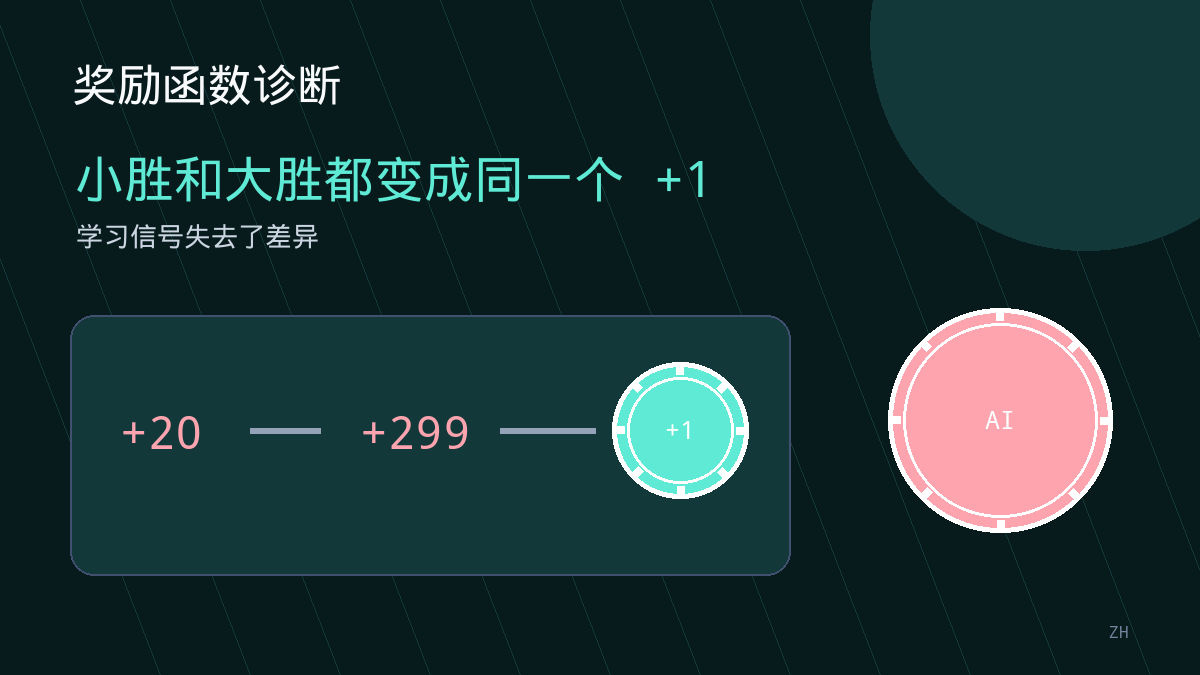
第一条代码线索位于 `finishHand`:筹码变化除以20,再截断到-1至+1。
src/model.cpp
const float reward = std::clamp(
    static_cast<float>(chipDelta) / 20.f,
    -1.f,
    1.f
);
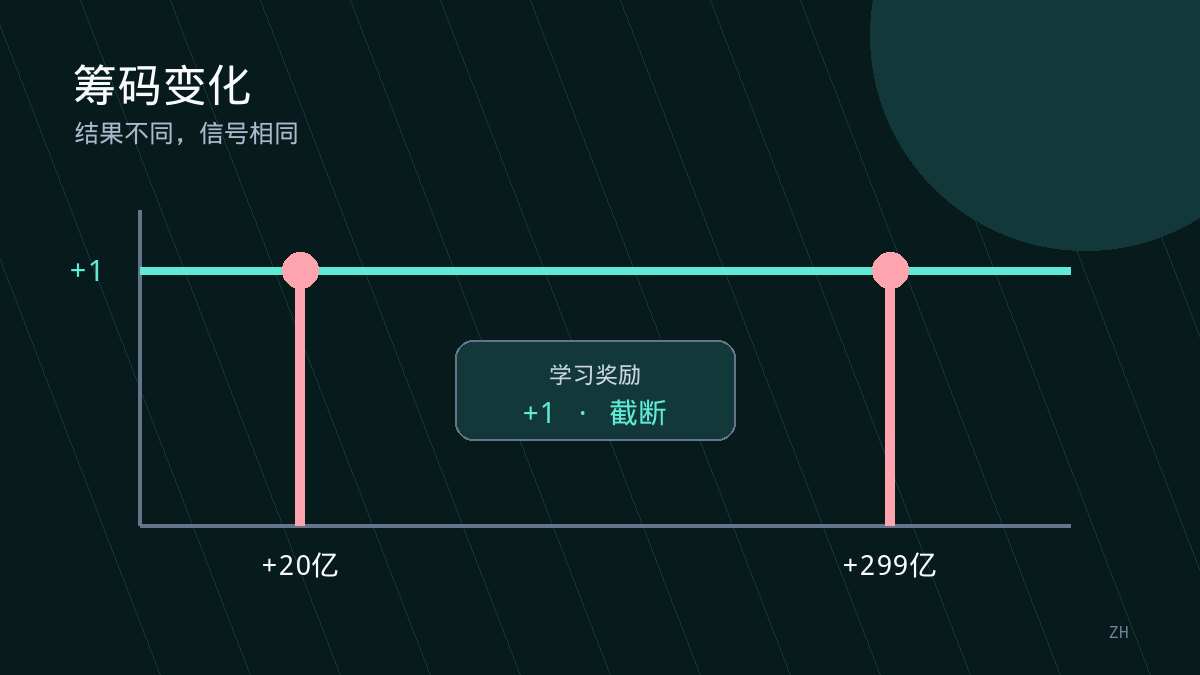
因此,盈利+20得到+1,盈利+299也同样得到+1;低于-20的损失也被压平。适度胜利与巨大胜利之间的顺序信息消失,学习器更容易优化“尽快抵达正终点”,而不是有效率地增长筹码。
第二条线索是信用分配:同一个终局值被赋给该回合记录的每个动作。
src/model.cpp
constexpr float kRate = 0.05f;
for (const Step& step : episode_) {
  for (int i = 0; i < kFeatures; ++i) {
    float& weight = weights_[static_cast<size_t>(step.action * kFeatures + i)];
    weight = std::clamp(weight + kRate * reward * step.features[i], -2.f, 2.f);
  }
}
episode_.clear();
save();
它不区分弃牌、过牌、跟注或加注各自对结果的贡献。全押令牌局快速结束时,轨迹很短,同一个+1可能反复强化少数决策。这不能单独证明原因,却确实让易重复的短路径获得结构性优势。
模型快照与此一致。cheolsu 的全押总值为+0.818,过牌为-1.854,跟注为-5.013,全押的筹码特征为+0.226。younghee 的全押接近零,但过牌和跟注约为-3.657、-3.722,因此全押仍相对有吸引力。minsu 则更偏向 `bbing`,而非全押。
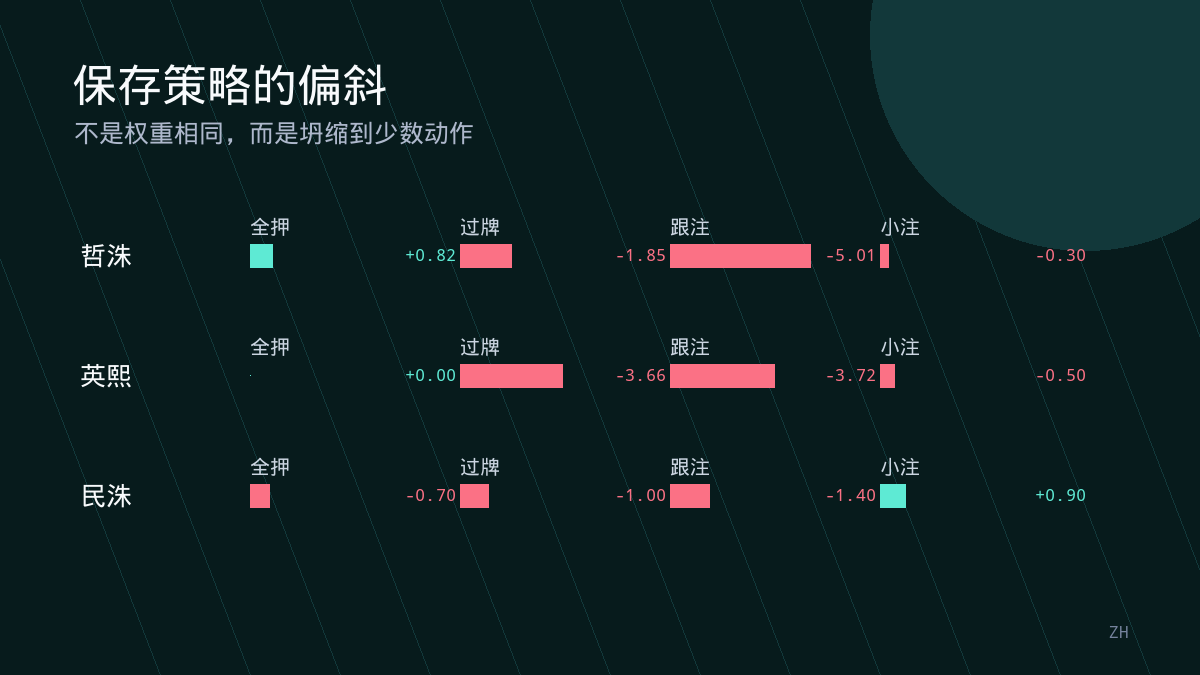
所以,把三者称作“相同的全押 AI”并不准确。共同问题是向少数动作发生 policy collapse,但具体动作和权重轮廓并不相同。单个系数也不是完整策略;状态特征、动作 logit 与探索方式共同决定选择。
这项诊断刻意保持有限结论。奖励截断、统一终局信用和短轨迹构成一个与权重相符的合理机制。要确认因果,仍须在控制实验中分别改变截断与信用分配,再比较动作分布和长期收益。
COMMENTS · CHAPTER 02
奖励捷径如何导致策略坍缩:一次代码诊断 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始