我早期挑战的课题之一是滑块拼图(以下简称TSP)。可是刚一开始,AI就在同一个位置来回重复,解不出题。如果它已经推进了一段我还能理解,但它连开始都做不到,只是在同一个位置反复。我认为原因在于奖励。不管是不是LLM,所有AI都以任务奖励为目标,努力获取更多奖励。但TSP要解决问题,必须知道分几个步骤的规则。假设整个棋盘由数字1~15加上一个空格组成,目标是先把1归位。那么就必须构建一个包含1的带状(环)结构,这条带上必须有1原本的正确位置、1当前的位置,以及两者之间的一个空格。于是,把包含这个空格、目标位置和数字1的最小组合,也就是总共6个格子转动起来,正确的1就会回到自己的位置。问题在于,1的正后方就是空格,数字1要前进,就必须移进空格才能得到奖励。移动之后空格会往上移,而再次把数字1移进空格又成了最大的奖励。于是,空格和1之间就出现了无限反复的现象。如果让AI不要一开始就去解答,而是先构建环,然后一直转动这个环,直到到达最终的目标区域时给予奖励,并且在完成第一个环时也给予奖励,AI就不会再走出无限反复的着法。实际训练AI时,这种情况经常发生。以前常用强化学习(reinforcement learning),但用强化学习时,这样的循环会无数次出现。学习速度也非常慢,一旦到达出现循环的地方,之前的学习就全都变成了loss。现在我不再使用强化学习,而是从Hugging Face下载模型来训练。以前的强化学习常常在成本、时间和训练loss三方面同时出问题,简直是“三连击”。我想,训练AI的朋友们如果理解了无限循环问题为什么会发生,并改变训练方法,就能把LLM用在很多领域。
从记录来看
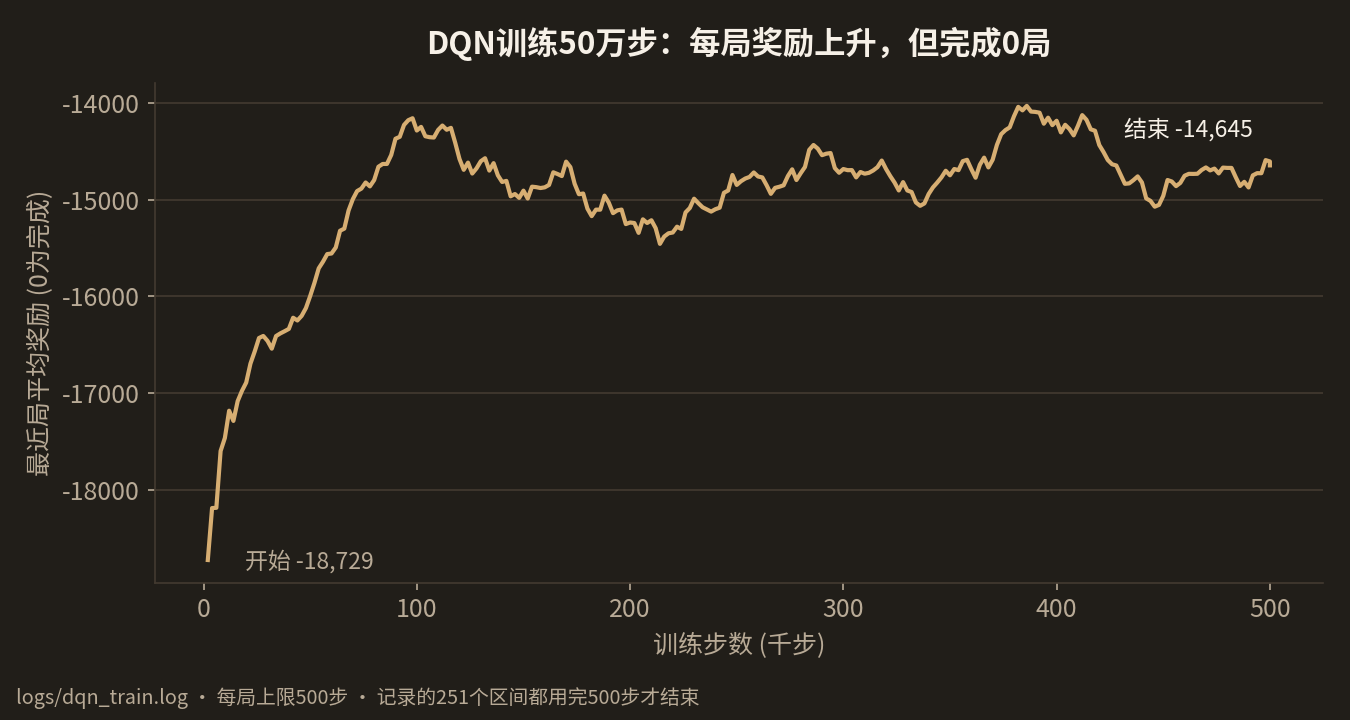
这是让DQN训练50万步(约1,000局)的日志。奖励虽然上升了,但在500步的上限内完成的局一局也没有。
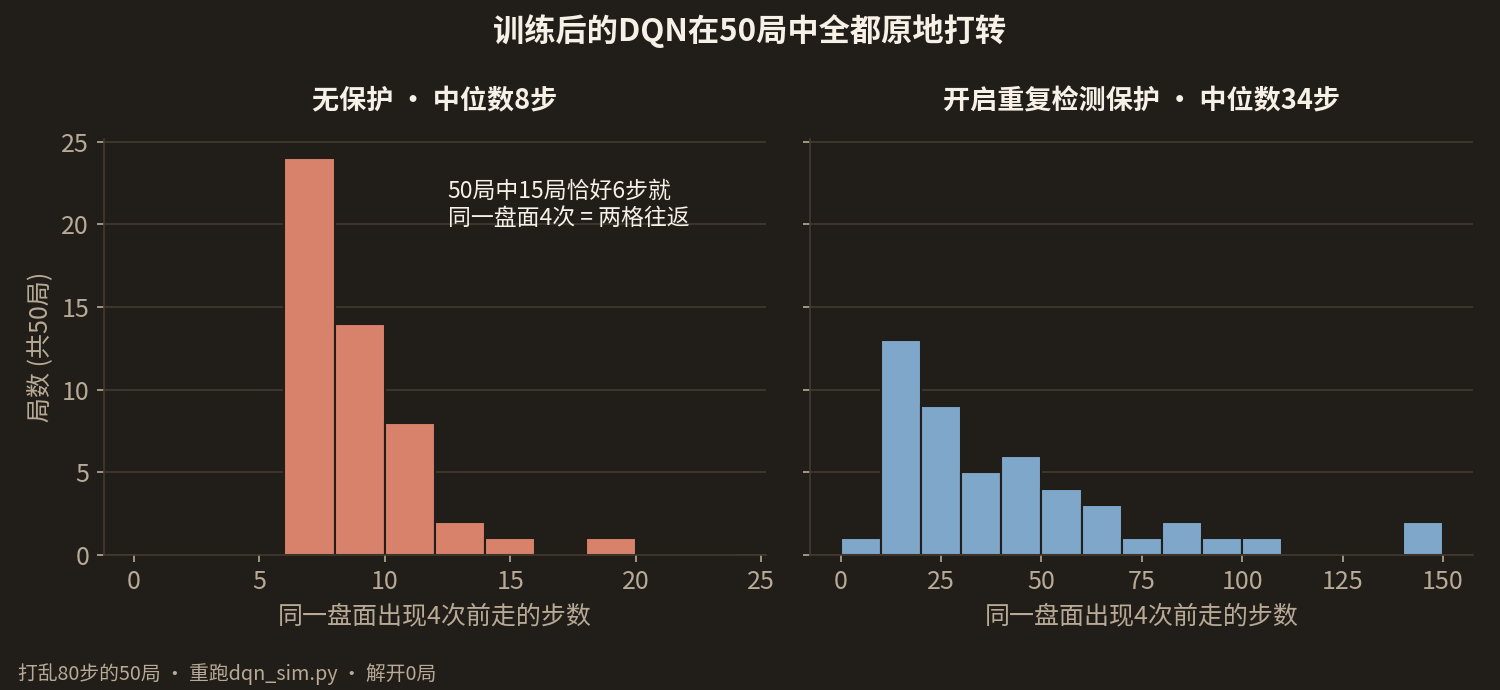
我用训练好的模型重新跑了50个打乱80步的盘面。在没有安全装置的情况下,中位数仅8步就出现了同一盘面四次,有15个盘面从一开始就只在两个格子之间来回移动。
COMMENTS · CHAPTER 01
滑块拼图的AI训练难点 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始