目标
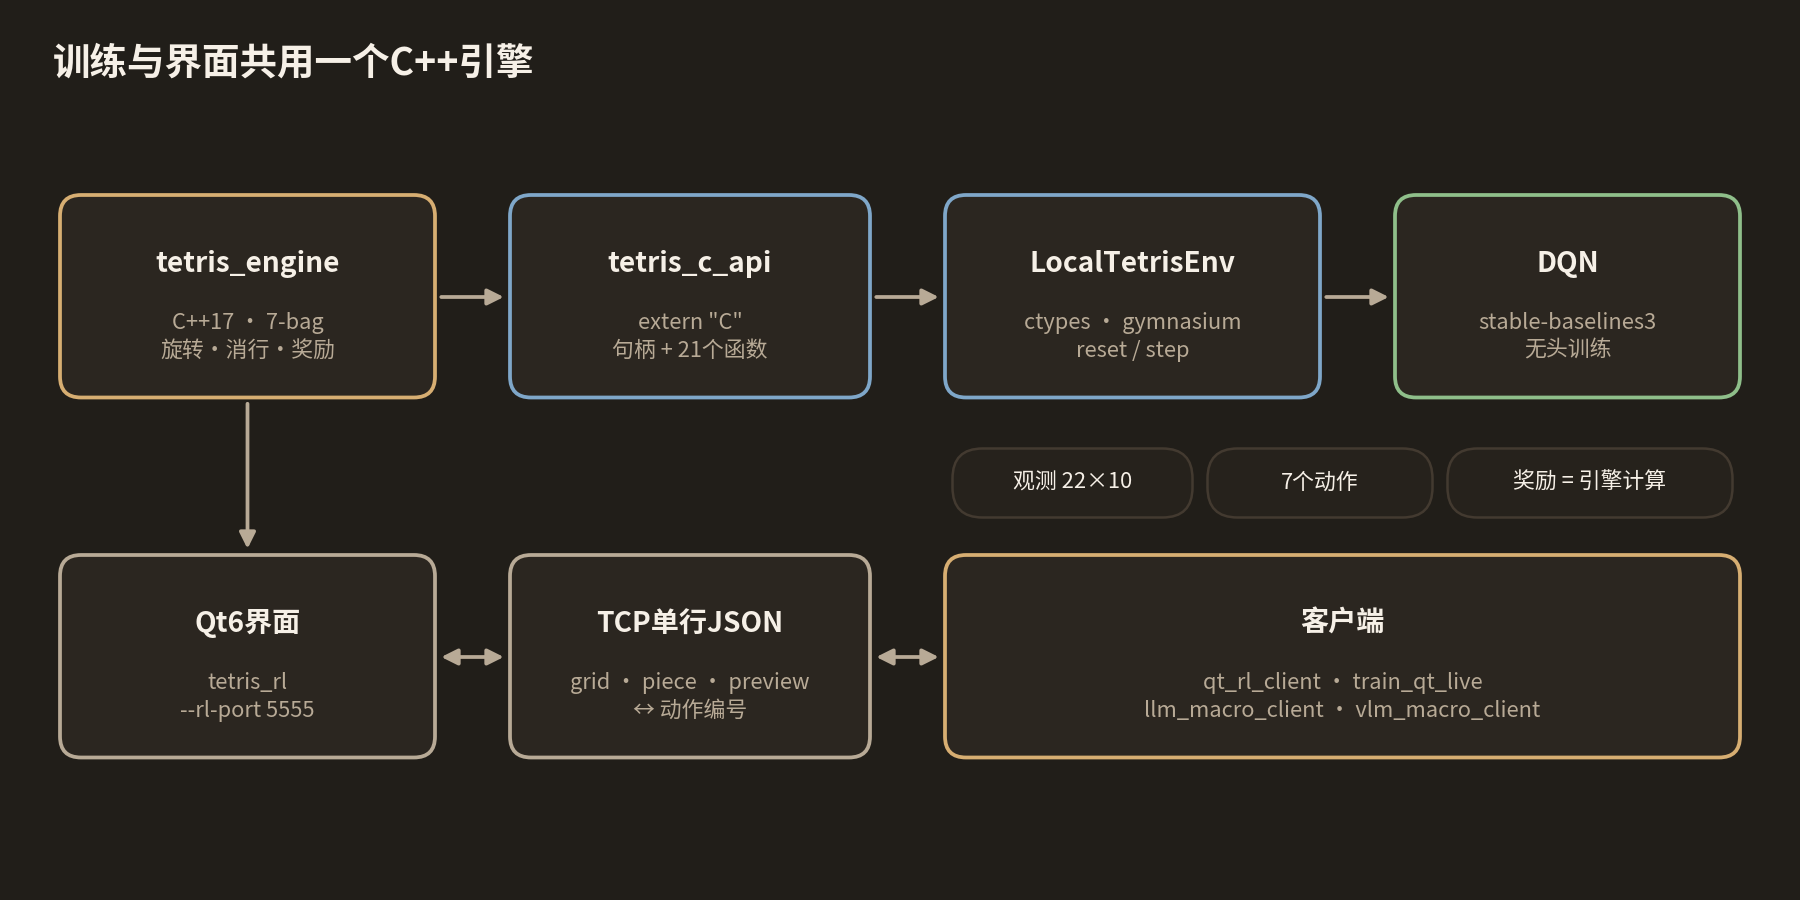
不使用 gym-tetris 或 NES ROM 这样的外部环境,而是用自己做的 C++ 引擎进行强化学习。训练在没有画面的情况下运行,Qt 画面只在查看结果时才连接。
引擎
- 棋盘宽 10 格、高 26 格。上面 4 行是方块出现的隐藏行,所以画面和观测中只能看到 22 行。
- 方块用 7-bag 抽取。把七种方块各一个打乱后依次放出,因此不会出现同一种方块很久都不出现的情况。
- 旋转时,从原位开始,依次尝试向左右、向上推开后的共 7 个位置,放在第一个能放进去的位置。
- 移动、旋转、保持不动之后,方块都会自动下落一格。因此一个方块可用的动作数等于棋盘的高度。
- 在方块固定的瞬间计算奖励。奖励的构成会在下一篇中介绍。
C API 与 Gym 环境
引擎是 C++ 类,Python 无法直接调用。我们用 21 个 extern "C" 函数把它封装起来,构建成共享库(libtetris_c_api.dylib),Python 用 ctypes 加载。这个库不依赖 Qt 就能构建。
LocalTetrisEnv 用这些函数构建 gymnasium 环境。
- 观测:22×10 格。空格为 0,方块按种类为 1~7。不区分已固定的方块和正在移动的方块。
- 动作:7 个。不动、左移、右移、顺时针旋转、逆时针旋转、下移一格、直接落下。
- 奖励:直接使用引擎计算出的值。
引擎知道接下来的 5 个方块,但没有放进观测中。
Qt 画面与 TCP
用 --rl-port 5555 启动 Qt 应用(tetris_rl),就会打开 TCP 服务器。应用把棋盘状态以一行 JSON 发送,客户端以一行返回动作编号。JSON 中包含棋盘、当前方块的种类、位置、旋转状态,以及接下来的方块列表。在画面上运行训练好的模型,或者连接后面出现的 LLM、VLM 客户端时,都使用这条通道。
这一阶段的实际代码
C API 把引擎装在一个句柄里,接收动作编号并推进一步。
tetris/src/tetris_c_api.cpp
struct TetrisHandle {
    TetrisEngine engine;
    std::vector<uint8_t> render_grid;
    explicit TetrisHandle(const TetrisEngineConfig& cfg) : engine(cfg) {}
};

// Control
void tetris_set_seed(TetrisHandle* h, uint64_t seed) { h->engine.set_seed(seed); }

void tetris_reset(TetrisHandle* h) { h->engine.reset(); }

// Step returns 1 if alive, 0 if game over
int tetris_step(TetrisHandle* h, int action) {
    const auto a = static_cast<TetrisAction>(static_cast<int8_t>(action));
    const bool alive = h->engine.step(a);
    return alive ? 1 : 0;
}
Python 环境从引擎填好的棋盘中切掉隐藏的 4 行,作为观测使用。
local_tetris_env.py
def _obs(self) -> np.ndarray:
    written = int(self._lib._dll.tetris_fill_render_grid(self._h, self._buf, self._w * self._hgt))
    if written <= 0:
        raise RuntimeError("tetris_fill_render_grid() 실패")
    arr = np.frombuffer(self._buf, dtype=np.uint8, count=self._w * self._hgt)
    arr = arr.reshape(self._hgt, self._w)
    visible = arr[self._hidden :, :]  # drop hidden rows
    return visible[:, :, None]

def reset(self, *, seed: int | None = None, options: dict[str, Any] | None = None):
    super().reset(seed=seed)
    if seed is not None:
        self._lib._dll.tetris_set_seed(self._h, int(seed))
    self._lib._dll.tetris_reset(self._h)
    return self._obs(), {}

def step(self, action: int):
    alive = int(self._lib._dll.tetris_step(self._h, int(action)))
    reward = float(self._lib._dll.tetris_last_reward(self._h))
    terminated = (alive == 0) or (int(self._lib._dll.tetris_game_over(self._h)) == 1)
    truncated = False
    info = {
        "lines_cleared_total": int(self._lib._dll.tetris_lines_cleared_total(self._h)),
        "piece_index": int(self._lib._dll.tetris_piece_index(self._h)),
        "stack_height": int(self._lib._dll.tetris_stack_height(self._h)),
        "bumpiness": int(self._lib._dll.tetris_bumpiness(self._h)),
        "holes": int(self._lib._dll.tetris_holes(self._h)),
    }
    return self._obs(), reward, terminated, truncated, info
下一篇是“2. DQN 训练 37 万步,消除行数为 0”。
COMMENTS · CHAPTER 01
把 C++ 俄罗斯方块引擎封装成强化学习环境 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始