现在的五子棋AI的构成
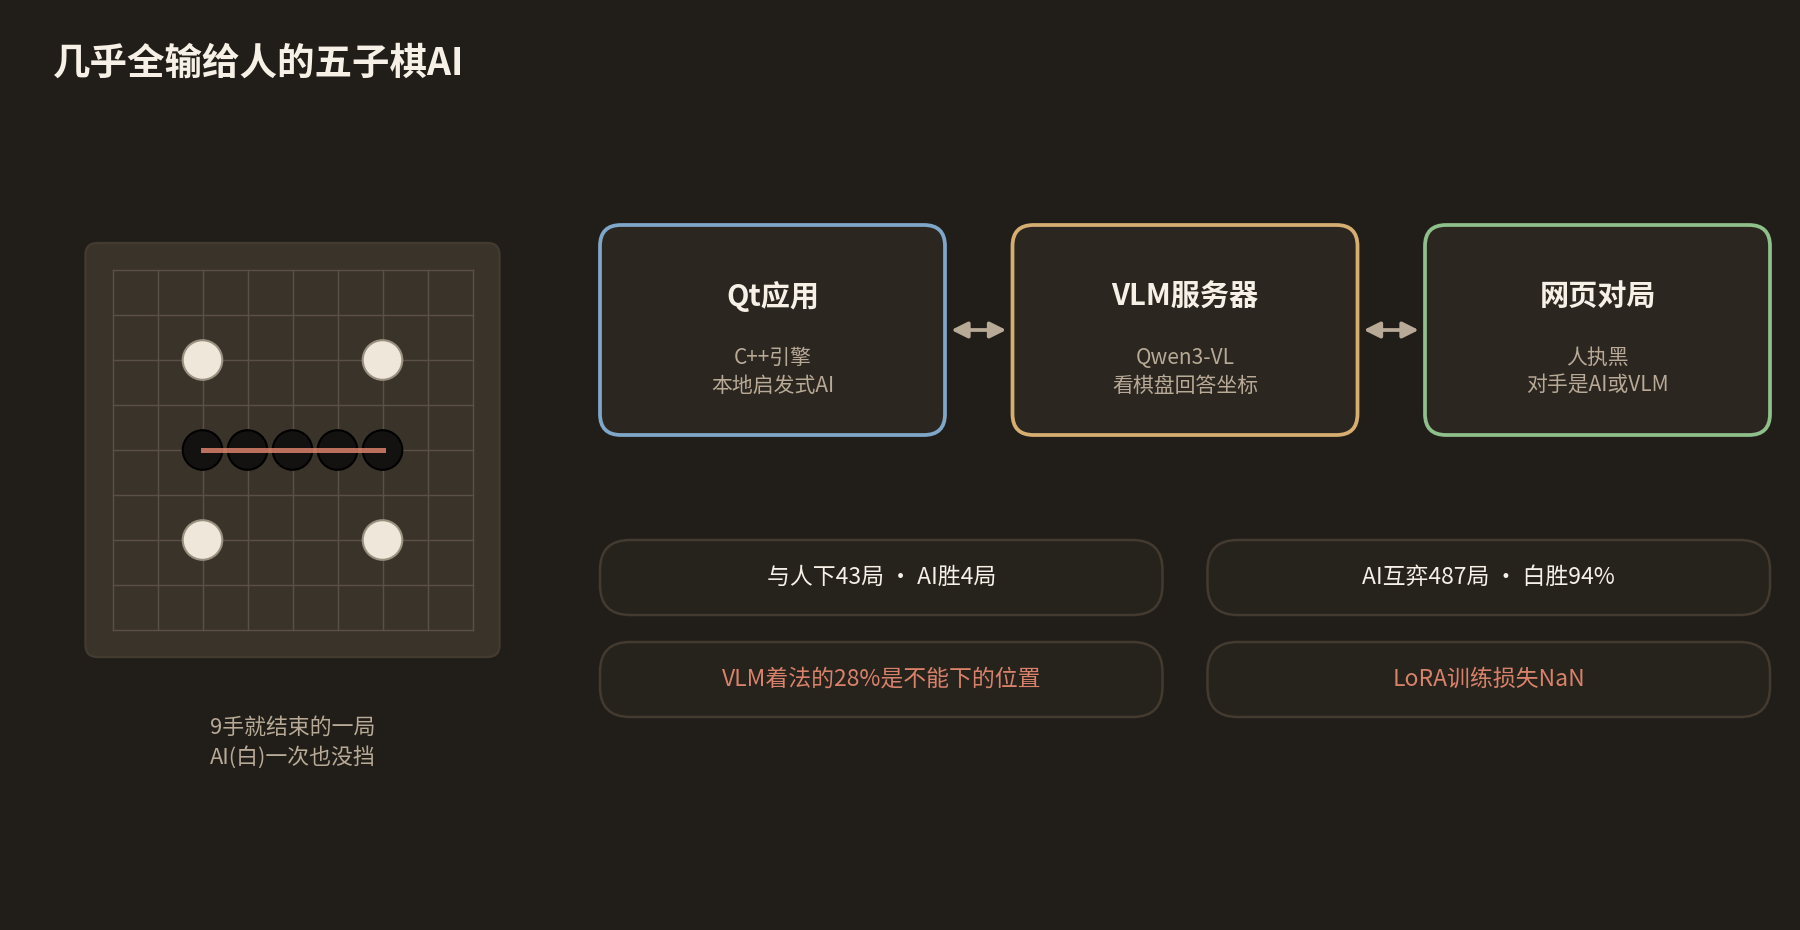
五子棋AI由三部分组成。
- Qt应用:用C++编写的五子棋引擎和本地启发式AI。可以进行人对AI、人对VLM、AI对VLM的对局。
- VLM服务器:Qwen3-VL看着棋盘图像和文字形式的棋盘,回答下一手的坐标。
- 网页对局:在[omook.mariago.kr](https://omook.mariago.kr/play)上,人执黑,对手可以从本地AI和VLM中选择。
与人对局的成绩
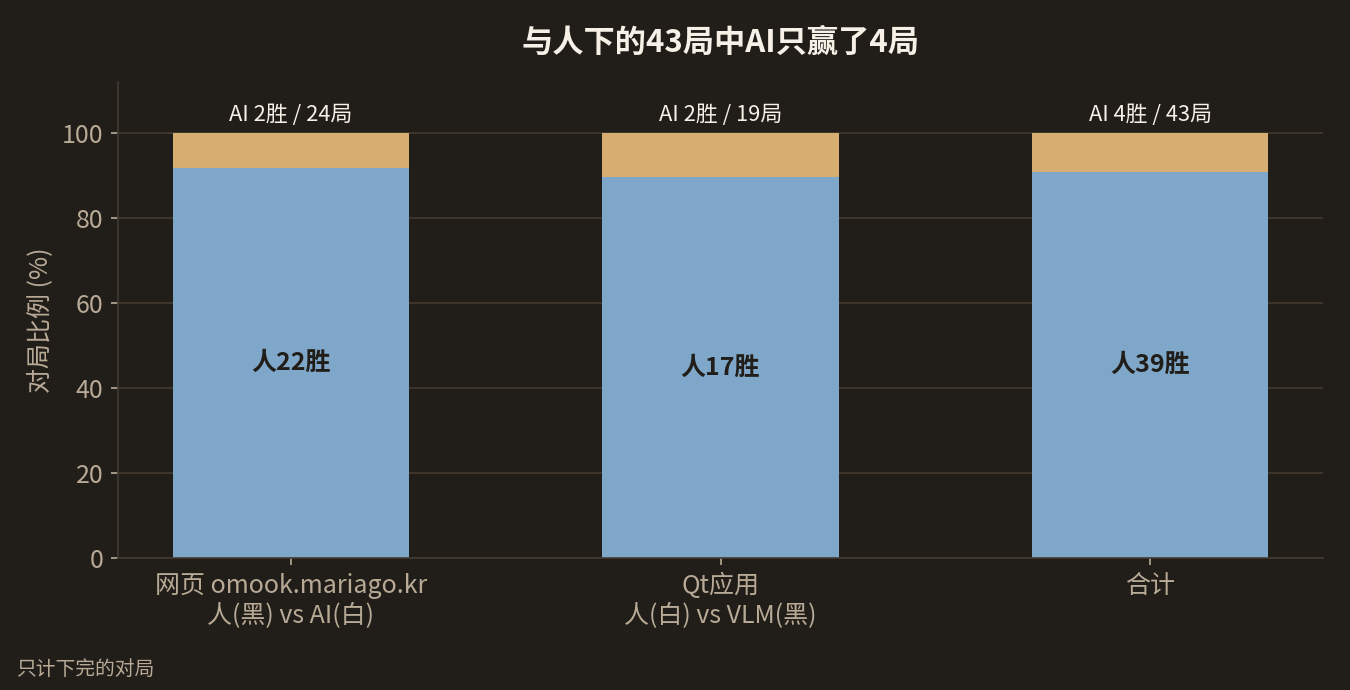
只统计下到最后的对局,人在43局中赢了39局。在网页上人赢了24局中的22局,在Qt应用中对VLM赢了19局中的17局。网页对局中有2局,在黑棋下了五手的过程中AI一次都没有挡,结果9手就结束了。
AI之间的训练对局
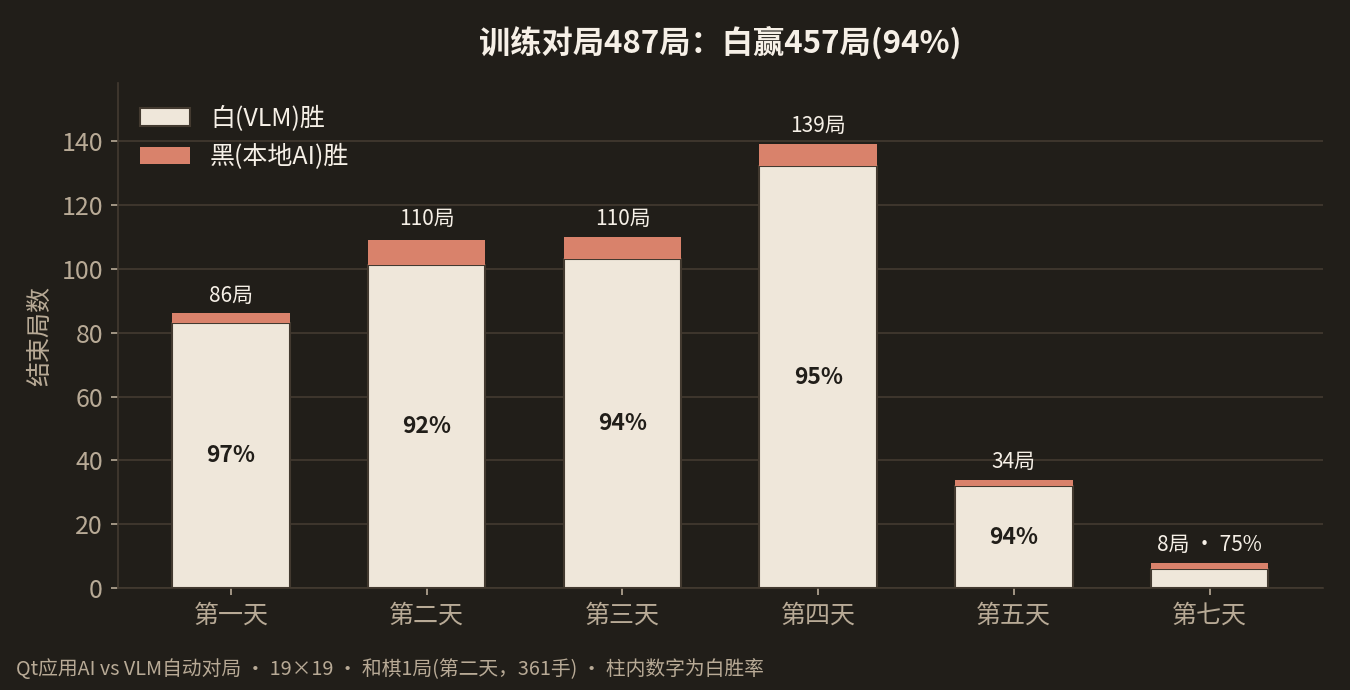
一周时间里,我们让Qt应用中的本地AI(黑)和VLM(白)自动持续对弈。在结束的487局中,白棋赢了457局。黑棋赢了29局,和棋是下到第361手的1局。
VLM连坐标都会出错
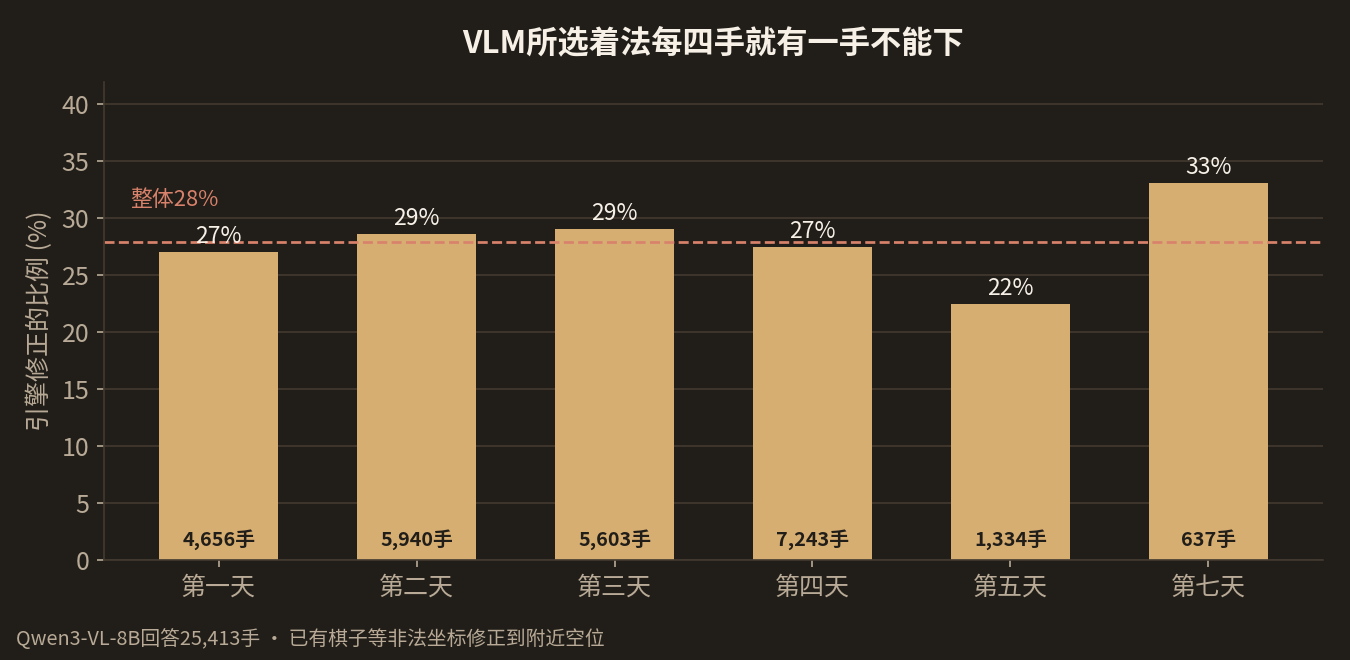
在VLM选择的25,413手中,有7,089手(28%)是像已经有棋子的格子这样无法落子的位置。这时服务器会再问一次,如果还是错,就把它移到最近的空格上。正如代码注释中写的那样,这种修正只是挽救坐标的装置,并不保证是好棋。
自动训练也是坏的
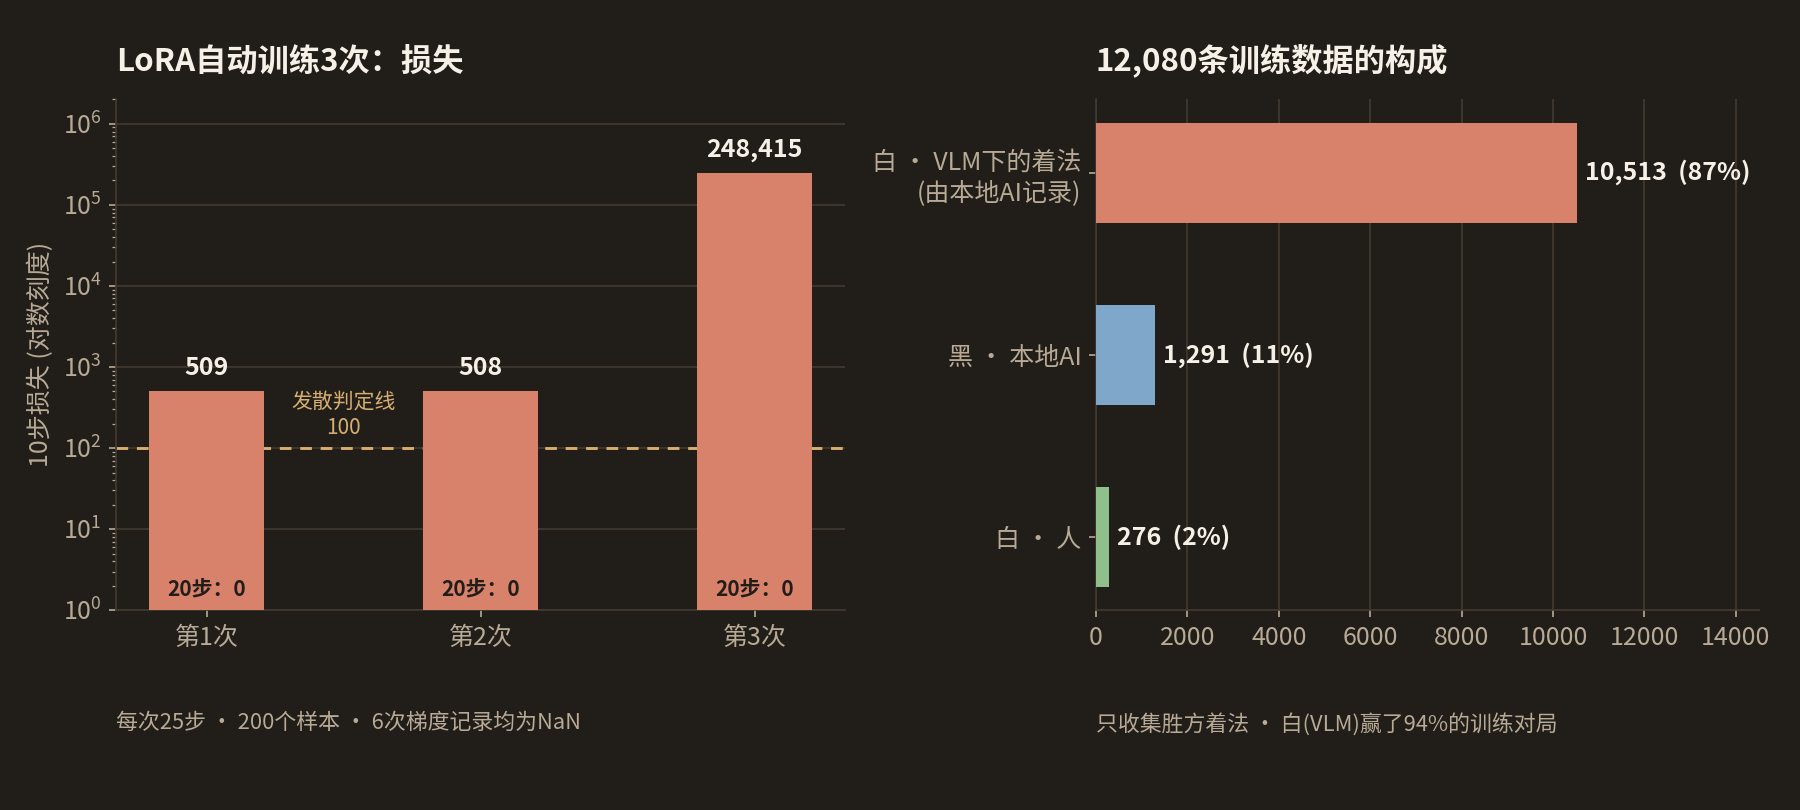
我们设置成每次训练对局结束后,都用获胜一方的着法重新训练LoRA。数据积累到了12,080条,但看最后的训练记录,损失从248,414降到了0,梯度是NaN。这意味着训练没有正常进行。现在服务器在没有LoRA的情况下,以基础模型Qwen3-VL-2B运行。
留下来的训练记录有三次。全部都是在自动对局的第五天运行的,每次只用200条样本训练25步。三次都在第10步时损失超过500,在第20步时变成0。梯度的六条记录全部是NaN。train_vlm.py把损失超过100视为发散,而三次都超过了这条线。
收集到的数据也偏向一边。12,080条中有10,513条(87%)是白棋的着法。这是因为在训练对局中白棋赢了94%,而这些白棋着法是VLM下的,却被记录成了本地AI下的。本地AI执黑获胜的对局中的着法只有1,291条,人获胜的对局中的着法只有276条。
总结来说,现在的五子棋AI几乎全输给了人,而VLM还处于什么都没学到的状态。从下一篇开始,将依次整理规则、弱点和修正计划。
这一步的实际代码
这是当VLM选择了无法落子的格子时,把它移到附近空格的部分。
vlm_pva_server.py
if (
    not illegal_adj_fallback
    and board is not None
    and not _is_legal_vlm_move(board, r, c, size)
):
    if args.strict:
        raise RuntimeError(f"모델이 부적절 칸을 반환: ({r},{c})")
    why = _move_rejection_reason(board, r, c, size)
    if _is_opening_board(board, size):
        near = _opening_center(size)
    else:
        near = _nearest_empty(board, r, c, size=size)
    if near is None:
        raise RuntimeError("빈 칸 없음 (보드 가득 참)")
    logging.warning(
        "모델 좌표 (%d,%d) 부적절 — 사유: %s → 인접·근접 빈 칸 (%d,%d) 로 보정 "
        "(보정은 좌표 복구용 휴리스틱이라 좋은 수를 보장하지 않음)",
        r,
        c,
        why,
        *near,
    )
    r, c = near
    corrected = True
    correct_reason = why
下一篇是“2. 连珠规则让白棋无敌”。
COMMENTS · CHAPTER 01
输给人的五子棋AI 评论 0
还没有评论。阅读时有疑问或想补充的内容,欢迎留言。
发表评论前,请用 Google 开始并登记昵称和邮箱。
用 Google 开始