¿Qué vamos a llamar "mejor"?
Que baje la pérdida de entrenamiento no significa que hayan mejorado las partidas reales. Una IA de go debe leer las coordenadas, hacer jugadas legales, no pasar en mitad de una lucha y no rellenar sus propios ojos sin necesidad. Antes de cambiar el modelo, hay que medir estos aspectos sobre el mismo conjunto de evaluación.
Paso 1: Separar los aspectos que se evalúan
La prueba de coordenadas mide si se lee correctamente la posición de las piedras. La prueba de reglas cuenta la proporción de jugadas ilegales que produce el modelo. La prueba de partidas juega contra un rival fijo intercambiando los colores y guarda las capturas, el momento de los pases y el motivo del final. Si se juntan fallos distintos en una sola tasa de victorias, no se sabe qué hay que arreglar.
- Precisión de coordenadas en los cuatro cuadrantes
- Proporción de jugadas ilegales en la primera respuesta y en las nuevas peticiones
- Número de pases prematuros antes de la jugada 80
- Sesgo de dirección que elige repetidamente la misma columna o esquina
- Capturas y resultado final de las partidas con colores intercambiados
Paso 2: Conservar los resultados del modelo de referencia
No ejecutes solo el modelo nuevo: guarda los resultados del modelo actual en producción en el mismo formato JSON. Hay que anotar la versión de los datos de evaluación, el nombre del modelo, el prompt y el commit del motor de reglas para poder reproducir las cifras más adelante. Si hay aleatoriedad, fija también la semilla y la configuración de generación.
Paso 3: Señalar los límites de las partidas cortas
Un recuento provisional tras detener la partida en la jugada 80 es útil como comprobación rápida de regresiones, pero no se puede interpretar como una tasa de victorias oficial ni como un rango. Todavía quedan por resolver la vida y muerte y el final de la partida. En las evaluaciones cortas se miran las jugadas ilegales, los pases prematuros y las pérdidas tácticas evidentes; la comparación de fuerza de juego se juzga aparte, reuniendo suficientes partidas completas.
Paso 4: Convertir los fallos en los siguientes datos
Los fallos que se repiten en la evaluación se guardan junto con el estado del tablero, la respuesta original del modelo y el motivo del rechazo. Los errores de coordenadas se clasifican como pruebas de entrada, las huidas inútiles en escalera como ejemplos tácticos y los pases prematuros como ejemplos de partidas en curso. No metas todos los fallos en el entrenamiento sin más; separa los problemas que el código de reglas puede bloquear con seguridad de los que el modelo tiene que aprender.
Una buena hoja de evaluación no es una puntuación para elogiar al modelo, sino un mapa que indica dónde corregir a continuación.
Registros reales
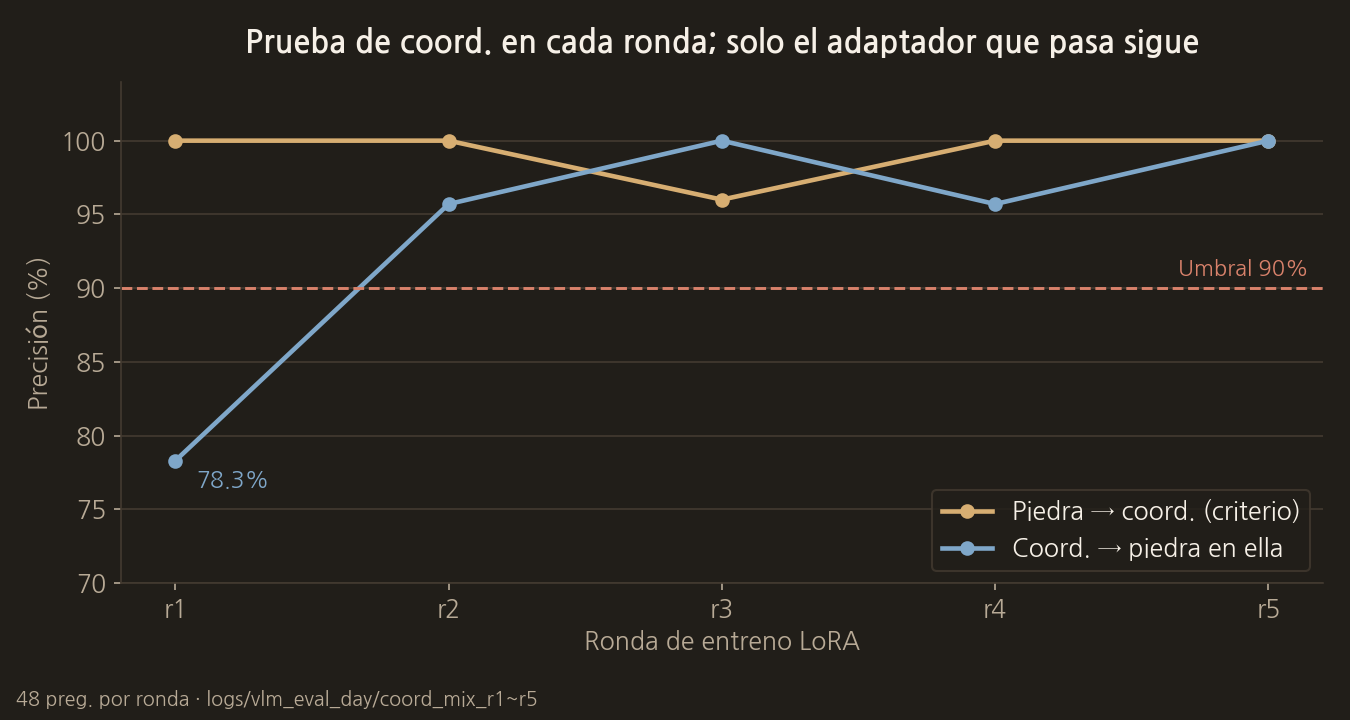
Mientras entrenábamos el LoRA en cinco rondas, repetimos la misma prueba de coordenadas en cada ronda. En r1, leer la posición de una piedra como coordenada daba un 100%, pero responder qué piedra hay en una coordenada dada daba un 78,3%. Es una diferencia que se habría pasado por alto mirando un solo aspecto.
El código real de este paso
Este código agrupa los resultados de la prueba de coordenadas en cuatro zonas: arriba a la izquierda (TL), arriba a la derecha (TR), abajo a la izquierda (BL) y abajo a la derecha (BR). Guarda la precisión por zona junto con la precisión global, de modo que el sesgo de dirección se ve de inmediato.
vlm_server/verify_coords.py
def _quadrant(r: int, c: int) -> str:
    if r < 9.5 and c < 9.5:
        return "TL"
    if r < 9.5 and c >= 9.5:
        return "TR"
    if r >= 9.5 and c < 9.5:
        return "BL"
    return "BR"
vlm_server/verify_coords.py
def summarize(results: List[TrialResult]) -> Dict[str, Any]:
    by_kind = Counter()
    ok_kind = Counter()
    by_q = Counter()
    ok_q = Counter()
    for r in results:
        by_kind[r.kind] += 1
        by_q[r.quadrant] += 1
        if r.ok:
            ok_kind[r.kind] += 1
            ok_q[r.quadrant] += 1
    total = len(results) or 1
    return {
        "n": len(results),
        "accuracy": round(100.0 * sum(1 for r in results if r.ok) / total, 1),
        "by_kind": {
            k: {
                "n": by_kind[k],
                "ok": ok_kind[k],
                "acc": round(100.0 * ok_kind[k] / max(1, by_kind[k]), 1),
            }
            for k in sorted(by_kind)
        },
        "by_quadrant": {
            q: {
                "n": by_q[q],
                "ok": ok_q[q],
                "acc": round(100.0 * ok_q[q] / max(1, by_q[q]), 1),
            }
            for q in ("TL", "TR", "BL", "BR")
        },
        "avg_ms": round(sum(r.ms for r in results) / total, 1),
    }
Modelo utilizado: Qwen3-VL-8B-Instruct + adaptador LoRA (lora_mix_qwen_r5). El código fuente completo y la descripción del modelo están en la entrada "8. El código fuente completo y los modelos utilizados".
COMMENTS · CHAPTER 05
Fijar el conjunto de evaluación antes de entrenar 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google