Todavía no ha empezado
El Othello no tiene ni código de entrenamiento ni datos de entrenamiento. Lo que sigue es un plan.
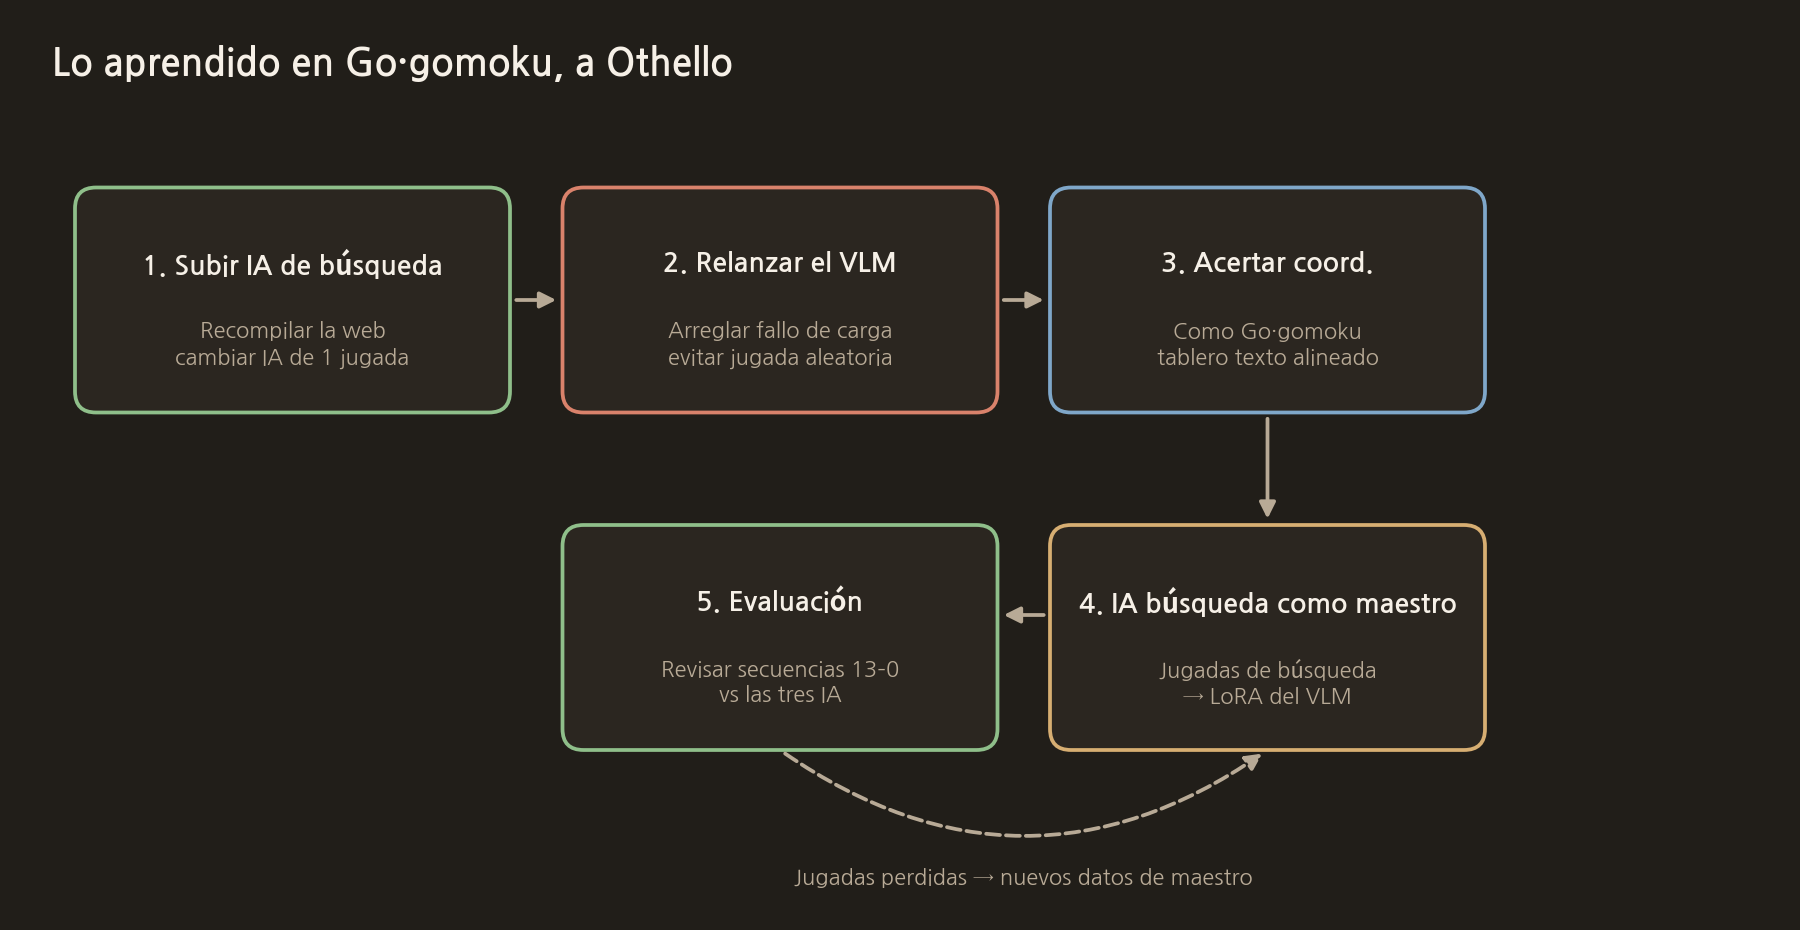
1. Publicar la IA de búsqueda
Al volver a compilar la web, se publica la IA de búsqueda de la entrada 2. Las secuencias del 13–0 de la entrada 1 dejarán de funcionar.
2. Volver a poner en marcha el VLM
Se arregla el problema de carga o se cambia a Qwen3-VL-8B, que es el que usa el servidor de go. Si no se puede cargar el modelo, el servidor no arrancará, y las jugadas cambiadas a aleatorias quedarán en el registro y se mostrarán también en la pantalla.
3. Ajustar las coordenadas
En el go, después de descubrir que cada modelo escribe las coordenadas de forma distinta, dedicamos mucho tiempo al entrenamiento de ajuste de coordenadas. Estamos aplicando el mismo entrenamiento al gomoku. En la prueba previa al entrenamiento, con solo alinear bien las columnas del tablero en texto, la proporción de veces que se elegía una casilla ya ocupada bajó del 40% al 21%.
El Othello es de 8×8 y el prompt incluye la lista de jugadas legales, así que la carga de las coordenadas es pequeña. Aun así, empezamos por la misma prueba.
4. La IA de búsqueda como profesora
En el go, tras corregir la heurística, entrenamos el modelo con esa heurística como profesora. En el Othello, la profesora es la IA de búsqueda. Se entrena la LoRA del VLM usando como respuesta correcta las jugadas que elige la IA de búsqueda.
Como la respuesta correcta de cada jugada se decide por búsqueda, los datos no se desequilibran hacia un lado como en el entrenamiento automático del gomoku, que solo recogía las jugadas del bando ganador.
5. Evaluación
- Como en la entrada 1, se despliegan todas las jugadas de las negras hasta la jugada 11 y se cuenta si existe alguna secuencia de aniquilación.
- Se juegan 100 partidas contra cada una: la aleatoria, la IA de una jugada y la IA de búsqueda.
- En las partidas contra personas se registra el tipo de rival. Los registros de partidas actuales no tienen ese campo.
Las jugadas de las partidas perdidas en la evaluación se vuelven a añadir como datos de la profesora.
El código real de esta etapa
Este es el prompt que se le da ahora al VLM. Incluye la lista de jugadas legales y le pide que responda con una sola línea de JSON.
vlm_server/server.py
SYSTEM_PROMPT = (
    "당신은 8×8 오델로(Reversi)의 강한 플레이어입니다. "
    "보드 이미지와 텍스트 격자를 보고 다음 단 한 수를 고르세요. "
    "텍스트 격자가 이미지와 다르면 텍스트를 우선하세요. "
    "좌표는 0-indexed 정수 (row, col) 이며 각각 0..7 입니다. "
    "(0,0)은 좌상단 A1, 열 A–H = col 0–7, 행 1–8 = row 0–7. "
    "X=흑, O=백, .=빈칸. 반드시 합법수만 고르세요. "
    "합법수는 상대 돌을 하나 이상 끼워 뒤집는 빈 칸입니다. "
    "응답은 설명 없이 JSON 한 줄만 출력하세요."
)

# ...

def build_prompt(
    board: bytes,
    ai_side: int,
    legal: list[tuple[int, int]],
    forbidden: Optional[list[tuple[int, int]]] = None,
) -> str:
    side = "흑(X)" if ai_side == 1 else "백(O)"
    n_b, n_w = rules.counts(board)
    forbid_note = ""
    if forbidden:
        banned = ", ".join(f"({r},{c})" for r, c in forbidden[:16])
        forbid_note = f"\n금지 좌표(고르지 마세요): {banned}\n"
    return (
        f"당신의 차례: {side}. 흑 {n_b} · 백 {n_w}.\n"
        "보드 (X=흑, O=백, .=빈, 행=row 0=위, 열=col 0=왼쪽):\n"
        f"{rules.board_text(board)}\n\n"
        f"합법수: {rules.format_moves(legal)}\n"
        f"{forbid_note}"
        '다음 수를 JSON 한 줄로만 답하세요. 예: {"row": 2, "col": 3} '
        '합법수가 없으면 {"pass": true} 만 출력.'
    )
La siguiente entrada es "5. El código fuente completo y los modelos utilizados".
COMMENTS · CHAPTER 04
Un plan para llevar a Othello lo aprendido en el go y el gomoku 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google