Cómo está construida la IA de gomoku actual
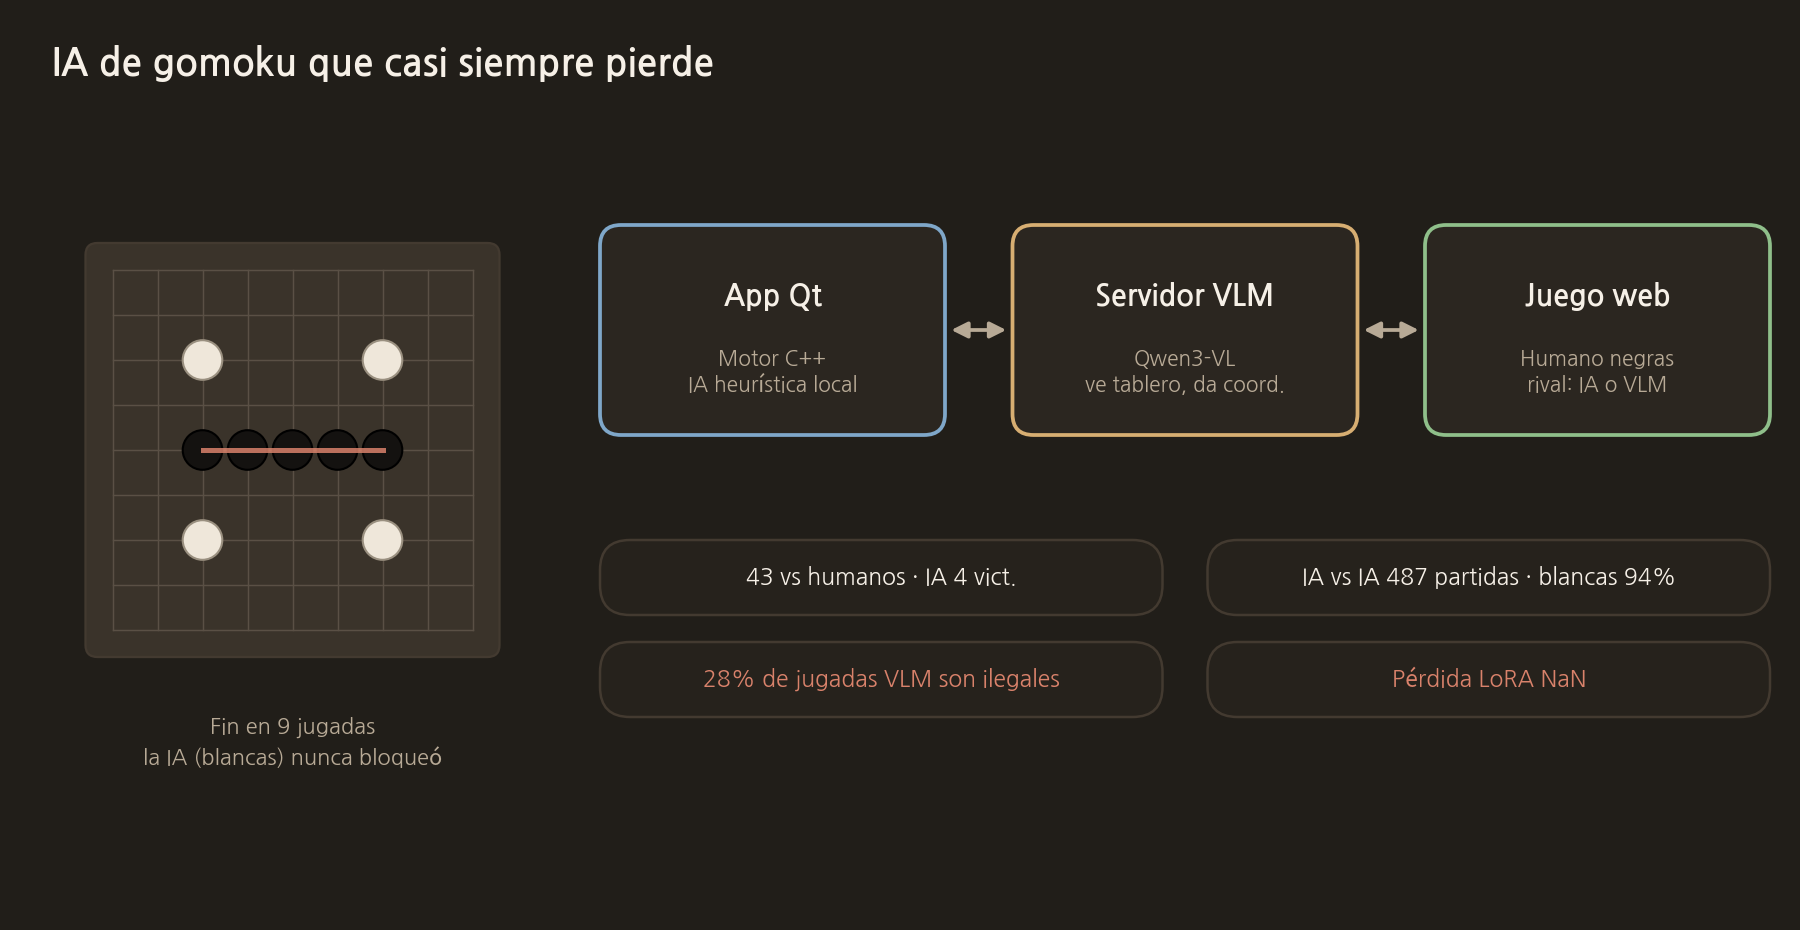
La IA de gomoku tiene tres partes.
- App de Qt: un motor de gomoku y una IA heurística local escritos en C++. Permite partidas de persona contra IA, persona contra VLM e IA contra VLM.
- Servidor VLM: Qwen3-VL mira una imagen del tablero y un tablero en texto y responde la coordenada de la siguiente jugada.
- Partida web: en [omook.mariago.kr](https://omook.mariago.kr/play) la persona juega con negras y elige como rival entre la IA local y el VLM.
Resultados contra personas
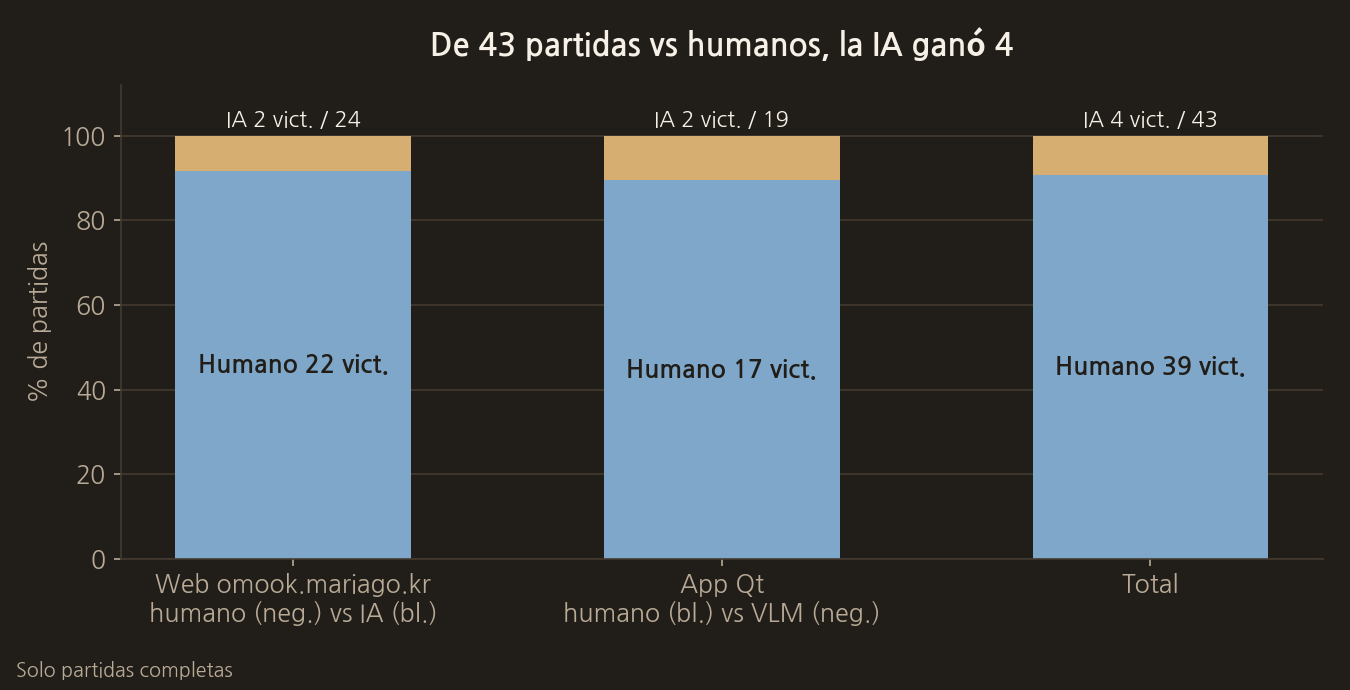
Contando solo las partidas jugadas hasta el final, las personas ganaron 39 de 43. En la web, las personas ganaron 22 de 24, y en la app de Qt contra el VLM, 17 de 19. Dos de las partidas web terminaron en 9 jugadas porque la IA no bloqueó ni una vez mientras negras colocaban cinco piedras.
Partidas de entrenamiento entre IA
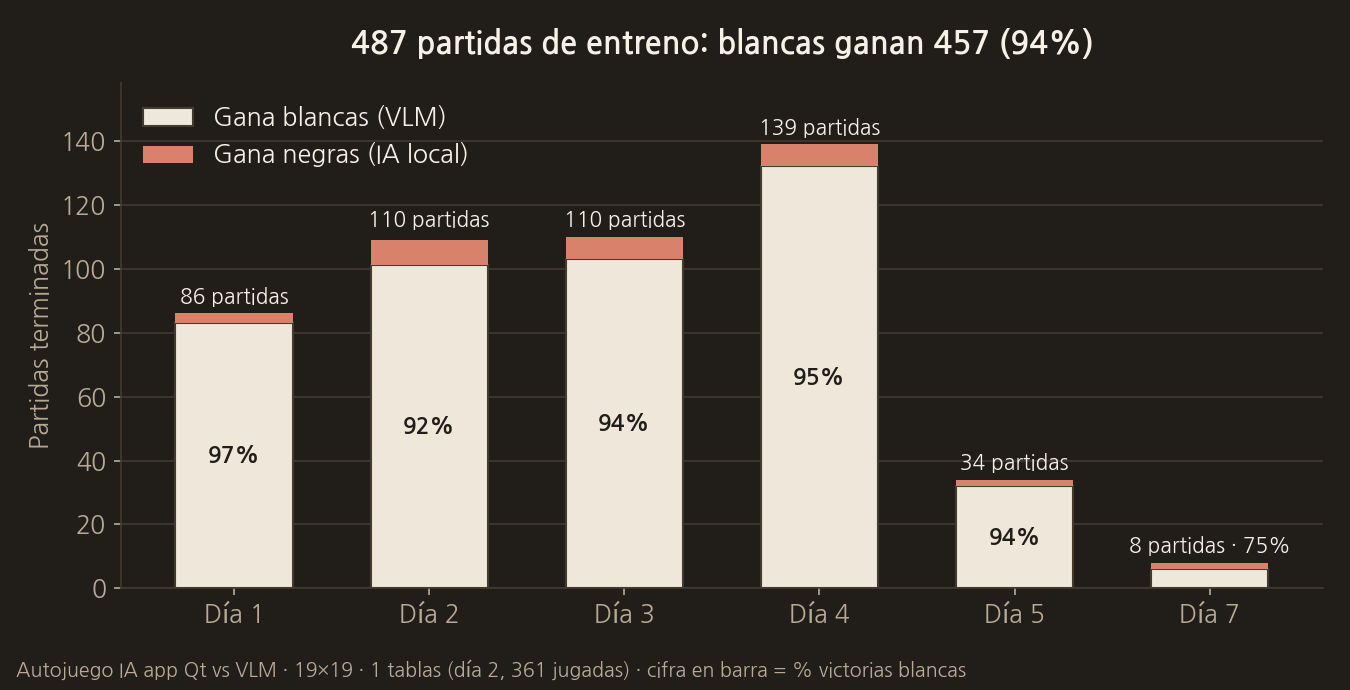
Durante una semana, hice que en la app de Qt la IA local (negras) y el VLM (blancas) jugaran entre sí de forma automática y continua. De las 487 partidas terminadas, blancas ganaron 457. Negras ganaron 29, y hubo un empate en una partida que llegó a la jugada 361.
El VLM falla ya en las coordenadas
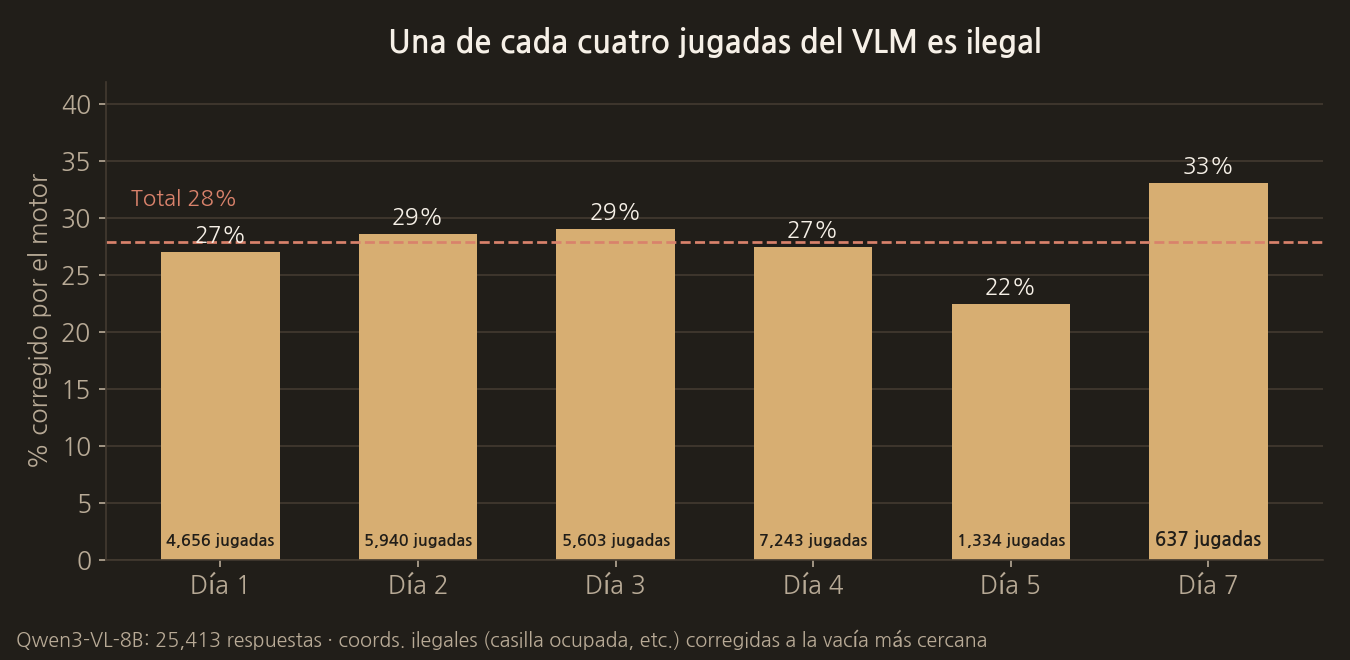
De las 25.413 jugadas que eligió el VLM, 7.089 (28%) eran posiciones imposibles, como casillas que ya tenían una piedra. En ese caso el servidor vuelve a preguntar y, si sigue fallando, mueve la piedra a la casilla vacía más cercana. Como dice el comentario del código, esta corrección solo sirve para rescatar la coordenada; no garantiza una buena jugada.
El entrenamiento automático también estaba roto
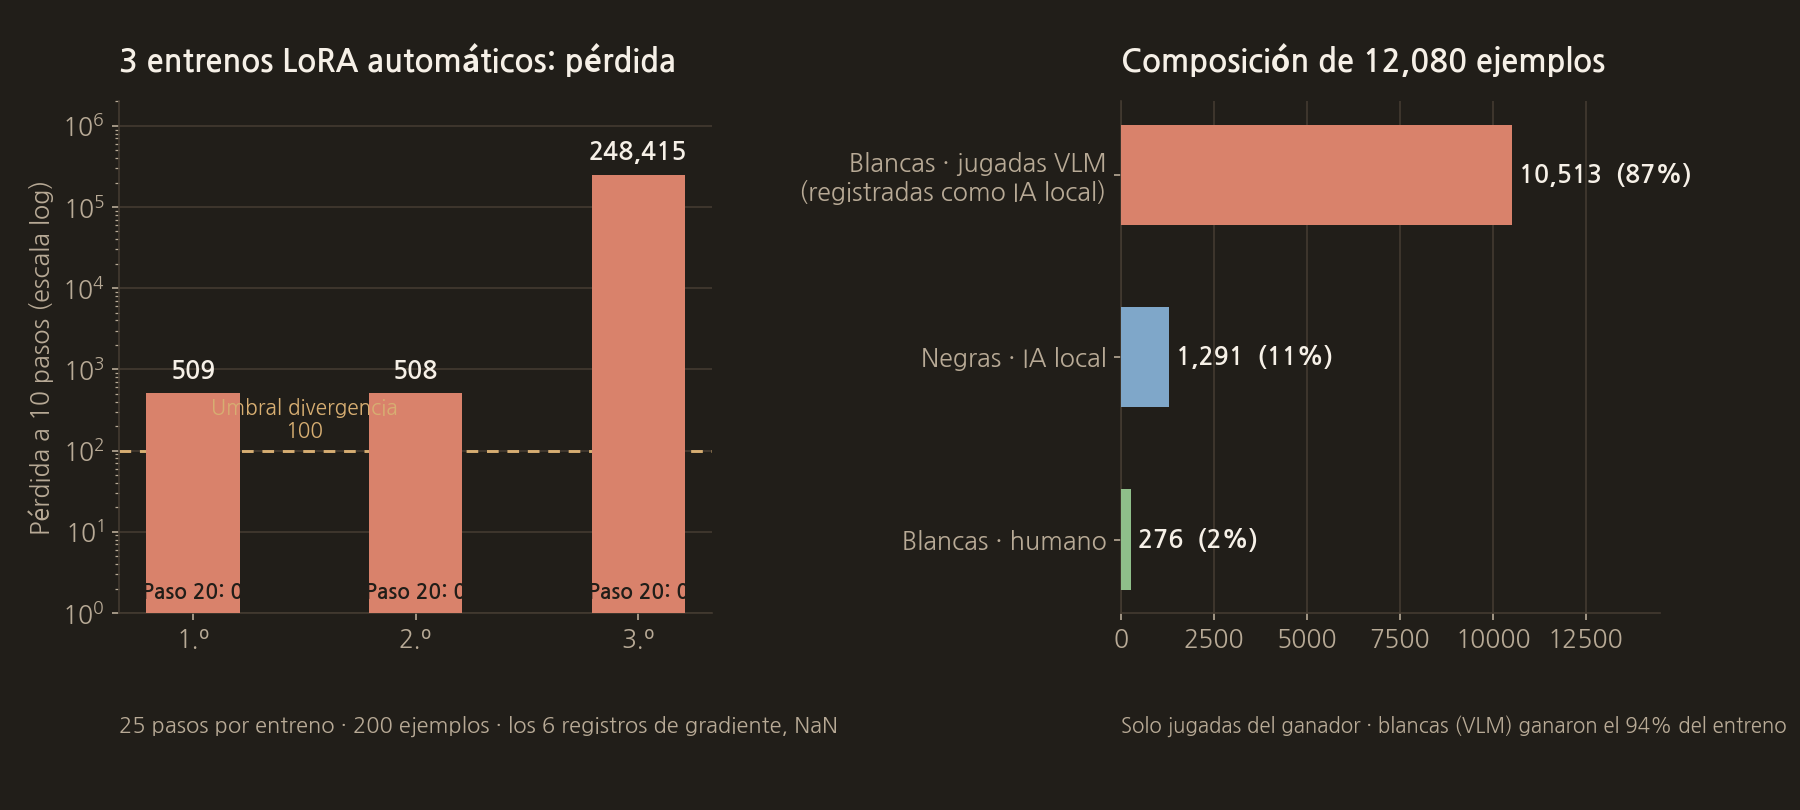
Configuré que, al terminar cada partida de entrenamiento, el LoRA se volviera a entrenar con las jugadas del lado ganador. Los datos llegaron a 12.080 ejemplos, pero el último registro de entrenamiento muestra que la pérdida cayó de 248.414 a 0 y que el gradiente es NaN. Eso significa que el entrenamiento no funcionó. Ahora el servidor está funcionando con el modelo base Qwen3-VL-2B, sin LoRA.
Quedan tres registros de entrenamiento. Todos se ejecutaron el quinto día de juego automático, y cada uno usó solo 200 ejemplos durante 25 pasos. En los tres, la pérdida superó 500 en el paso 10 y llegó a 0 en el paso 20. Los seis registros de gradiente son todos NaN. train_vlm.py considera divergencia una pérdida superior a 100, y las tres ejecuciones cruzaron esa línea.
Los datos reunidos también están desequilibrados. De los 12.080 ejemplos, 10.513 (87%) son jugadas de blancas. Esto se debe a que blancas ganaron el 94% de las partidas de entrenamiento, y esas jugadas de blancas las hizo el VLM pero quedaron registradas como jugadas de la IA local. Solo 1.291 jugadas provienen de partidas que la IA local ganó con negras, y 276 de partidas ganadas por personas.
En resumen, la IA de gomoku actual pierde casi todas las partidas contra personas, y el VLM todavía no ha aprendido nada. A partir de la siguiente entrada repaso por orden las reglas, los puntos débiles y el plan para corregirlos.
El código real de este paso
Esta es la parte que mueve la elección del VLM a una casilla vacía cercana cuando elige una casilla en la que no se puede jugar.
vlm_pva_server.py
if (
    not illegal_adj_fallback
    and board is not None
    and not _is_legal_vlm_move(board, r, c, size)
):
    if args.strict:
        raise RuntimeError(f"모델이 부적절 칸을 반환: ({r},{c})")
    why = _move_rejection_reason(board, r, c, size)
    if _is_opening_board(board, size):
        near = _opening_center(size)
    else:
        near = _nearest_empty(board, r, c, size=size)
    if near is None:
        raise RuntimeError("빈 칸 없음 (보드 가득 참)")
    logging.warning(
        "모델 좌표 (%d,%d) 부적절 — 사유: %s → 인접·근접 빈 칸 (%d,%d) 로 보정 "
        "(보정은 좌표 복구용 휴리스틱이라 좋은 수를 보장하지 않음)",
        r,
        c,
        why,
        *near,
    )
    r, c = near
    corrected = True
    correct_reason = why
La siguiente entrada es "2. La regla renju hizo invencibles a las blancas".
COMMENTS · CHAPTER 01
Una IA de gomoku que pierde contra las personas 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google