Aprender jugando
Abandoné la memorización del orden e hice que el modelo jugara el tablero por sí mismo. Cuando el modelo propone una jugada, el servidor la compara con la solución y, si es incorrecta, un oráculo (código que conoce la solución) juega en su lugar la jugada correcta. Con los registros acumulados de esta forma, el LoRA se siguió entrenando cada 3 partidas.
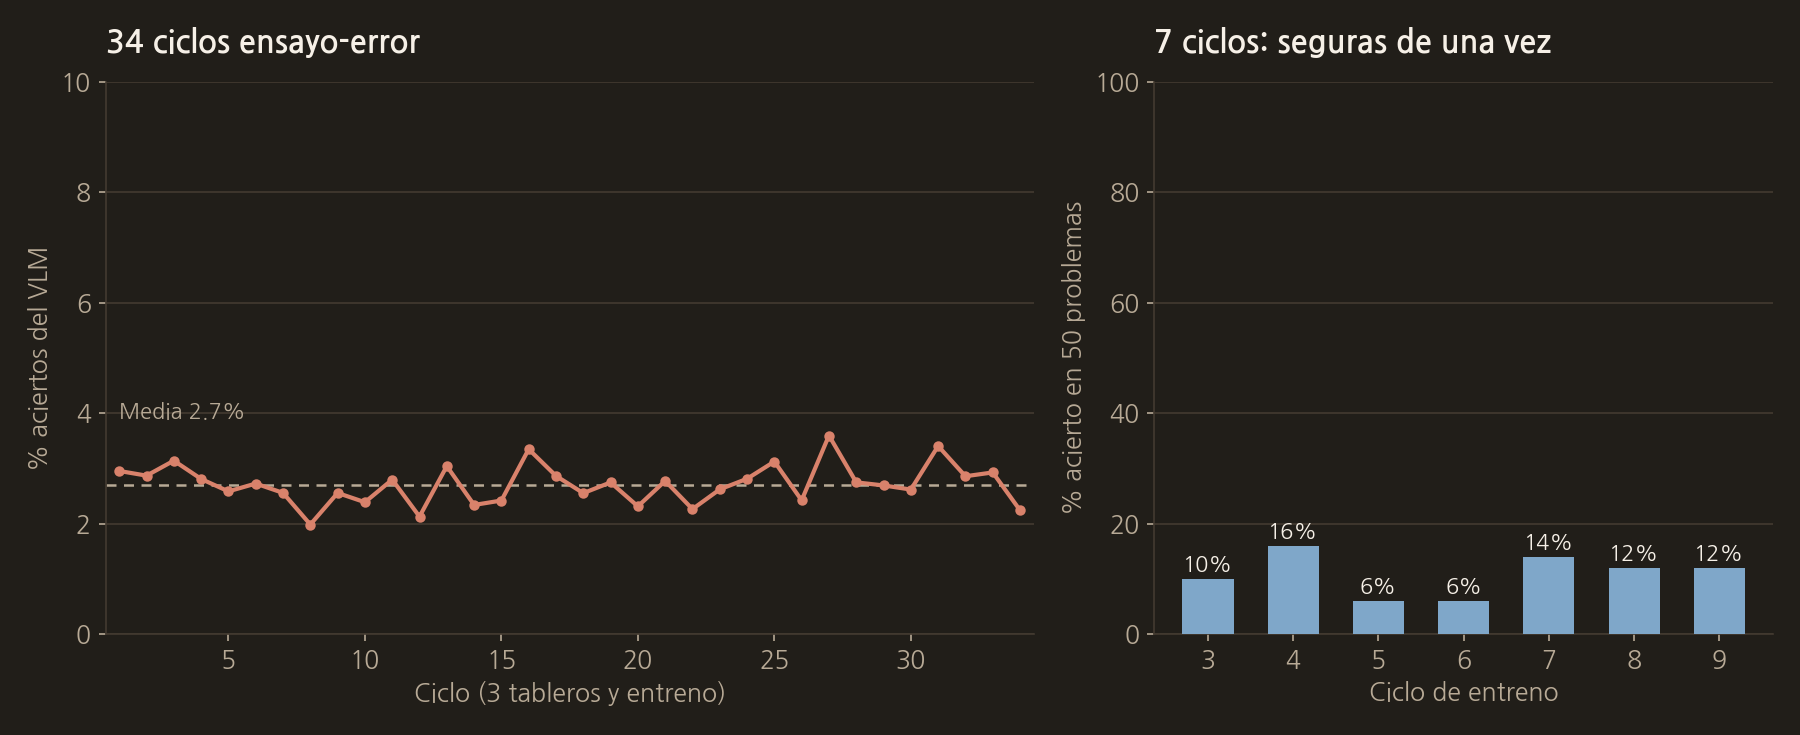
Ejecuté 34 ciclos durante tres días. La proporción de jugadas correctas del modelo fue del 2,0 al 3,6% por ciclo, y en total 1.695 de 62.842 (2,7%). Por mucho que se entrenara, no mejoraba.
Encontrar de una vez una casilla segura
Después hice que el modelo eligiera directamente, en todo el tablero, una casilla 100% segura (lora_cell). Ejecuté 7 ciclos volviendo a añadir los problemas que fallaba, pero su tasa de aciertos en 50 problemas de prueba fue del 6 al 16%. Al hacerle jugar 15 jugadas en tableros reales, obtuvo entre un 0 y un 33%.
También probé un currículo que separaba números y casillas y enseñaba primero lo fácil. Acertar el número bajó del 34% al 26%, y acertar la casilla no se movió del 0%.
Lo que enseñó el oráculo
Por esa época escribí aparte en solve.md cómo resuelven el sudoku las personas. En ese documento describí así la razón del fracaso.
El oráculo conoce valores con una probabilidad inferior al 20% y entrena al VLM con esos valores, así que no hay diferencia entre los resultados entrenados, y por eso parece que el VLM no tiene ninguna regularidad sobre por qué exactamente esta respuesta resulta ser así.
El oráculo siempre conoce la respuesta. No le importa si esa casilla se puede deducir del tablero actual. Como había mezcladas respuestas sin fundamento en el tablero, no había ninguna regla que el modelo pudiera aprender. Era el mismo problema que la hoja de soluciones de la entrada 1.
El código real de este paso
Este es un ciclo del bucle que juega 3 partidas y luego entrena. Juega las partidas, extrae datos de entrenamiento de los registros acumulados y continúa el entrenamiento del LoRA.
vlm_play_train_loop.py
results, play_accuracy = run_games(
    session,
    games=args.games_per_cycle,
    difficulty=args.difficulty,
    max_steps=args.max_steps,
    verbose=args.verbose,
    save_images=None,
    game_id_start=state.game_id_next,
    accuracy=play_accuracy,
    human=args.human,
)
state.game_id_next += args.games_per_cycle
print_summary(results, play_accuracy)
print(f"\n사이클 {cycle} 시도정답률(리젝 포함): {play_accuracy.fmt()}")

# ...

total_lines = count_replay_lines(replay_path)
cycle_jsonl = cycle_sft_dir / f"cycle_{cycle:04d}.jsonl"
kept, new_total, by_outcome = export_trainable(
    replay_path,
    cycle_jsonl,
    since_line=state.replay_line_offset,
)

# ...

t0 = time.monotonic()
exit_code = run_training(
    dataset_jsonl=cycle_jsonl,
    base_model=args.base_model,
    adapter_dir=adapter_in,
    output_dir=args.output_dir,
    device=args.device,
    epochs=args.train_epochs,
    batch_size=args.batch_size,
    grad_accum=args.grad_accum,
)
La siguiente entrada es "3. Convertir la forma de resolver de las personas en reglas".
COMMENTS · CHAPTER 02
No pudo aprender por ensayo y error 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google