Material necesario
SGF es un formato de texto que guarda el tamaño del tablero, las jugadas de negras y blancas y el resultado de la partida. Primero se reúnen solo las partidas cuyo origen y condiciones de reutilización se han comprobado. Más importante que el número de archivos es descartar las partidas que no se pueden analizar, los tableros que no son de 19×19 y las partidas con coordenadas de jugada corruptas.
- Comprobar que el tamaño del tablero es 19×19.
- Reproducir desde el principio las jugadas de negras y blancas.
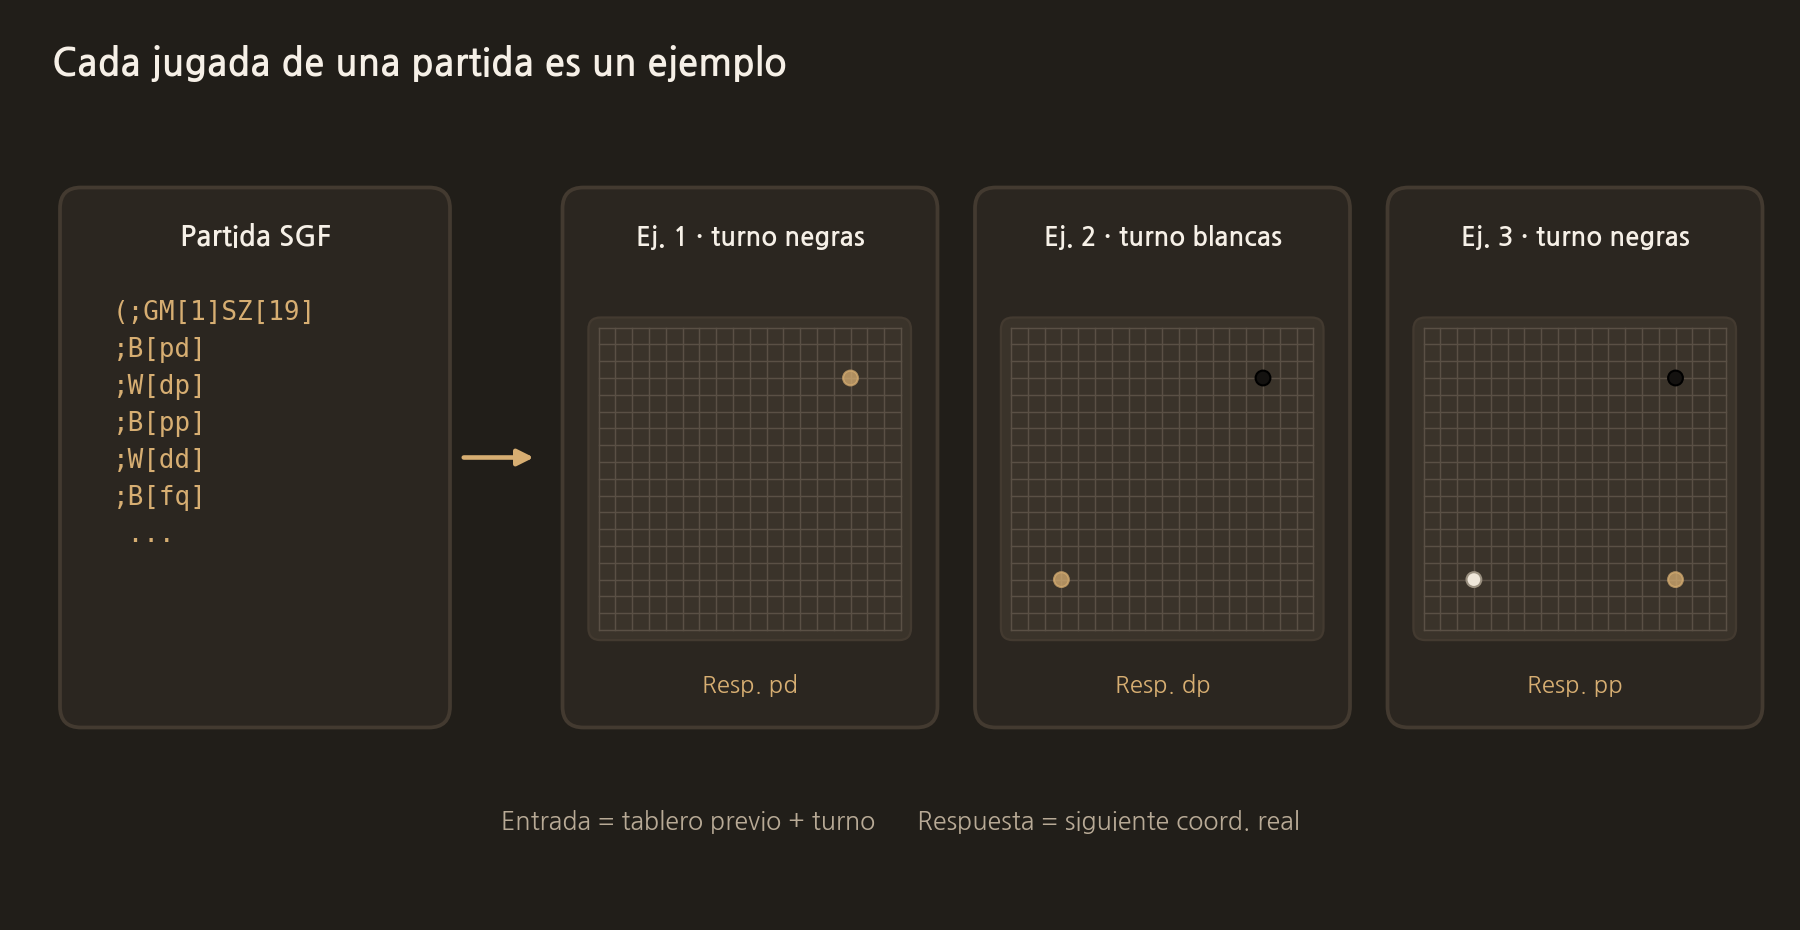
- Guardar como entrada el tablero justo antes de cada jugada.
- Guardar como respuesta la coordenada que realmente se jugó a continuación.
- Conservar también el resultado de la partida y el número de jugada.
Paso 1: Reproducir las jugadas sobre un tablero vacío
Al leer las coordenadas de SGF, las coordenadas en letras del archivo original se convierten una sola vez en filas y columnas internas de 0 a 18. A partir de ahí, el motor de reglas usa únicamente coordenadas numéricas. Se guarda una jugada como dato, luego se coloca esa piedra en el tablero real, se retiran las piedras capturadas y se pasa a la siguiente jugada.
Si se deja activada la comprobación de jugadas legales durante este proceso, los errores de las partidas originales y del analizador aparecen enseguida. Si una partida normal se juzga como suicidio, lo habitual es que esté mal la dirección de las coordenadas, el orden de turnos entre negras y blancas o el orden en que se retiran las piedras.
Paso 2: Dividir una partida en muchos ejemplos de entrenamiento
Una partida de 100 jugadas no es un ejemplo, sino hasta 100 pares de entrada y respuesta. El primer ejemplo es el tablero vacío y la primera jugada de negras; el segundo, el tablero con una piedra negra y la respuesta de blancas. La entrada debe indicar siempre a quién le toca, para poder distinguir qué color juega ante la misma forma del tablero.
Paso 3: Comprobar duplicados y sesgos
Si el mismo tablero se repite en muchos archivos, su peso en el entrenamiento puede crecer demasiado. Se crea un hash con la disposición del tablero, el turno actual y la información de ko para reducir los duplicados. Quedarse solo con las jugadas del ganador es sencillo, pero se pierden todos los patrones de defensa y de error que se podrían aprender de las jugadas del perdedor. En MariaGO damos prioridad a las partidas del ganador, pero las posiciones con atari y capturas se marcan aparte para poder evaluarlas.
Qué resultado comprobar
Elige 20 ejemplos al azar y marca tú mismo la jugada correcta sobre el tablero de entrada. Hay que comprobar a ojo que no estén invertidos izquierda y derecha o arriba y abajo, y que la alineación no se desplace en los números de columna de dos cifras. Una estadística que diga que hay muchos datos nunca revelará errores de conversión de coordenadas.
El código real de este paso
Esta función convierte una sola vez las coordenadas en letras de SGF en filas y columnas de 0 a 18. En 19×19, tt se trata como un pase.
vlm_server/sgf_parser.py
def _decode_point(s: str, size: int) -> Optional[Tuple[int, int]]:
    if not s:
        return None
    s = s.strip().lower()
    if not s:
        return None
    # SGF: 'tt' 는 19x19 에서 패스 관용 표기
    if size == 19 and s == "tt":
        return None
    if len(s) < 2:
        return None
    col = ord(s[0]) - ord("a")
    row = ord(s[1]) - ord("a")
    if not (0 <= col < size and 0 <= row < size):
        return None
    return (row, col)
Esta función divide una partida en ejemplos por jugada de "tablero anterior, turno, coordenada correcta". winning_side_only corresponde a dar prioridad a las jugadas del ganador, y tactical_bias a marcar las posiciones con atari y capturas.
vlm_server/dataset_baduk.py
def iter_training_samples(
    game: SgfGame,
    max_per_game: int,
    rng: random.Random,
    winning_side_only: bool = False,
    winner: Optional[int] = None,
    tactical_bias: bool = False,
    tactics_only: bool = False,
) -> Iterator[Tuple[bytes, int, Optional[Tuple[int, int]], bool]]:
    """게임 1개에서 (board_before_move, ai_side, target_move, is_tactical) 4-tuple yield."""
    if game.size != BOARD_SIZE:
        return
    sim = _GoSim(BOARD_SIZE)
    for r, c in game.setup_black:
        sim.set(r, c, 1)
    for r, c in game.setup_white:
        sim.set(r, c, 2)

    # tactics_only 든 tactical_bias 든 어느 쪽이라도 분류기를 켜야 한다.
    need_tactical_flag = tactical_bias or tactics_only

    states: List[Tuple[bytes, int, Optional[Tuple[int, int]], bool]] = []
    # (snap_before, side, point, is_tactical)
    for color, point in game.moves:
        side = 1 if color == "B" else 2
        if winning_side_only and winner is not None and side != winner:
            if point is not None:
                sim.play(point[0], point[1], side)
            continue
        snap = sim.packed()
        is_tac = _is_tactical_move(sim, side, point) if need_tactical_flag else False
        states.append((snap, side, point, is_tac))
        if point is not None:
            sim.play(point[0], point[1], side)

    if not states:
        return

    if tactics_only:
        # 전술 순간만 yield (max_per_game 무시).
        for snap, side, point, is_tac in states:
            if is_tac:
                yield (snap, side, point, True)
        return

    if max_per_game <= 0 or len(states) <= max_per_game:
        chosen_indices = list(range(len(states)))
    else:
        if tactical_bias:
            # 절반은 전술 순간 우선, 나머지는 균등.
            tactical_idx = [i for i, st in enumerate(states) if st[3]]
            half = max_per_game // 2
            if len(tactical_idx) > half:
                rng.shuffle(tactical_idx)
                tactical_pick = sorted(tactical_idx[:half])
            else:
                tactical_pick = sorted(tactical_idx)
            need = max_per_game - len(tactical_pick)
            # 나머지 균등 샘플 (tactical_pick 와 중복 피함)
            taken = set(tactical_pick)
            uniform: List[int] = []
            if need > 0:
                step = max(1.0, len(states) / need)
                k = 0
                while len(uniform) < need and k < len(states):
                    idx = int(k * step)
                    if idx >= len(states):
                        break
                    if idx not in taken:
                        uniform.append(idx)
                        taken.add(idx)
                    k += 1
            chosen_indices = sorted(set(tactical_pick + uniform))
        else:
            step = len(states) / max_per_game
            chosen_indices = sorted(set(int(i * step) for i in range(max_per_game)))

    for i in chosen_indices:
        snap, side, point, is_tac = states[i]
        yield (snap, side, point, is_tac)
Modelo utilizado: Qwen3-VL-8B-Instruct + adaptador LoRA (lora_mix_qwen_r5). El código fuente completo y la descripción del modelo están en la entrada "8. El código fuente completo y los modelos utilizados".
COMMENTS · CHAPTER 02
Convertir partidas en SGF en datos de entrenamiento 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google