El servidor de VLM
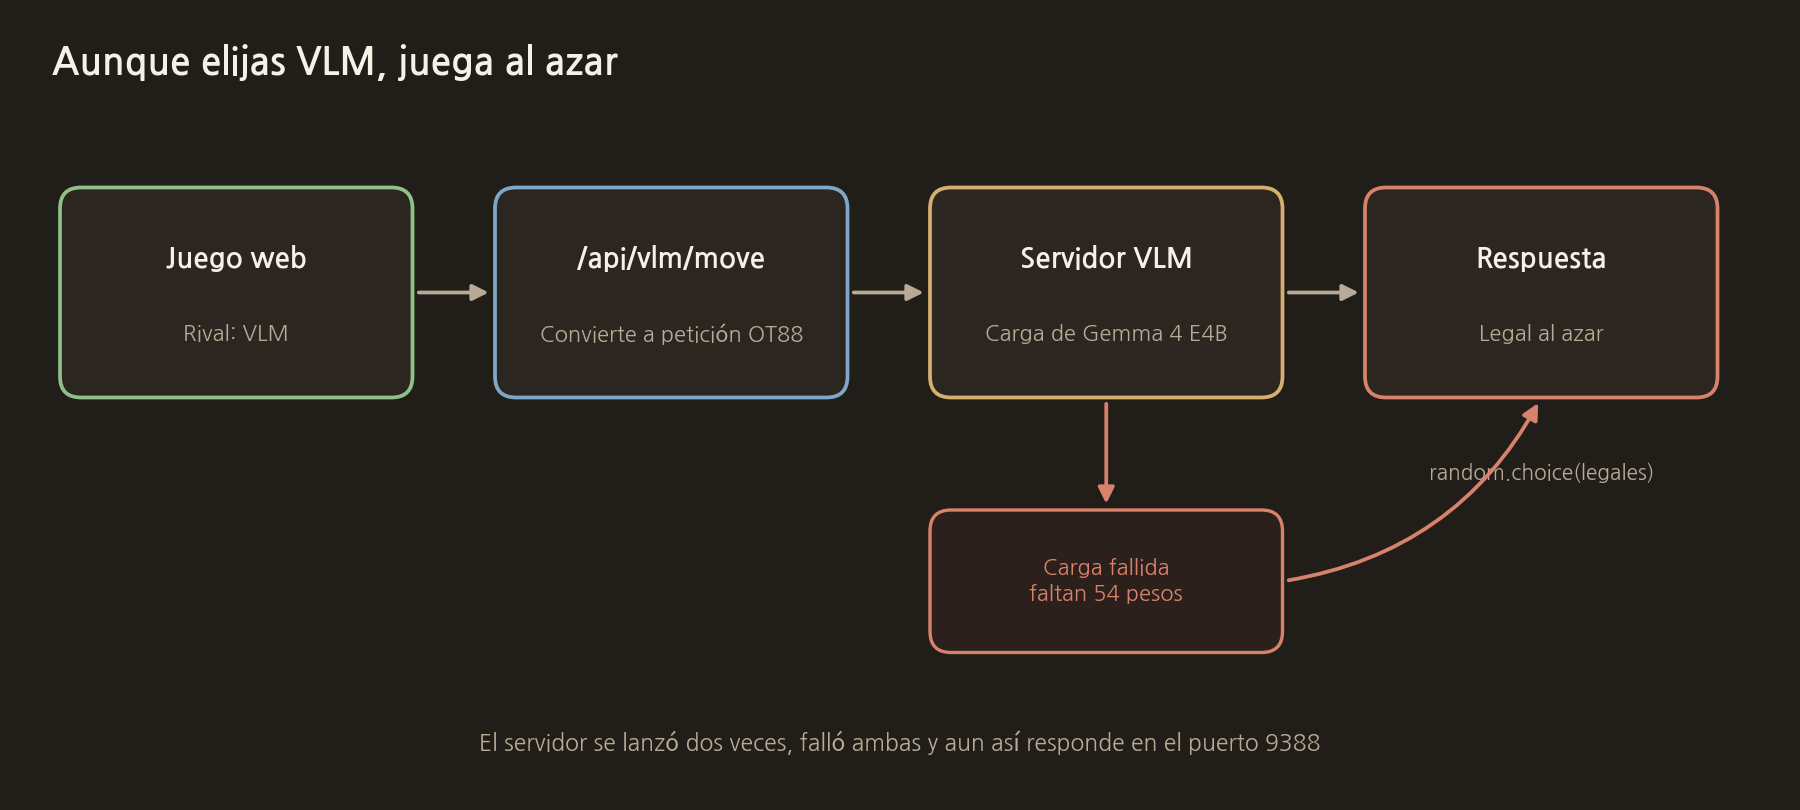
El servidor de VLM carga Gemma 4 E4B (mlx 4bit) con mlx-vlm y le hace elegir una jugada a partir de una imagen del tablero y un texto. Recibe las peticiones de la app de Qt y de la web mediante el protocolo OT88, construido sobre el mismo esquema que el GO19 del go. En el prompt se incluye también la lista de jugadas legales.
Fallo de carga
El registro del servidor muestra dos arranques, y los dos fallaron con el mismo error.
ValueError: Missing 54 parameters
Los pesos que faltan son self_attn k_proj, v_proj y k_norm de las capas 24~41 del modelo de lenguaje. La versión de mlx-vlm instalada es la 0.5.0. Parece que los archivos del modelo no coinciden con la estructura que espera mlx-vlm.
El servidor arranca aunque falle
Si el servidor no puede cargar el modelo, pasa al "modo de jugada legal aleatoria" y abre el puerto igualmente. El script de monitorización solo comprueba si el puerto responde, así que lo considera en buen estado. Al elegir el VLM en la pantalla, se devolvía una jugada legal al azar.
En el registro solo quedan más de 30,000 conexiones y desconexiones, y no hay forma de distinguir qué conexiones eran peticiones reales de partida. Por eso no podemos saber cuántas de las 31 partidas de la entrada 1 fueron contra el VLM.
Caminos hacia una jugada aleatoria
Incluso después de cargar el modelo, hay tres caminos que cambian a una jugada aleatoria.
- Cuando se produce un error durante la inferencia
- Cuando el modelo pasa aunque haya dónde jugar
- Cuando el modelo elige una casilla donde no se puede jugar o una coordenada prohibida
La pantalla web vuelve a cambiar a la IA local si la respuesta del VLM es una casilla donde no se puede jugar. La IA local publicada ahora es la IA de una jugada de la entrada 2. En cualquier caso, la pantalla lo muestra como una jugada del VLM. En el go decidimos no sustituir nunca en secreto la jugada por una arbitraria, pero el Othello está construido al revés.
El código real de esta etapa
Esta es la parte que vacía model y mantiene el servidor en marcha cuando falla la carga del modelo.
vlm_server/server.py
model: Optional[_MlxVlmModel] = None
if load_model:
    model = _MlxVlmModel(model_id, max_new_tokens=max_new_tokens, temperature=temperature)
    try:
        model.start(wait_load=True)
    except BaseException as e:
        LOGGER.exception("모델 로드 실패 → 무작위 합법수 모드: %s", e)
        model = None
Esta es la parte que recibe una petición y decide la jugada. Si no hay modelo o la respuesta no es una jugada legal, elige al azar.
vlm_server/server.py
model = self.server.model
row = col = None
is_pass = False
if model is not None:
    try:
        row, col, is_pass = model.predict_move(
            img, board, ai_side, legal, forbidden=list(bans), timeout_s=180.0
        )
    except Exception as e:
        LOGGER.warning("VLM 추론 실패, 합법수 무작위: %s", e)
        row = col = None
        is_pass = False

if is_pass:
    LOGGER.info("모델 PASS (합법수 있음) → 합법수 무작위")
    row = col = None

if row is None or col is None or (row, col) not in legal or (row, col) in bans:
    if row is not None and col is not None:
        LOGGER.info("불법/금지 (%s,%s) → 합법수 무작위", row, col)
    pick = _choose_legal(legal, bans)
    if pick is None:
        _send_pass(sock)
        continue
    row, col = pick

# ...

def _choose_legal(
    legal: list[tuple[int, int]], forbidden: set[tuple[int, int]]
) -> Optional[tuple[int, int]]:
    remain = [m for m in legal if m not in forbidden]
    pool = remain or legal
    if not pool:
        return None
    return random.choice(pool)
La siguiente entrada es "4. Un plan para llevar a Othello lo aprendido en el go y el gomoku".
COMMENTS · CHAPTER 03
El VLM nunca jugó: Gemma 4 no se pudo cargar 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google