Método
llm_macro_client.py es un cliente que se conecta a la pantalla de Qt.
- En el tablero recibido, borra la pieza en movimiento para que solo queden los bloques fijados.
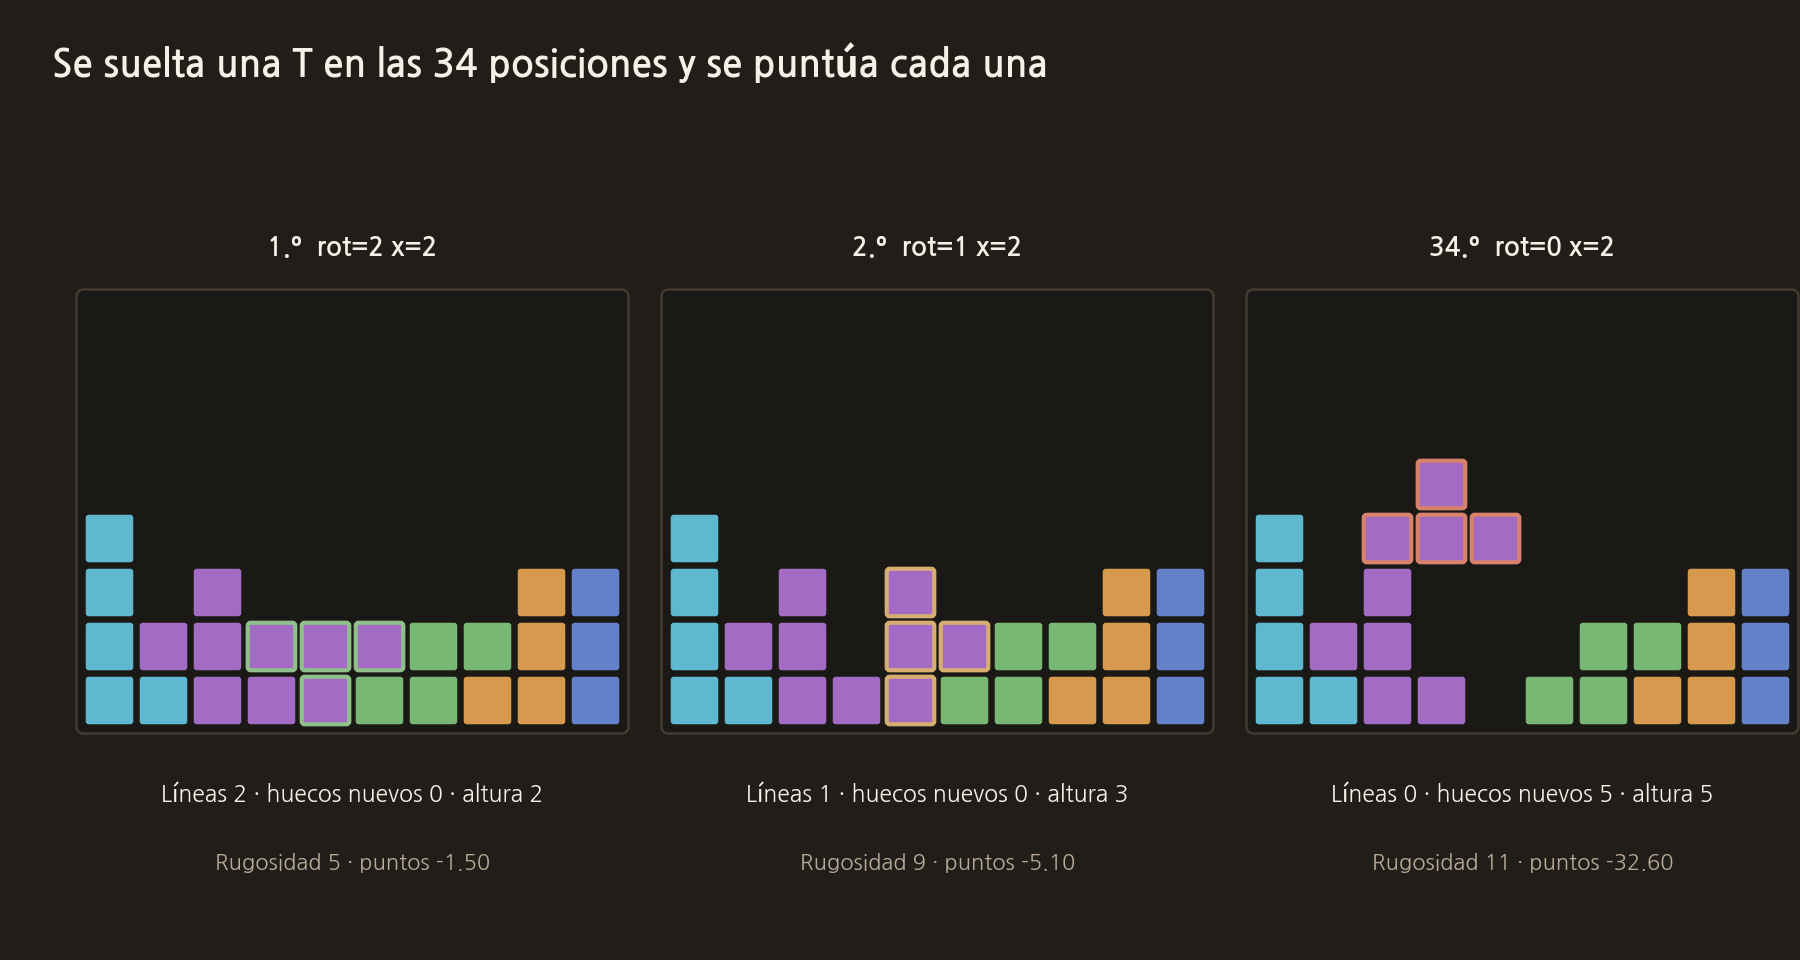
- Prueba a dejar caer la pieza actual con cada giro y en cada x. Para una pieza T son 34 sitios. También se incluyen los sitios con x negativa.
- Para cada sitio calcula las líneas borradas, los huecos nuevos, las casillas apiladas sobre huecos, la irregularidad, la altura máxima, la altura de aterrizaje y los pozos, y le asigna una puntuación.
- Coloca una vez más la pieza siguiente, suma 0.7 veces su mejor puntuación y vuelve a ordenar.
- Muestra los 6 mejores al LLM (Qwen2.5-3B GGUF) junto con un tablero en texto y le hace elegir solo un número. El LLM no puede inventarse coordenadas.
- Ajusta el giro y el desplazamiento al sitio elegido y deja caer la pieza de golpe.
Con --no-llm, usa la primera opción sin el LLM.
Solo con la heurística
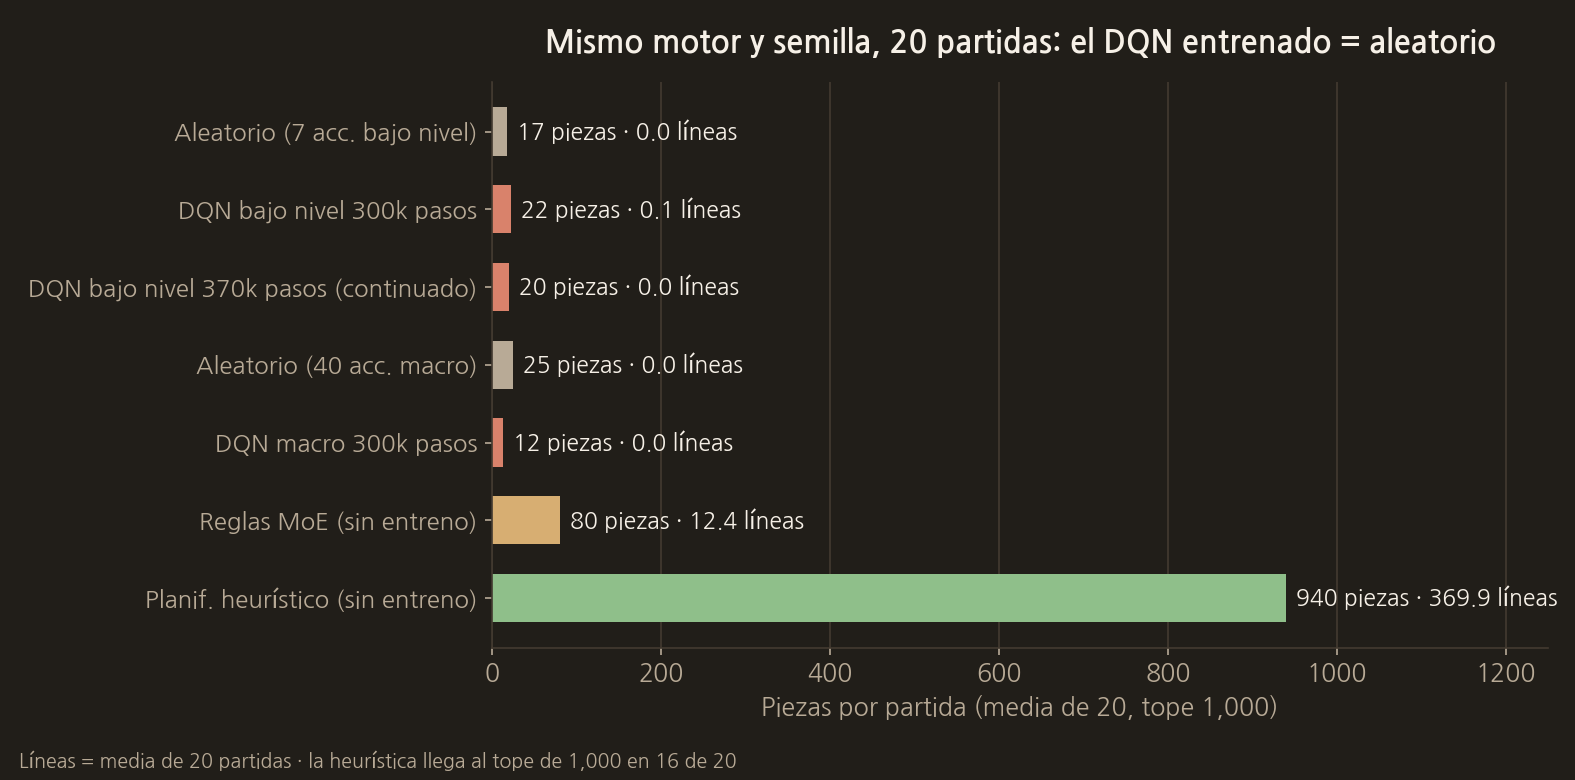
La API en C no proporciona la pieza siguiente, así que en esta prueba se omitió el paso 4 (mirar una pieza más) y se usó solo la primera opción. Son 20 partidas con las mismas semillas, detenidas en 1,000 piezas.
- 940 piezas y 370 líneas de media
- 16 de las 20 partidas sobrevivieron hasta las 1,000 piezas. Las otras 4 terminaron en 375, 736, 811 y 863 piezas.
- De las 16 partidas que llegaron a 1,000, 12 terminaron con una altura del tablero de 6 casillas o menos.
Sin entrenamiento y con una sola fórmula de puntuación, supera con creces al DQN (0 líneas) y al MoE (12 líneas).
Cuando elige el LLM
Con el LLM conectado, jugamos 1 partida con la semilla 0 hasta las 150 piezas. La dejamos corta porque la GPU se comparte con el entrenamiento del gomoku.
- Eligió la primera opción 147 de 150 veces (98%). La segunda opción, 2 veces, y la tercera, 1.
- Terminó con 55 líneas, 0 huecos y una altura de 7 casillas. Usando solo la primera opción de la heurística en las mismas condiciones salen 58 líneas.
- Cada elección tardó 1.7 segundos de media. Solo con la heurística se juegan 20 partidas, más de 18,000 piezas, en 14 segundos.
El prompt dice "si [0] cumple las condiciones, elige 0", y los candidatos ya están ordenados por puntuación, así que el LLM casi siempre sigue a la heurística. Con la estructura actual, el LLM no mejora el tablero; solo lo hace todo más lento.
Resumen
- DQN de bajo nivel: casi nunca ve una recompensa por línea, así que equivale al juego al azar.
- DQN de macroacciones: la representación de las acciones bloqueó la columna de más a la izquierda, y repite solo dos sitios del centro.
- Recompensas del VLM y elección directa del VLM: no distinguen los tableros y apilan en el centro.
- Cálculo de candidatos y puntuación: supera las 1,000 piezas sin entrenamiento. El LLM apenas se limita a confirmar la primera opción.
Lo siguiente que pienso hacer es cambiar las macroacciones a los 162 sitios donde realmente se pueden colocar las piezas y volver a entrenar el DQN usando como ejemplo los tableros jugados por el planificador heurístico.
El código real de esta etapa
Esta es la puntuación de un solo sitio.
llm_macro_client.py
on_hole_w = 3.0 * max(0.2, 1.0 - max_h_global / 16.0)

score = (
    + 1.0 * cleared
    - 4.0 * new_holes
    - on_hole_w * cells_above_hole
    - 0.36 * holes_after
    - 1.00 * max_h            # 0.5 → 1.0 (높이 누적 강하게 회피)
    - 0.30 * bump_eff         # 0.18 → 0.30 (양쪽 우물 패턴 회피)
    - 0.70 * landing_height   # 0.5 → 0.7 (깊게 박기 우선)
    - 0.40 * other_well_sum
    + 0.30 * well_bonus       # 0.5 → 0.3 (테트리스 욕심을 줄임)
)
Prueba a dejar caer la pieza actual en todos los sitios posibles.
llm_macro_client.py
def enumerate_candidates(board: np.ndarray, ptype: int) -> list[dict]:
    if ptype == 0:
        return []
    heights_before = column_heights(board)
    hole_cols_before = column_hole_count(board, heights_before)
    holes_before = sum(hole_cols_before)

    nrot = _PIECE_NROT[ptype]
    w = board.shape[1]
    cands = []
    for rot in range(nrot):
        cells = PIECE_CELLS[ptype][rot]
        min_dx = min(dx for dx, _ in cells)
        max_dx = max(dx for dx, _ in cells)
        x_lo = -min_dx
        x_hi = w - 1 - max_dx
        for x in range(x_lo, x_hi + 1):
            r = evaluate_placement(
                board,
                ptype,
                rot,
                x,
                heights_before=heights_before,
                hole_cols_before=hole_cols_before,
                holes_before=holes_before,
            )
            if r is not None:
                cands.append(r)
    cands.sort(key=lambda r: r["score"], reverse=True)
    return cands
Estas son las reglas de selección que se le dan al LLM.
llm_macro_client.py
"Selection priorities (STRICT, in order):\n"
"  1) on_hole == 0  (NEVER stack on a column that already contains buried holes)\n"
"  2) new_holes == 0 (do not create new holes)\n"
"  3) cleared >= 1 (clear lines if possible)\n"
"  4) higher 'look' (1-step lookahead) wins ties\n"
"  5) lower max_h, then lower bump, then lower land_h.\n"
"If [0] already satisfies (1)+(2), just pick 0.\n"
f'Reply EXACTLY as: {{"choice": <integer 0..{len(candidates) - 1}>}}'
La siguiente entrada es "6. El código fuente completo y los modelos utilizados".
COMMENTS · CHAPTER 05
El código calcula los lugares y el LLM solo elige 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google