Configuración del entrenamiento
- Algoritmo: DQN de stable-baselines3. Tasa de aprendizaje 1e-4, búfer de repetición de 100,000, lote de 32, entrenamiento cada 4 pasos y red objetivo actualizada cada 10,000 pasos.
- Exploración: durante el primer 20%, la proporción aleatoria baja de 1 a 0.02.
- Red de política: como los valores de la observación son 0~7, SB3 no los trata como una imagen y elige MlpPolicy. Las 220 casillas del tablero se aplanan en una sola fila.
Recompensa
Se calcula cada vez que una pieza se fija.
- Al borrar líneas: 1 línea 1 punto, 2 líneas 3, 3 líneas 10, 4 líneas 30
- Un poco más cuanto más abajo se coloque (altura de aterrizaje×0.1)
- -5 por cada hueco nuevo
- -2 por cada fila que sube la altura del tablero
- Se restan la irregularidad (suma de las diferencias de altura entre columnas vecinas)×0.02 y la altura del tablero×0.03
Resultados
Quedan dos modelos de bajo nivel: el modelo de 300,000 pasos (live_latest.zip.bak) y el modelo de 370,000 pasos entrenado a partir de él (live_latest.zip). El entrenamiento continuado empezó con el objetivo de 620,000 pasos, pero se detuvo en 370,000.
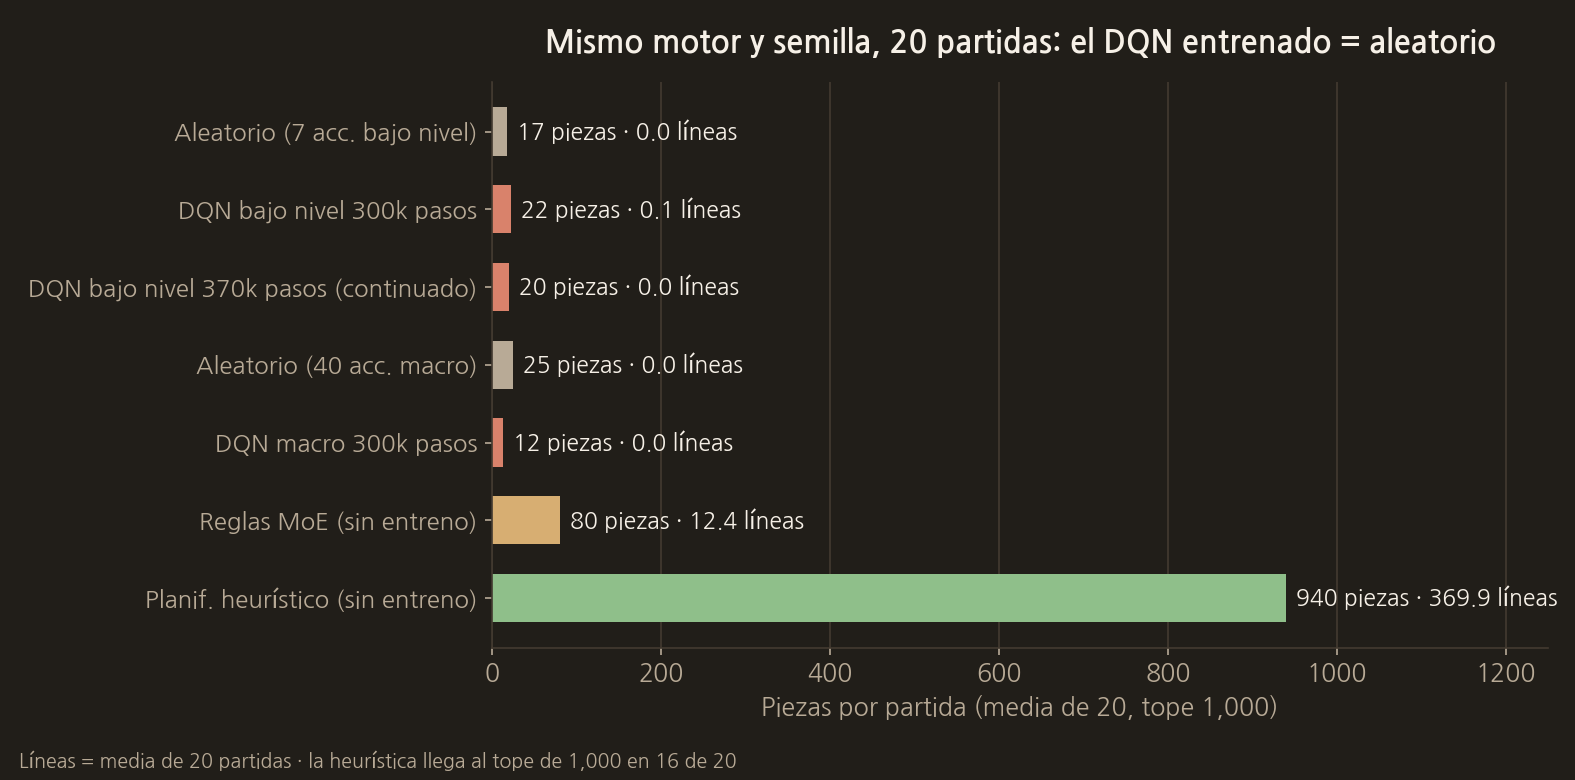
En el mismo motor jugamos 20 partidas con las semillas 0~19. El modelo eligió siempre la acción de mayor valor.
- 7 acciones al azar: 17 piezas de media, 0 líneas
- DQN de 300,000 pasos: 22 piezas de media, 2 líneas en total en 20 partidas
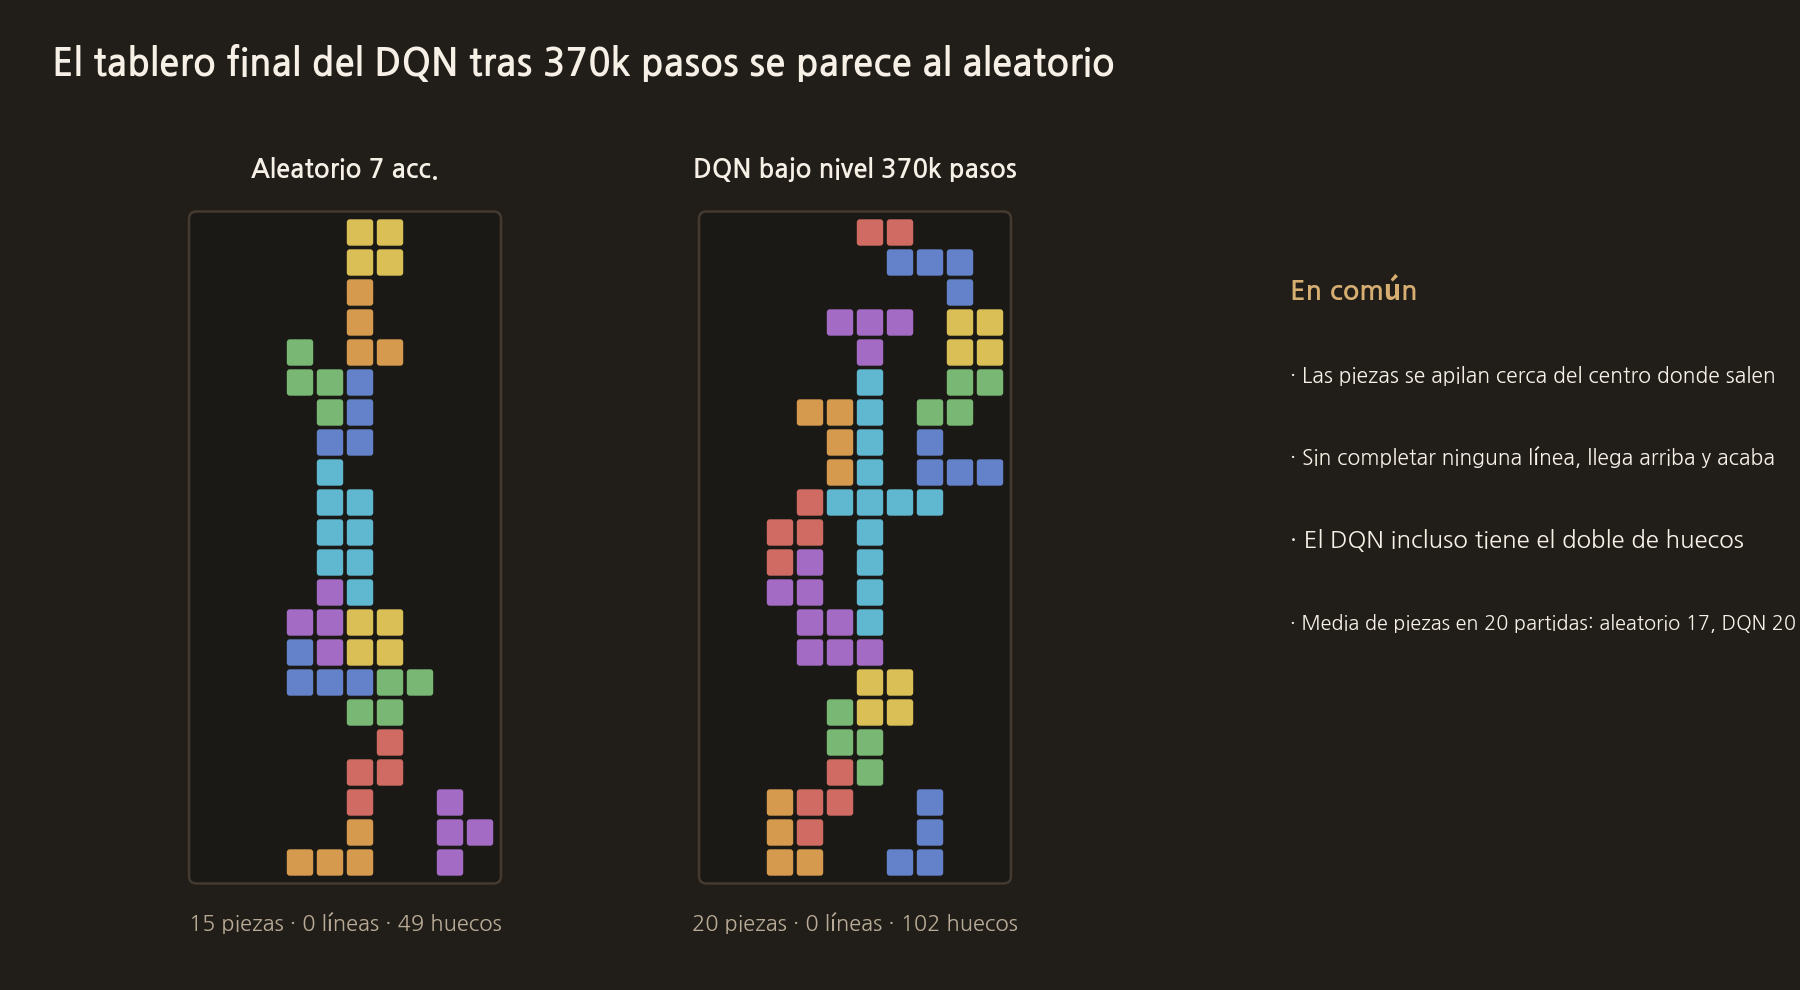
- DQN de 370,000 pasos: 20 piezas de media, 0 líneas
Por qué no aprendió
- Casi nunca ve una recompensa por línea. Pulsando al azar no se borra ni una línea en 20 partidas. Para borrar una línea hay que encajar varias piezas, y eso rara vez ocurre durante la exploración. Las señales que llegan al entrenamiento son casi solo las penalizaciones por huecos y por altura.
- Una pieza requiere más de 20 acciones. Si el sitio era bueno solo se sabe en el momento en que la pieza se fija, así que es difícil saber cuál de los movimientos y giros anteriores fue acertado.
- Un MLP pequeño mira los 220 números del tablero aplanado. Le cuesta leer la forma de las piezas y sus relaciones de posición, y tampoco conoce la pieza siguiente.
Por eso redujimos las acciones a una por pieza e hicimos que un VLM ayudara con la recompensa.
El código real de esta etapa
Esta es la recompensa que calcula el motor cuando una pieza se fija.
tetris/src/tetris_engine.cpp
// Line clear reward (non-linear scaling)
double line_r = 0.0;
switch (cleared) {
    case 1: line_r = cfg_.line_reward_1; break;
    case 2: line_r = cfg_.line_reward_2; break;
    case 3: line_r = cfg_.line_reward_3; break;
    case 4: line_r = cfg_.line_reward_4; break;
    default: break;
}

// Height reward: lower placement = higher reward
double height_r = cfg_.height_reward_scale * landing_y;

const int holes_after = count_holes();
const int new_holes = holes_after - holes_before;
double hole_penalty = 0.0;
if (new_holes > 0) {
    hole_penalty = cfg_.hole_penalty_scale * static_cast<double>(new_holes);
}

// Stack height penalty: penalize increases of the board height (after line clears)
double height_penalty = 0.0;
if (cfg_.stack_height_penalty_scale > 0.0) {
    const int height_after = stack_height();
    const int dh = height_after - height_before;
    if (dh > 0) {
        height_penalty = cfg_.stack_height_penalty_scale * static_cast<double>(dh);
    }
}

// Surface shaping penalties (post line-clear)
double bump_penalty = 0.0;
if (cfg_.bumpiness_penalty_scale > 0.0) {
    bump_penalty = cfg_.bumpiness_penalty_scale * static_cast<double>(bumpiness());
}
double max_height_penalty = 0.0;
if (cfg_.max_height_penalty_scale > 0.0) {
    max_height_penalty = cfg_.max_height_penalty_scale * static_cast<double>(stack_height());
}

last_reward_ += line_r + height_r - hole_penalty - height_penalty - bump_penalty - max_height_penalty;
Estos son los tamaños de las recompensas y la configuración del DQN.
config/rl_config.py
    # ── 보상/패널티 스케일 (C++ 엔진으로 전달) ───────────────────────────────
    # 한쪽으로 몰빵되는 탑쌓기를 억제하려면 아래 2개를 켜는 게 효과적
    stack_height_penalty_scale: float = 2.0   # 스택 높이 "증가분" 패널티 (권장 0.5~5.0)
    # bumpiness는 값 범위가 커서(최대 수백) 스케일을 너무 크게 주면 보상이 붕괴합니다.
    bumpiness_penalty_scale: float = 0.02     # 인접 열 높이 차이 합 패널티 (권장 0.005~0.05)
    max_height_penalty_scale: float = 0.03    # 절대 스택 높이 패널티 (권장 0.0~0.1)


@dataclass(frozen=True)
class DQNConfig:
    timesteps: int = 300_000
    learning_rate: float = 1e-4
    buffer_size: int = 100_000
    batch_size: int = 32
    train_freq: int = 4
    target_update_interval: int = 10_000
    exploration_fraction: float = 0.2
    exploration_final_eps: float = 0.02
La siguiente entrada es "3. Macroacciones elegidas una vez por pieza y recompensas del VLM".
COMMENTS · CHAPTER 02
DQN durante 370,000 pasos y 0 líneas borradas 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google