Lo que aprende ahora el VLM
El entrenamiento automático reúne solo las jugadas del lado ganador y hace que el VLM las imite. Pero en las partidas de entrenamiento blancas (el VLM) ganaron el 94%, y en los registros las jugadas de blancas quedaron también como si las hubiera hecho la IA local. Por eso, de los 12.080 ejemplos, 10.513 eran jugadas de blancas, es decir, jugadas que había hecho el propio VLM. Como vimos en la entrada 1, incluso ese entrenamiento se rompió con una pérdida NaN.
La pregunta que se le hace al VLM tampoco contiene las reglas del gomoku. Se le muestra el tablero y se le pide que responda solo con los dos números de la coordenada de una casilla vacía. Palabras como tres, cuatro o jugada prohibida no aparecen ni una vez.
Lo que aprendimos del go y del puzzle de fichas
En el go, mientras corregía la heurística y la hacía jugar contra R5, la heurística acabó enseñando a R5. En el puzzle de fichas, al introducir en la heurística las reglas con las que resuelven las personas, resolvió los 4.000 tableros en un día. En ambos casos, las reglas sin codicia abrieron el camino antes que el entrenamiento que persigue la recompensa futura.
Pienso probar el mismo método con el gomoku. Es un plan que todavía no he puesto en práctica.
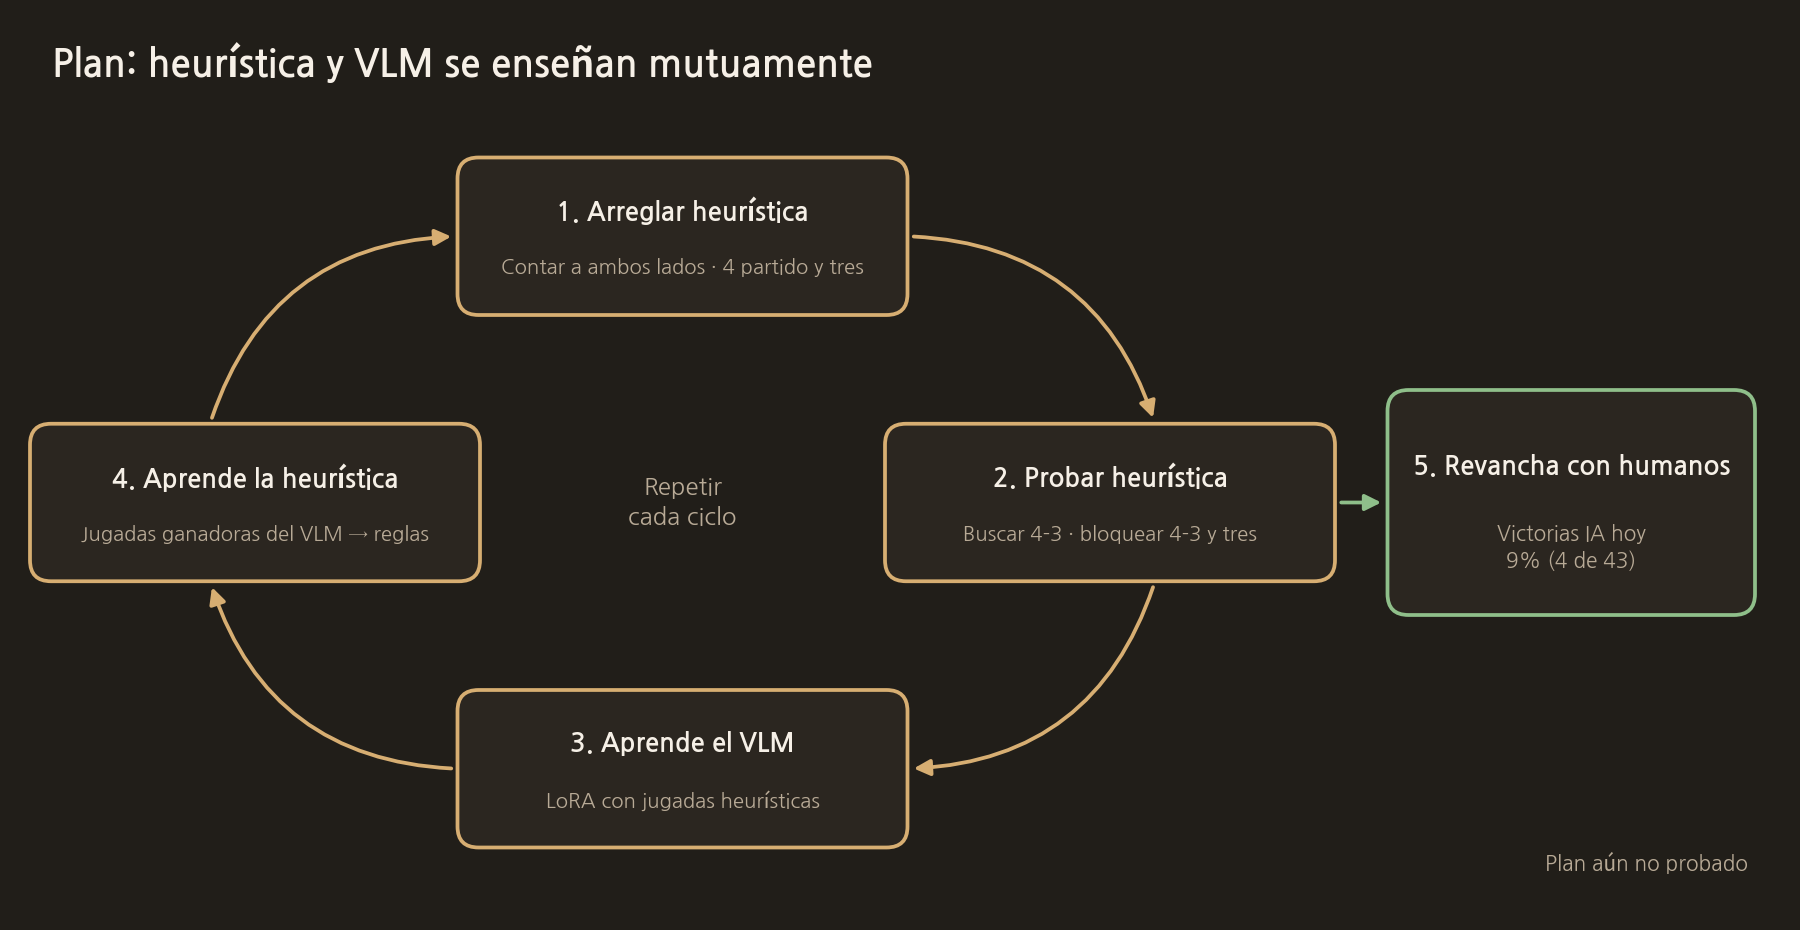
El plan
- Corregir la heurística: contar cada línea en ambas direcciones y contar el cuatro partido (○_○○○) y el tres partido como la misma forma. Que busque primero sus propias posiciones de cuatro-tres y que bloquee antes las posiciones donde el rival podría formar un cuatro-tres o un cuatro abierto en la siguiente jugada.
- Probar la heurística: volver a ejecutar cada vez las pruebas de la entrada 3 (encontrar mi cuatro-tres, bloquear la posición de cuatro-tres del rival, bloquear el tres), y revisar de nuevo si las reglas favorecen a un lado con partidas en las que la misma IA alterne entre negras y blancas.
- Que el VLM aprenda la heurística: volver a entrenar el LoRA con las jugadas de la heurística corregida como respuesta correcta. Incluir en la pregunta las jugadas prohibidas y las formas de amenaza, y empezar por arreglar la configuración de entrenamiento rota (MPS fp16).
- Que la heurística vuelva a ser la profesora: reunir las jugadas en las que el VLM jugó distinto de la heurística y ganó, y trasladar esas formas de nuevo a las reglas de la heurística. Es la forma en que R5 y la heurística aprendieron uno del otro en el go.
- Volver a jugar contra personas: juzgarlo por cuánto sube la tasa de victorias de la IA contra personas desde el 9% actual (4 de 43 partidas).
El código real de este paso
Esta es la pregunta que se envía ahora al VLM. Solo pide la coordenada de una casilla vacía y no contiene las reglas del gomoku.
vlm_pva_server.py
base_prompt = (
    f"{turn_line}\n"
    f"{board_txt}\n"
    f"Choose your next {you_label} move on an EMPTY cell (a '.' in the TEXT board)."
    f"{opening_rule} "
    "Trust the TEXT board coordinates over the image. "
    "Reply with EXACTLY two integers separated by a single space: \"row col\". "
    f"row and col are both in 0..{last_idx}. No other text."
)
La siguiente entrada es "5. El código fuente completo y los modelos utilizados".
COMMENTS · CHAPTER 04
Un plan para que el VLM aprenda la heurística y la heurística vuelva a ser la profesora 0 comentarios
Todavía no hay comentarios. Deja una pregunta o algo que quieras añadir.
Para publicar un comentario, empieza con Google y registra un apodo y un correo.
Empezar con Google